资讯
展览资讯 大型展会 灯光节 大型盛典 赛事 中标捷报 产品快讯 热门话题 艺术节 活动 演出 新闻 数艺报道 俱乐部签约
观点
大咖专访 观点洞察 书籍推荐 吐槽 设计观点 企业访谈 问答 趋势创新 论文 职场方法 薪资报价 数艺专访
幕后
幕后故事 团队访谈 经验分享 解密 评测 数艺访谈
干货
设计方案 策划方案 素材资源 教程 文案资源 PPT下载 入门宝典 作品合集 产品手册 电子书 项目对接
  • 0
  • 0
  • 0

分享

美国抄中国算借鉴?中国团队「CVPR剽窃案」控诉无果,IBM被判无罪

原创 2022-08-19


  新智元报道  

编辑:好困 Aeneas
【新智元导读】此前,IBM被指巧妙地「借鉴」了中国团队研究成果的CVPR中稿论文,近日,IEEE定案——不构成抄袭。

窃idea不算偷?好家伙,真是从未见过如此厚颜无耻之人。
今年6月,曝出了一个大瓜:来自中国的研究团队发现,自己去年参加ICDAR竞赛的idea,竟然被IBM重新包装了一番,拿去投中了今年的CVPR。

随后,中国团队列出详实证据,举报IBM苏黎世研究院抄袭。接着,IBM发文坚称自己就是没抄。
近日,IEEE驳回了抄袭指控,判IBM「无罪」。

来龙去脉


时间回到2021年4月,中国的研究团队参加了IBM承办的ICDAR竞赛,取得了第二名。
划重点:IBM承办。
中国团队的这篇论文,在2021年6月被上传至arXiv,代码也一并进行了开源。

论文地址:https://arxiv.org/abs/2105.01848

而2022年3月2日,IBM苏黎世研究院就发布了TableFormer,论文投中了CVPR 2022。

论文地址:https://arxiv.org/abs/2203.01017

起初,中国团队的Xianbiao Qi还不知道自己团队的idea被剽窃了,是多名学者看了IBM的论文后,觉得IBM的论文与Qi团队的研究有太多相似之处,纷纷来告诉他,他才知道。

(详情可点击阅读:「CVPR再度上演抄袭大戏!IBM中稿论文被指照搬自己承办竞赛第二名的idea」)

Qi向CVPR怒写举报信,和IBM在线battle。
而就在8月2日,事情有了最新的进展。IBM表示,经内部审查后,IEEE驳回了有关抄袭的指控。


对此,一位业内人士解释称:「IEEE基本上不会处理这些在文字上没有明显抄袭的案件。一方面,IEEE的编辑、秘书不是技术专家, 他们在审核的时候也只是看看文字抄没抄。另一方面,在这次的事件中,IEEE也没有邀请外部专家进行审查。」


「所以,只要抄袭者自己不认,而且没留下什么证据(不抄图,不抄字)。出版社是不会处理的。」


附注:(双方的研究成果)
中国团队——TableMaster
IBM团队——TableFormer

双方相继发文回应


回到「抄袭案」本身,在团队的一波举证之后,很快就在Reddit上发酵了起来。


几天后,来自IBM苏黎世研究院的作者,于6月30日发表了一篇回应文章,题为「对有关TableFormer论文指责的回应」。

文章称,IBM的研究人员从未剽窃过任何人的工作。这些指责是没有根据的,只要简单地比较一下这两篇论文就可以轻松驳斥。

文章地址:https://research.ibm.com/blog/tableformer-response

随后,中国团队也在7月4日对IBM的回应文章,进行了回应。

文章地址:https://github.com/JiaquanYe/TableMASTER-mmocr/blob/master/Reply2IBMZurich.pdf

接下来,我们就来具体看一看双方的对阵陈词。

不过在此之前,我们先介绍一下牛津大学关于「剽窃」(Plagiarism)的标准定义:

在没有充分承认的情况下将他人的作品或想法复制或转述到自己的作品中。所有已发表和未发表的材料,无论是手稿、印刷品还是电子形式,都属于这一定义的范围。「共谋」(Collusion)是另一种形式的剽窃,涉及学生或其他个人在作品中未经授权的合作。

(内容有删减,建议感兴趣的读者查阅原文,以及两篇相关的论文。)

1 我们没有抄袭idea


  • 我们在2019年就提出了「双解码器」的方法,而TableMaster的工作在2021年才发表。

  • EDD4的公共代码包含了边界框回归的想法,这比TableMaster的代码库和论文要早。在定量分析部分,被称为「EDD+BBox」。

  • TableFormer的网络架构与TableMASTER-mmocr并不一样。TableMASTER-mmocr使用的是双Transformer解码器,以及文本线检测(基于PSENET)。但TableFormer使用的是单一的Transformer解码器,其输出结果首先用于注意力网络,然后与DETR头一起预测边界框。

TableMaster团队回应:原理一样,且参考文献里压根没提的方法,怎么实现的?


首先,我们并没有说双解码器的方法是我们最先引入的。

其次,我们的关键创新之一,是将表结构识别制定为联合边界框回归和token分类问题。而奇怪的是,TableFormer也使用了完全相同的方法。

您所谓的EDD,仅仅使用了一个单阶段(one-stage)的方法来直接估计表格(包括结构和内容),因此,当表变得复杂时,就必定会遇到问题。此外,在EDD论文中,也找不到任何与「边界框回归」、「回归」、「ℓ1损失」、「ℓ2损失」的相关术语。

事实上,在EDD的代码链接中,定义的只是一个无效的函数,并且该代码没有用于任何损失计算、训练和推理。该代码在默认情况下是禁用的。

IBM声称自己的方法是由DETR起发的。而DETR的两个关键创新是:a) 引入了一组可学习的查询;b) 引入了一个基于集合的全局损失。我们想知道:您到底用了哪一个?

说实话,TableMaster和TableFormerdou都是基于Transformer的,而不是DETR。

2 我们没有抄袭模型


  • 我们使用原始PDF的内容。

  • 我们没有用到TableFormer的「文本行检测」或「文本行识别」。事实上,我们根本不需要这个步骤,因为我们没有用到任何OCR。

  • 我们用的是同事开发的原始PDF,来创建PubTabNet数据集。

  • 我们用的是同事在2018年发表的方法,来从PDF中提取内容。

TableMaster团队回应:别人是看图像,自己直接读原始数据,您识别了个寂寞?


标准的管线是检测文本行并识别文本行的内容。

IBM声称可以通过一个PDF分析器来提取文本行的基准真相。那么,表格识别的意义是什么?

此外,IBM提供给公众的数据是「.PNG」图像,然后IBM又称自己用的是一个PDF解析器直接从数字PDF文件(合成的)中提取基准真相的内容。对你们来说,学术研究的公平性又是什么?

3 我们没有抄袭可视化实现


  • 使用边界框来可视化检测是计算机视觉中的一项标准技术。

  • 在TableMaster的文章之前的许多论文,都是用边界框来可视化表格中的检测的。其中一个例子就是IBM在2020年所做的工作。

  • 我们的可视化是用Javascript/HTML代码制作的,它具有独特的视觉效果,简化了不同阶段预测的比较过程。

TableMaster团队回应:视觉效果像素级相似,但论文却一眼都没看?


TableFormer的视觉效果与TableMaster的视觉效果非常相似。考虑到TableFormer和我们的TableMaster之间有如此多的共同点或相似点,我们很难相信TableFormer没有参考TableMaster的成果。

4 我们没有抄袭预处理方法


  • 我们的数据准备阶段的一些步骤,是TableMaster的工作中没有的。例如,引入了一个生成缺失边界框的程序。

  • 在论文中,我们详细解释了使用512个token的理由。

  • HTML分类token不是由TableMaster的工作所定义的,而是IBM在EDD在2019年首次描述的。

  • 甚至TableMaster的截图也显示了,两篇的工作的不同,因为我们使用了「未折叠」的token(「」),而他们使用的是「折叠」的token(「」)。
    」, 「

TableMaster团队回应:被自己办的竞赛方案吊打,您这是重新发明了SOTA?
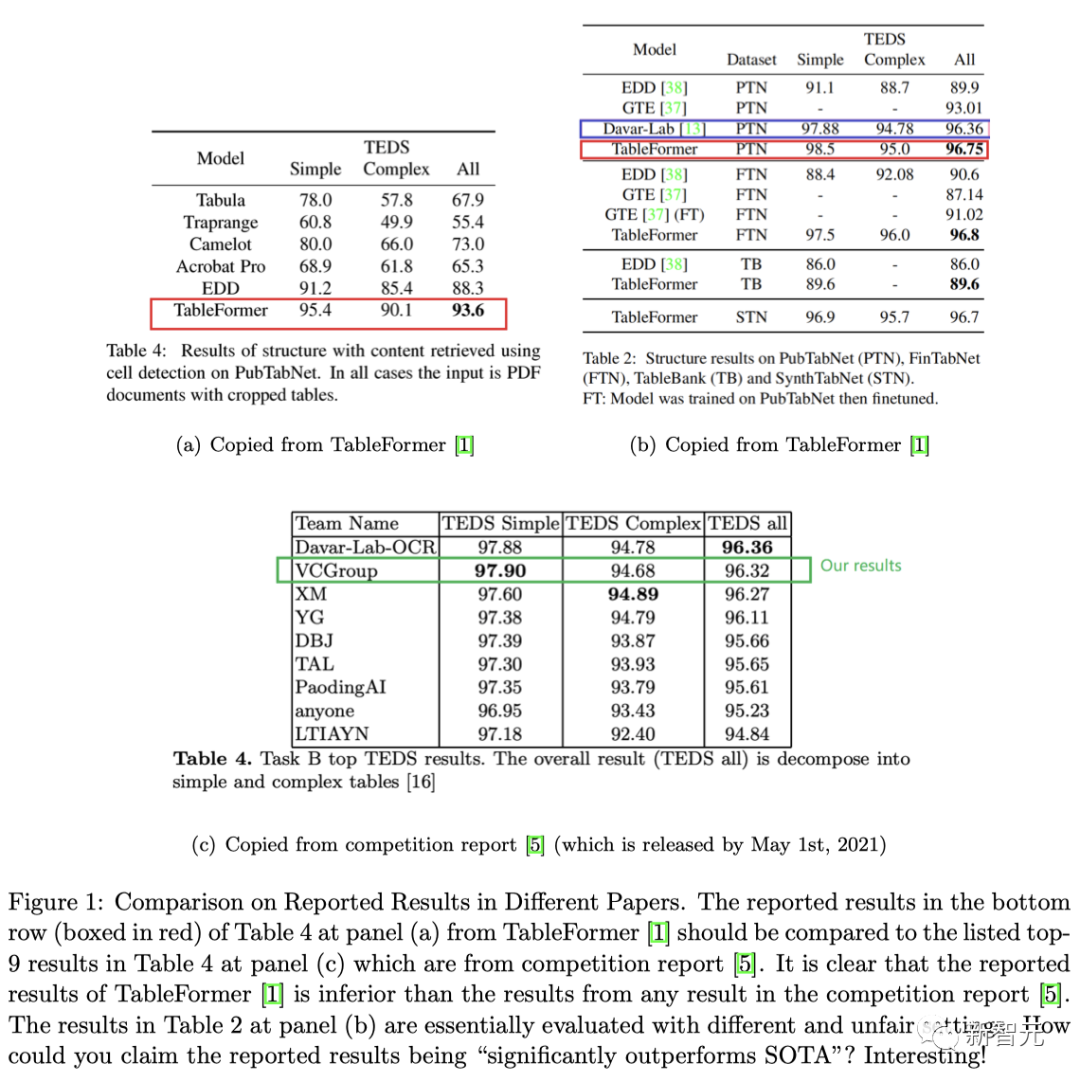

既然IBM是用「未折叠」的token(单个,未合并的token)代替了我们合并的token,那我们就对PubTabNet数据集统计了一下。使用未合并的token序列中,有大约3.9%的表的序列长度超过512。这意味着性能上限应该低于96.1%,甚至在TEDS指数中,性能上限应该低于97%,又怎么能得到96.75%的结果?

我们在图1中展示了相关的数据,其中(c)是竞赛报告中的结果(比赛中的前9名成绩),(a)和(b)是TableFormer论文中的图表。

可以看出,(b)中表的2在性能评估的设置上并不公平。具体来说,(c)中表4所有结果都是针对整个表的内容进行评估的,包括表的结构和内容;而(b)中表2的TableFormer和其他结果,除了Davar-Lab,都是针对表的结构进行评估的。把它们混在一个表中,是对性能的比较是一种误导。

此外,(a)中表4在最下面一行(红框)所呈现出的性能,甚至不能击败(c)表4里的任何一种方法。竞赛中最差的结果也达到了94.84%,比TableFormer的93.6%要高。

所以IBM声称,自己明显优于且超过了5%的SOTA,就非常有趣了!请问,你对「SOTA」的定义是什么?


5 我们没有抄袭后处理方法


  • TableFormer直接从PDF文档中提取文本,它没有使用任何OCR。因此,我们模型的输出是不同的,使用的后处理方法也不同。

  • TableFormer的后处理管线比TableMaster的工作更复杂。

  • 在推理过程中对自回归方法进行缓存,是大家都知道的方法。它已经由开源神经机器翻译(OpenNMT)实现,并在这篇文章中进行了描述。

TableMaster团队回应:把3个点拆成了9个,就是更复杂的创新了?


后处理本身是一个独立的阶段。它不依赖于是否使用文本检测和识别方法的结果,或直接提取PDF单元的结果。

后处理管线是我们在TableMaster中首先提出的,为我们提出的多阶段方法服务。

我们引入了三个复杂的规则,IBM则把这三个规则分解为九个琐碎的点,然而这九个点却都可以归入这三个规则中的一个。这就是「更复杂」了?

对于内存缓存推理,我们已经指出是受到XLNet的启发,而且很早就应用在OCR社区中了。

鉴于以上提到的许多事实,以及表格识别是OCR中一个非常具体和非常小的子领域,我们真的很难相信这个所谓的声明。

6 我们没有混淆视听


  • 我们并不知道TableMaster的工作。甚至在论文的审查过程中,也没人提到过有这么一篇TableMaster的论文。

  • 正如之前所说,我们是在同事的工作基础上进行的,这些工作比TableMaster要早。

  • 在向我们的同事群发电子邮件,以及在Reddit上发表指责的帖子之前,TableMaster团队并没有联系我们。如果TableMaster在公开指责之前联系的话,那么我们会乐意证明我们的观点,并引用TableMaster的工作,比较各种方法。

  • 我们愿意与TableMaster进行讨论,以进一步澄清上述所有问题,并证明我们的工作没有抄袭甚至没有受到TableMaster的启发。

  • 我们要求撤回对抄袭的指控,并向我们道歉。

  • 如果TableMaster团队还不相信,我们不介意他们联系CVPR。我们在代码(git历史)和文档方面有大量的证据,可以证明这些指控完全没有根据,是错误的。

TableMaster团队回应:群众的眼睛是雪亮的!

我们认为受众,即相关领域的专家,可以自己做出判断:
a)TableFormer的作者是否知道我们以前的工作;
b)TableFormer是建立在我们的TableMaster的基础上,还是建立在他们同事的EDD的基础上。

这是一个「学术诚信」事件,而不是一个「引用」上的纠纷。我们公开指责不是因为我们想被引用,而是因为我们被故意抄袭。

我们已经将抄袭行为提交给CVPR社区和IEEE。我们希望他们能成立一个道德委员会,并邀请一些OCR或表格识别领域的专家来调查和评估这一事件。

同时,我们也希望IEEE能够敦促今后的CV或AI会议对剽窃或学术不端行为做出明确的定义。

孰是孰非,大家心中自有定论。众位看官,您怎么看?
参考资料:
https://research.ibm.com/blog/tableformer-response
https://github.com/JiaquanYe/TableMASTER-mmocr/blob/master/Reply2IBMZurich.pdf

阅读原文

* 文章为作者独立观点,不代表数艺网立场转载须知

本内容由数艺网主动采集收录,信息来源为 “新智元” 公开网络发布内容。第三方如需转载本内容,必须完整标注原作者信息及 “来源:数艺网”,严禁擅自篡改、删减或未标注来源转载。 并附上本页链接: 若您的内容不希望被数艺网收录,或认为此举侵犯了您的合法权益,敬请通过微信 ID:d-arts-cn 联系数艺网。我们将致以诚挚歉意,并第一时间为您办理下架或删除处理。

数字媒体艺术 新媒体艺术 科技艺术

12387 举报
  0
登录| 注册 后参与评论