- 0
- 0
- 0
分享
- 亲戚逼相亲?美国小哥生成了一个AI女友躲避催婚
-
2022-10-16
新智元报道
新智元报道
【新智元导读】国外小伙意外发现DALL-E新妙用,AI生成女友竟成逃避长辈催婚利器!?
自从AI图片生成技术爆火以后,各路玩家纷纷亲自尝试。
要不就是用AI做个头像,要不就是生成一些奇思妙想的画作。
但要我说,这些点子和今天的主人公Dinda比起来,简直就是不值一提。
思路打开一点嘛。
用高科技应付长辈?
Dinda是YouTube的一名照片编辑,本着近水楼台先得月的原则,他每天就是和图片生成软件打交道。
最近,Dinda遭遇了全世界大龄青年都会面临的问题——来自长辈的催婚。
然而,Dinda小哥事业未就,怎能思虑儿女情长?可来自长辈的压力又不能不管,那就只剩一条路了——作假骗长辈。
在以前,作假是一件很麻烦的事,要找一个知根知底的异性朋友,约好来个一日情侣。见见家长,把两边都糊弄过去就算完。
但是不得不说,风险挺大的。一个大活人,可不能随时都配合着应付来自长辈的检查。
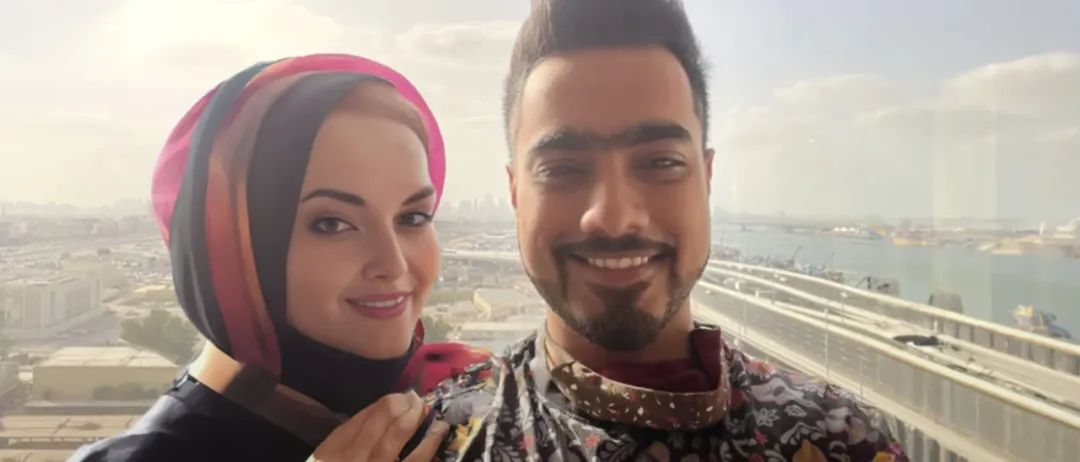
Dinda想了一个妙招。如果自己能用DALL-E生成一大堆和女朋友合拍的照片,时不时给长辈发过去应付一下,不就行了?
Dinda打开了DALL-E,用图像修复功能进行操作。该功能允许用户擦除图片上的一部分,然后DALL-E会根据用户输入的文字来填补空缺的部分。
于是,Dinda整了点自己的自拍照,然后把身边的空间擦了一块,留下一个正好能放下自己假想的女朋友的位置。
接着,他在指令中输入——一个有女朋友的男人。
然后,啪。
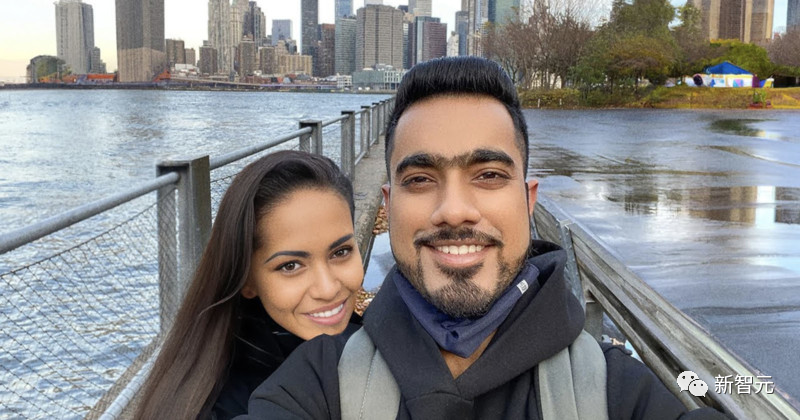
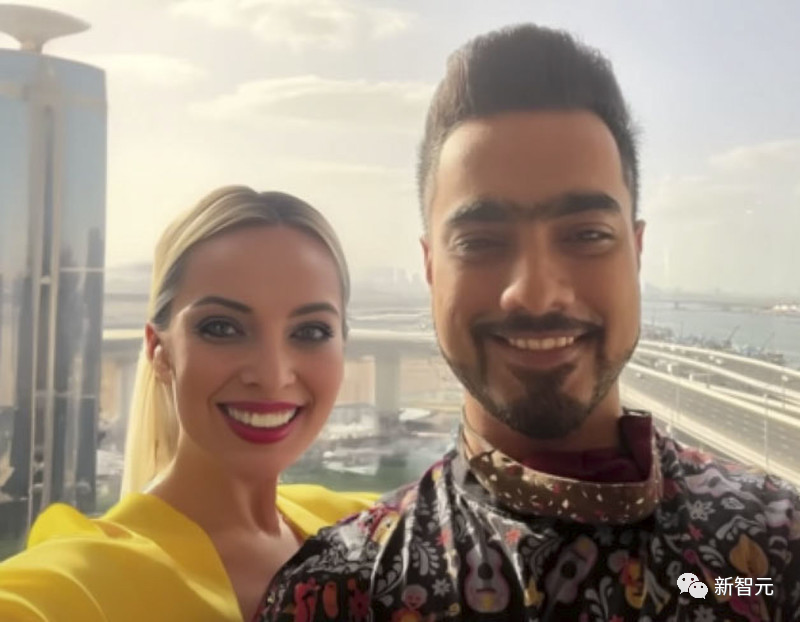
这还不算完,一般和修图打交道的人都很重视细节。
为了让生成的图像更加的逼真,Dinda还把虚拟女友的脸给裁了下来,导出到一个叫GFP-GAN的人工智能照片编辑程序中。
通过这个程序,Dinda可以进行微调,把这张脸做得更逼真。之后再把微调过的图像放到ps里,再修一下,最后放回原始图像。
这样一来,生成的照片就无可挑剔了。
Dinda表示,「就算我告诉别人这张照片是生成的,90%的人也不知道哪里是动过的。」
与此同时,他还演示了照片编辑人员如何使用同样的技术在AI的帮助下把人去掉。
还是一样的把要去掉的人身上涂抹一下,DALL-E就会生成一个替代背景出来。虽然背景很复杂,但是生成出来的图片也还可以。
超凡图像生成工具!
DALL-E究竟是什么呢?
我不允许还有人没听说过DALL·E。毕竟,现在都出到2代——DALL·E 2了。
这是一款由OpenAI开发的转化器模型,全部的功能就是把「话」变成「画」。
具体来说,DALL·E是一个有120亿参数版本的GPT-3,被训练成了使用文本生成图像的模型。背后的数据集是文本-图像的对应集。
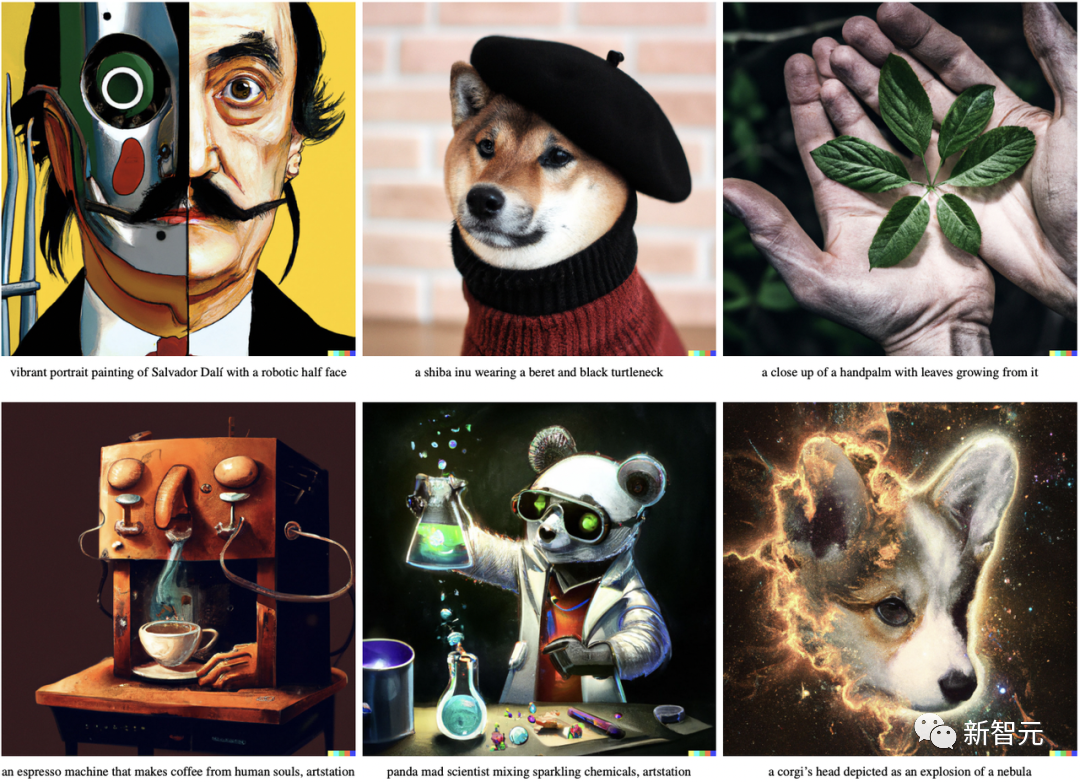
比如上面这几张图,有戴帽子的狗,做实验的熊猫,还有长得像星云的狗狗。有没有觉得,哪怕不合常理,但是并不违和?这就是DALL·E能做到的。说起DALL-E的源头,其实是研究人员从GPT-3那里得到了启发。GPT-3是个用语言生成语言的工具,而图像GPT则可以用来生成高保真度的图片。
研究人员发现,用文本来操控视觉,是可以做到的。也就是这样,DALL·E成为了一个和GPT-3一样的转化器。
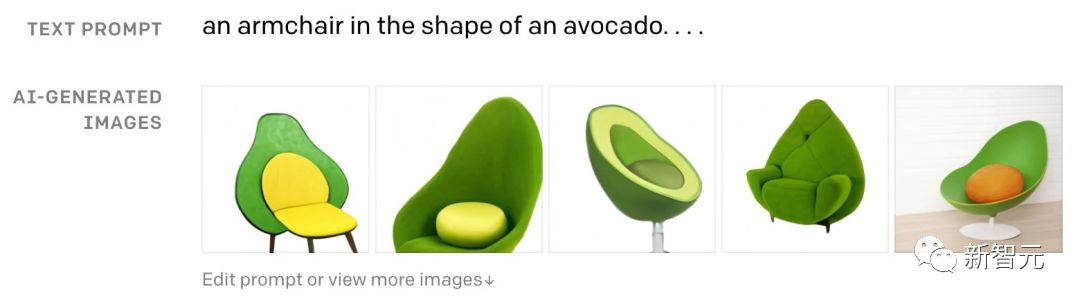
在此基础上,研究人员又开始琢磨同时用文本描述多个物体,生成一张图。这些物体各自的特征、之间的空间位置关系全都交给文字来描述。
比方说,输入文本:一只戴着红帽子、黄手套,穿着蓝衬衫和绿裤子的刺猬。为了正确生成对应的图片,DALL·E不仅要正确理解不同衣服和刺猬之间的关系,还不能混淆不同衣服和颜色的对应关系。
这种任务被称作变量绑定,在文献中有大量的相关研究。
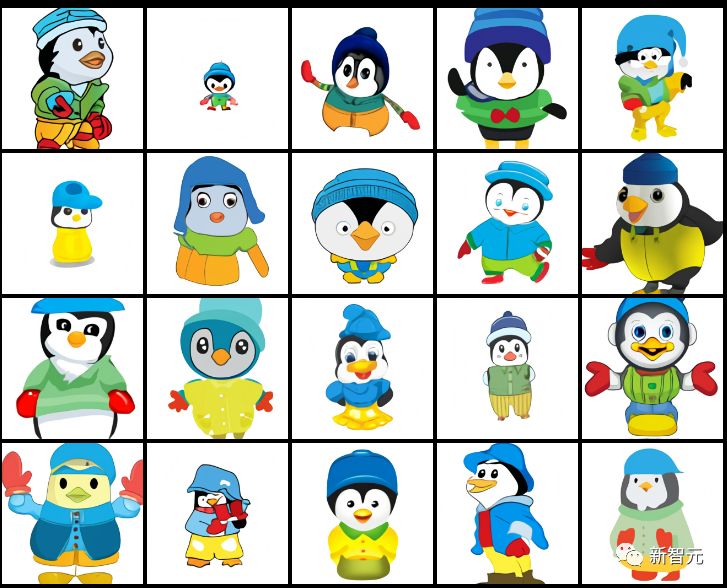
可以说,DALL·E从1代到2代,就是这么一个个小任务走过来的。最终能够呈现的就是一个不错的文本-图像转化器。
T2I究竟有多卷?
要说今年最火的AI便是多模态人工智能崛起。
上半年,文本生成图像AI模型(T2I)各家争霸。
除了DALL-E,谷歌自家Imagen、Parti,Meta的文本图像生成工具Make-A-Scene,再到现在大火的Stable Diffusion、谷歌文本3D生成模型DreamFusion都在扩充着文本转图像的应用。
先是4月,在GPT-3大模型的加持下,Open AI对画图界的扛把子DALL-E进行了2.0版的全面升级。
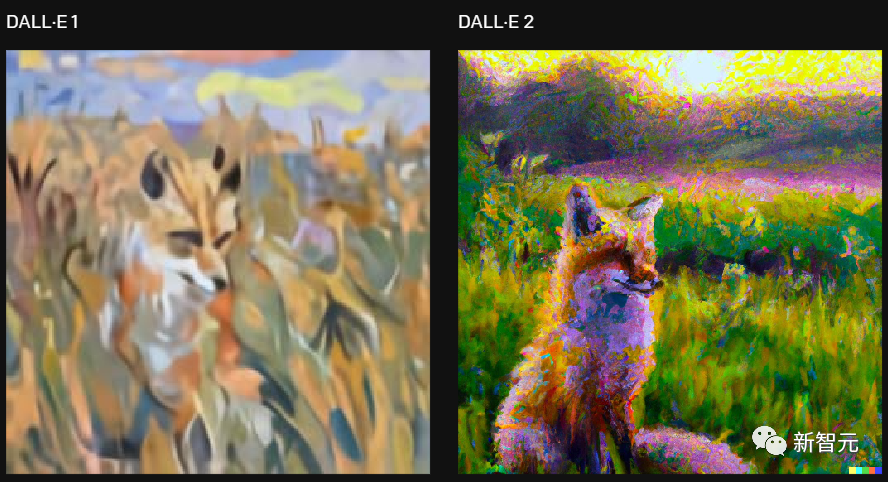
和上一代相比,可以说,DALL·E 2简直就是直接从二次元简笔画走向超高清大图:
分辨率提升4倍,从256x256提升到了1024x1024,并且生成图像的准确率也更高!
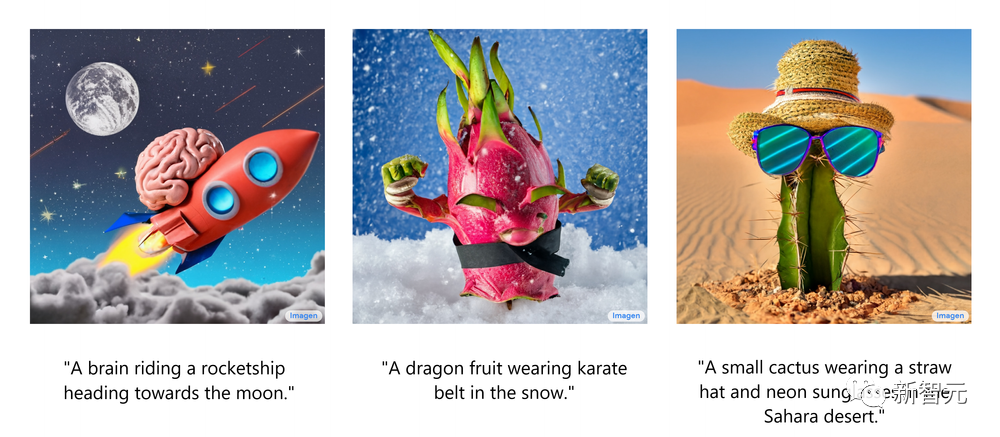
5月,谷歌不甘落后推出AI创作神器Imagen,效果奇佳。
仅仅给出一个场景的描述,Imagen就能生成高质量、高分辨率的图像,无论这种场景在现实世界中是否合乎逻辑。
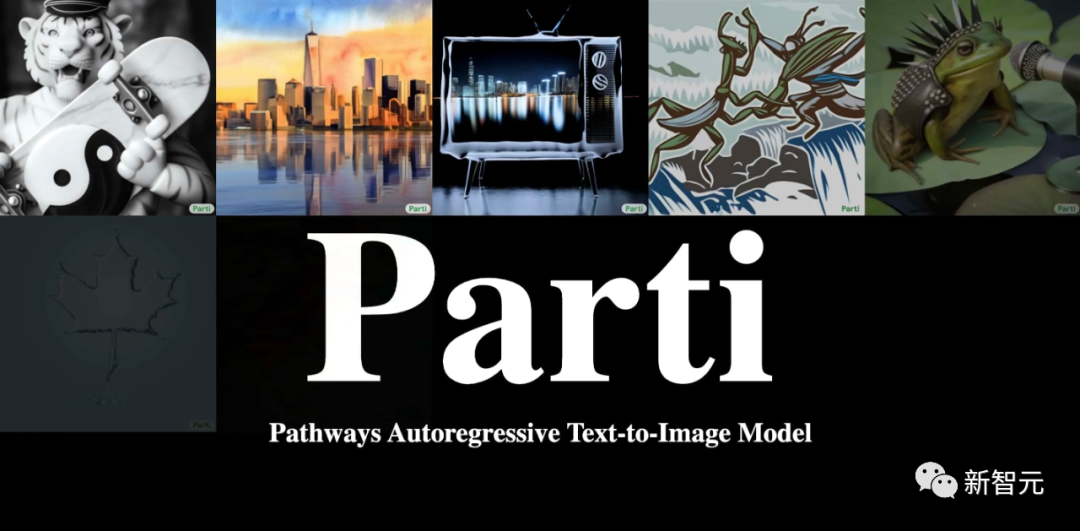
6月,谷歌再次推出了新一代AI绘画大师Parti。
要说Imagen和Parti不同地方,便在于采取了不同的策略——自回归和扩散。
Parti是一个自回归模型,它的方法首先将一组图像转换为一系列代码条目,然后将给定的文本提示转换为这些代码条目并「拼成」一个新图像。
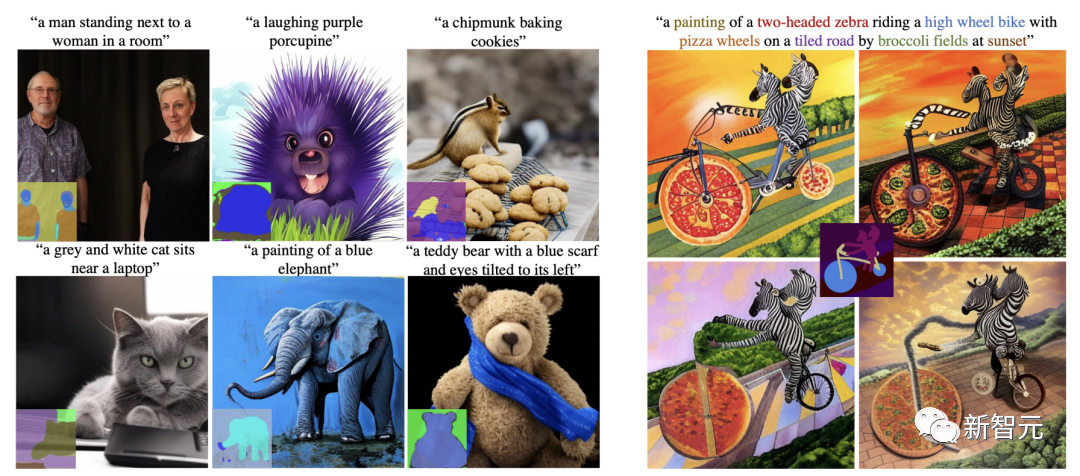
7月,Meta公布了自家的AI「画家」——Make-A-Scene,通过文本描述,再加上一张草图,就能生成你想要的样子。
最重要的是,构图上下、左右、大小、形状等各种元素都由你说了算。
可以看到,DALL-E 2、Imagen等仍然停留在二维创作,无法生成360度无死角的3D模型。
而谷歌发布的文本3D生成模型DreamFusion便开辟了这一新路线。
训练后的模型可以在任意角度、任意光照条件、任意三维环境中基于给定的文本提示生成模型。
而且整个过程既不需要3D训练数据,也无需修改图像扩散模型,完全依赖预训练扩散模型作为先验。
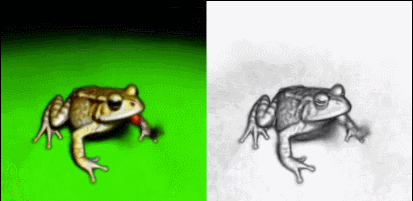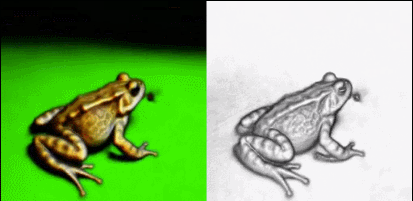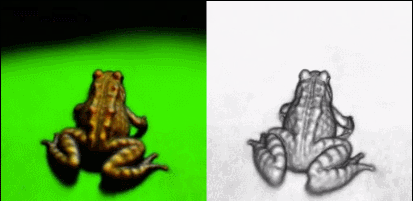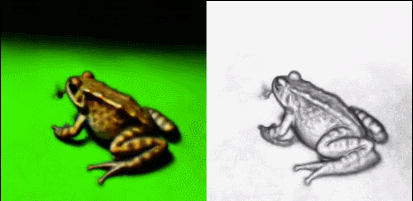
由此可见,在文本转图像这块,各大厂已经卷上了新高度。
甚至有人称,今年文本转视频AI模型暂时还不会到来。
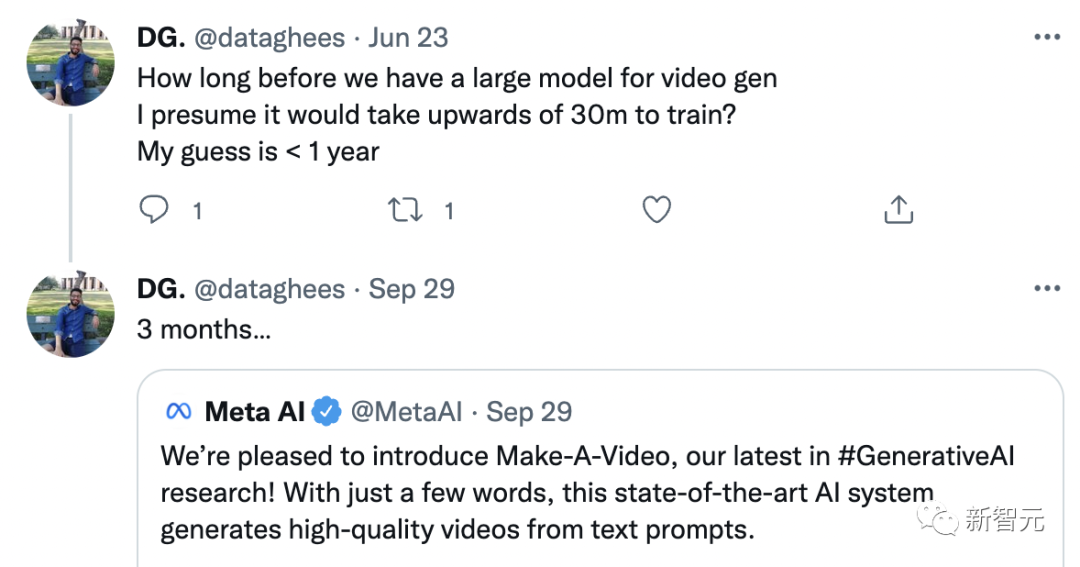
没想到的是,Meta和谷歌再次打破了这一预言。
T2V已来!
9月底,Meta最先公布了文本一键生成视频模型Make-A-Video。
这一模型厉害到什么程度?
除了可以把文本变成视频之外,它也可以把静态图变成Gif、把视频变成视频。
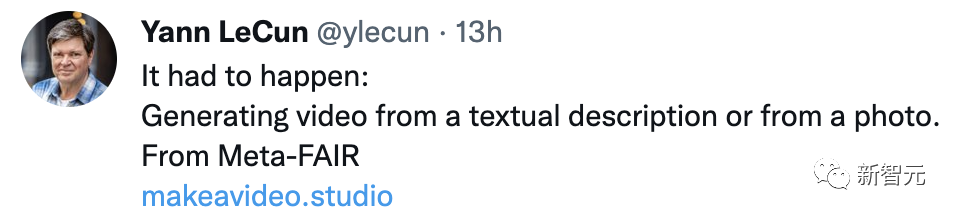
这一模型发布后,就连图灵奖得主Yann LeCun称,该来的都会来。
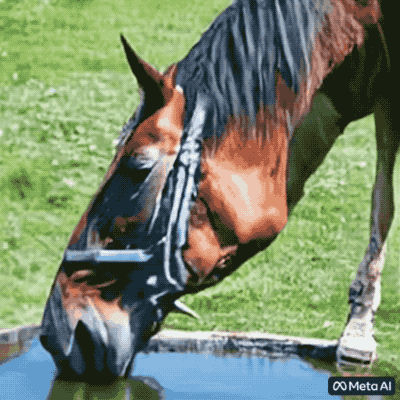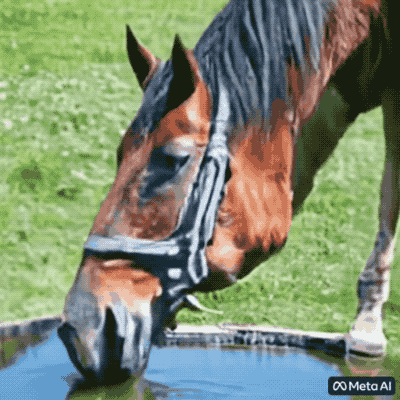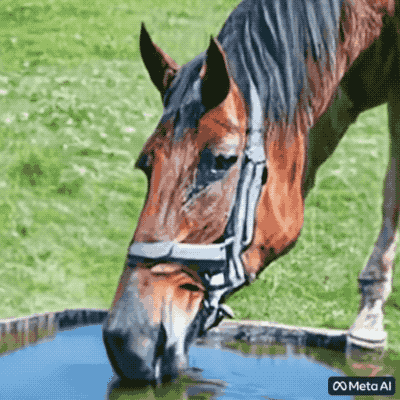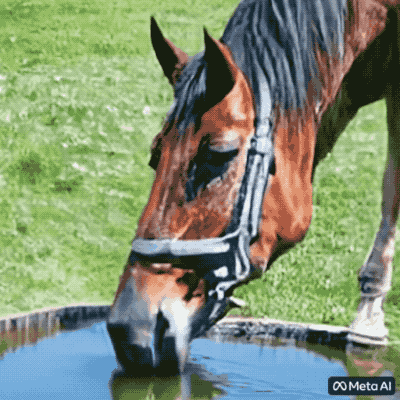
比如「马儿喝水」,生成如下效果:
猫主子拿着遥控器在看电视
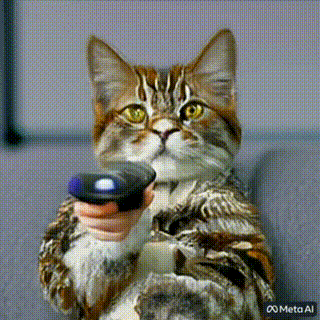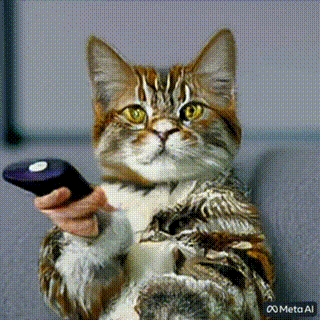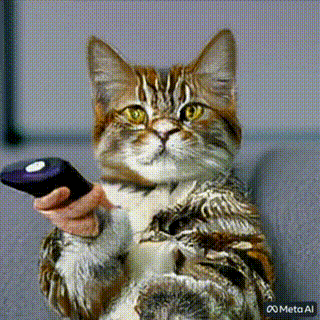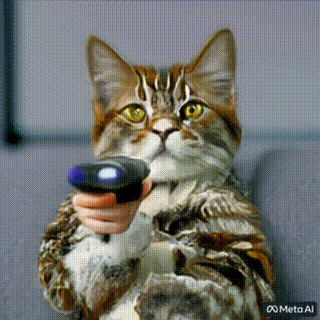
简直AI导演上线。
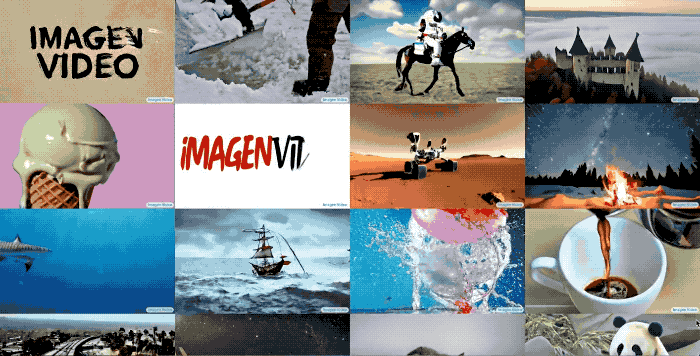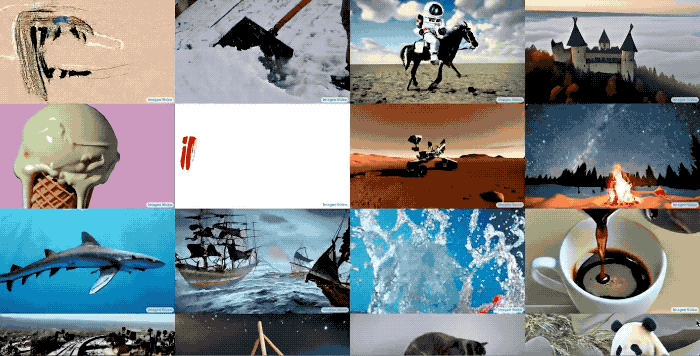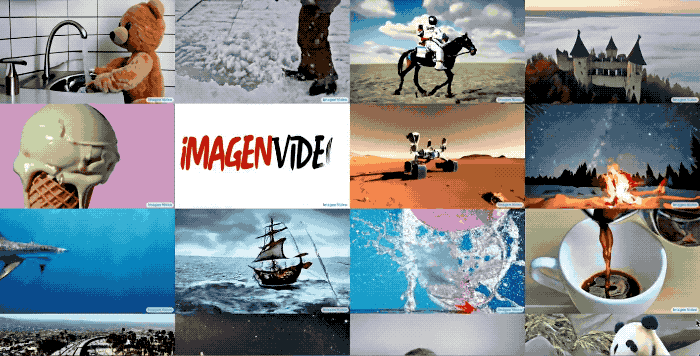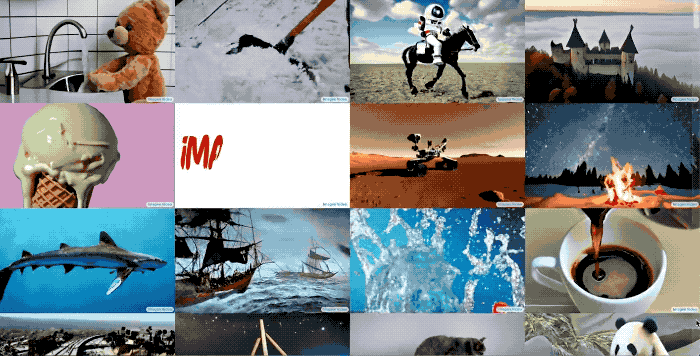
紧接着10月,谷歌还是文本视频模型两连发。
先是Imagen Video,与Meta的Make-A-Video相比最突出一个特点就是「高清」。
它能生成1280*768分辨率、每秒24帧的视频片段。
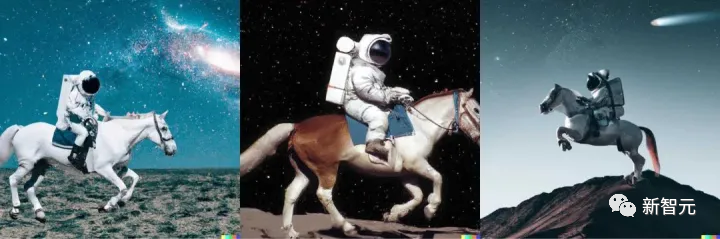
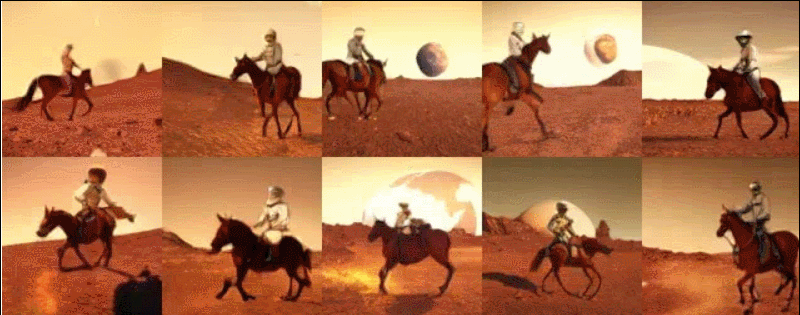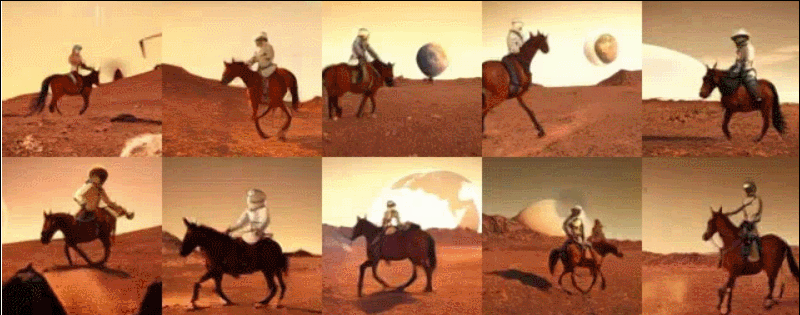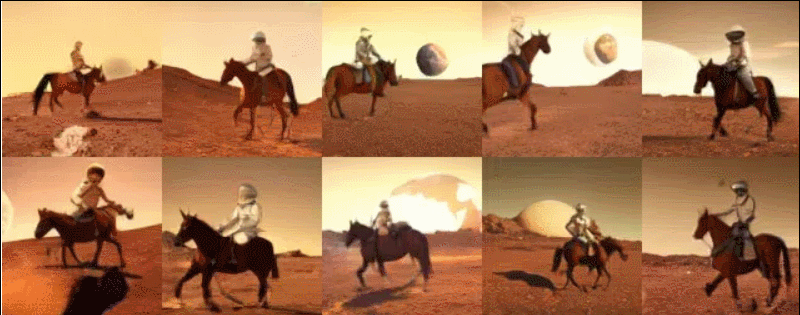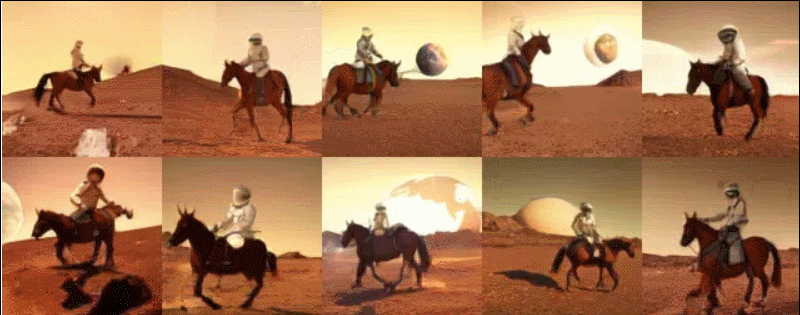
与此同时,还有Phenaki模型,让骑马的宇航员也动了起来。
这一模型能根据200个词左右的提示语生成2分钟以上的长镜头,讲述一个完整的故事。
在文本转视频上,下一个谁会接棒?
https://petapixel.com/2022/10/14/photographer-creates-ai-girlfriend-to-stave-off-nosy-relatives/
-
阅读原文
* 文章为作者独立观点,不代表数艺网立场转载须知
- 本内容由数艺网主动采集收录,信息来源为 “新智元” 公开网络发布内容。第三方如需转载本内容,必须完整标注原作者信息及 “来源:数艺网”,严禁擅自篡改、删减或未标注来源转载。 并附上本页链接: 若您的内容不希望被数艺网收录,或认为此举侵犯了您的合法权益,敬请通过微信 ID:d-arts-cn 联系数艺网。我们将致以诚挚歉意,并第一时间为您办理下架或删除处理。
-
-
北京
甲方 · 媒体平台
未认证的机构号
最近发布
-
2025-08-13
-
2025-07-18