【新智元导读】让我们回顾一下AI图像合成的十年历史上,「the names to be remembered」。
深度学习模型在生成图像上的表现,已经如此出色。很显然,它在未来会给我们更多的惊喜。在下面的时间线里,我们会追溯一些里程碑式的时刻,也就是那些影响了AI图像合成的论文、架构、模型、数据集、实验登场的时候。深度神经网络面世之后,人们意识到:它将彻底改变图像分类。
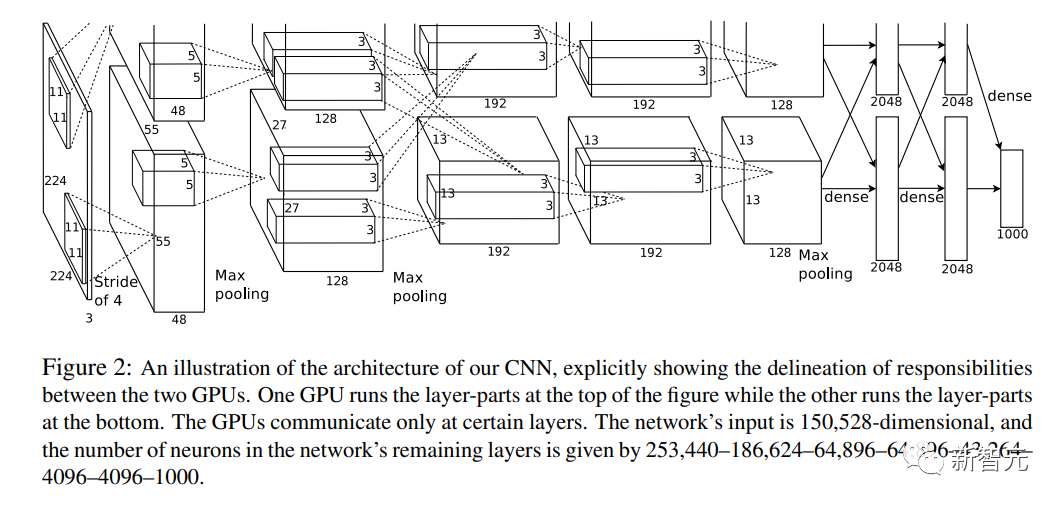
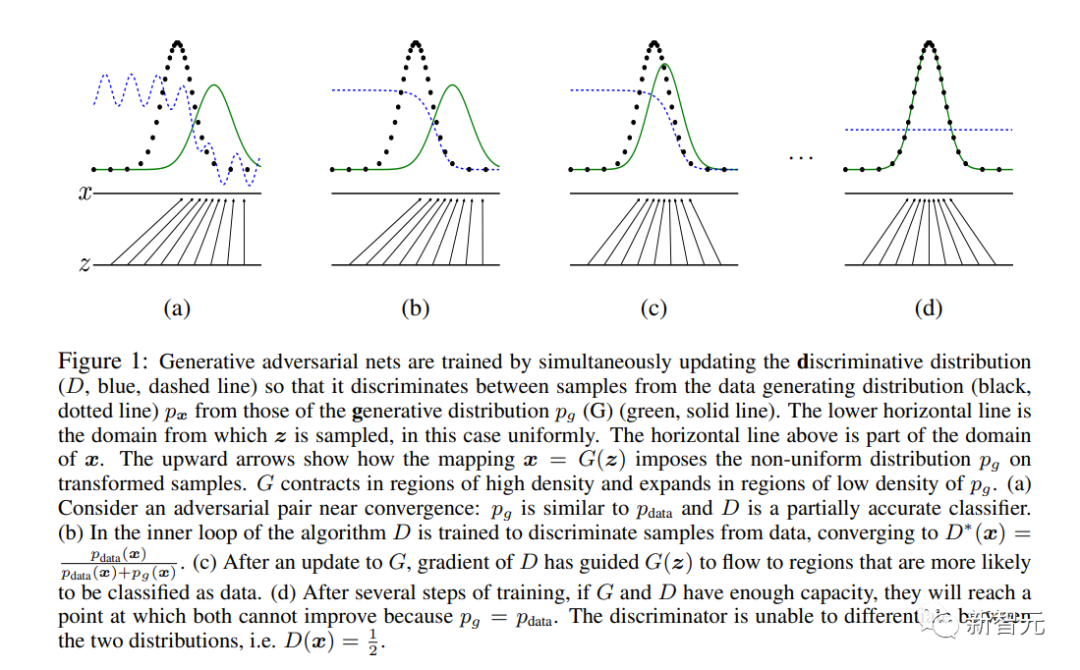
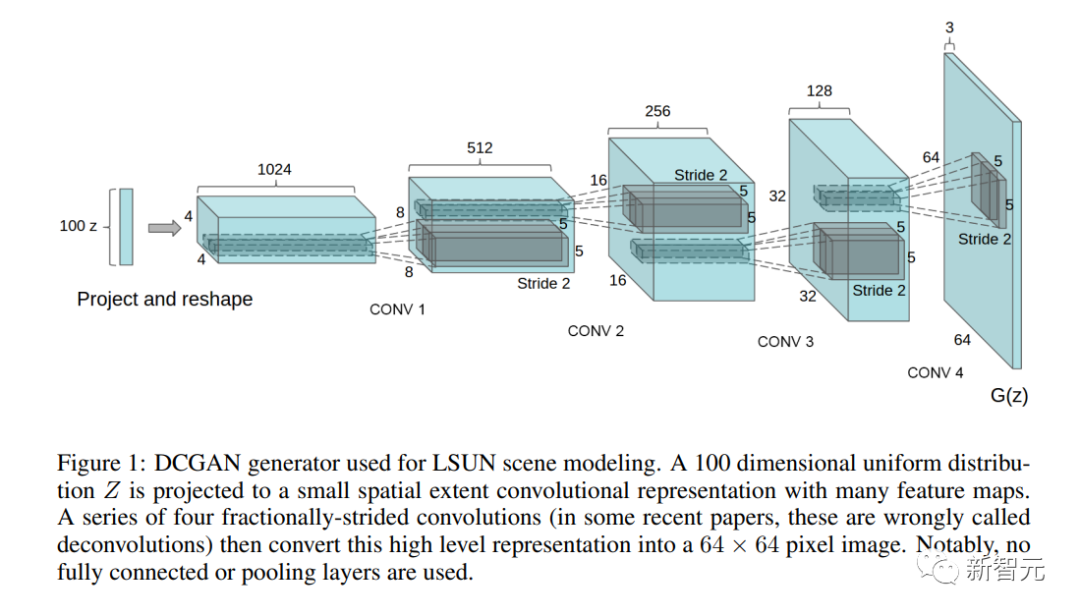
同时,研究人员开始探索相反的方向,如果使用一些对分类非常有效的技术(例如卷积层)来制作图像,会发生什么?这一年,论文《深度卷积神经网络的ImageNet分类》横空出世。论文作者之一,就是「AI三巨头」之一的Hinton。它首次将深度卷积神经网络 (CNN)、GPU和巨大的互联网来源数据集(ImageNet)结合在一起。Ian Goodfellow等AI巨佬发表了史诗性论文巨作《生成式对抗网络》。GAN是第一个致力于图像合成而非分析的现代神经网络架构(「现代」的定义即2012年后)。它引入了一种基于博弈论的独特学习方法,由两个子网络“生成器”和“鉴别器”进行竞争。最终,只有「生成器」被保留在系统之外,并用于图像合成。Hello World!来自Goodfellow等人2014年论文的GAN生成人脸样本。该模型是在Toronto Faces数据集上训练的,该数据集已从网络上删除具有重大意义的论文《使用深度卷积生成对抗网络进行无监督代表学习》发表。在这篇论文中,作者描述了第一个实际可用的GAN 架构 (DCGAN)。这篇论文还首次提出了潜在空间操纵的问题——概念是否映射到潜在空间方向?这五年间,GAN被应用于各种图像处理任务,例如风格转换、修复、去噪和超分辨率。
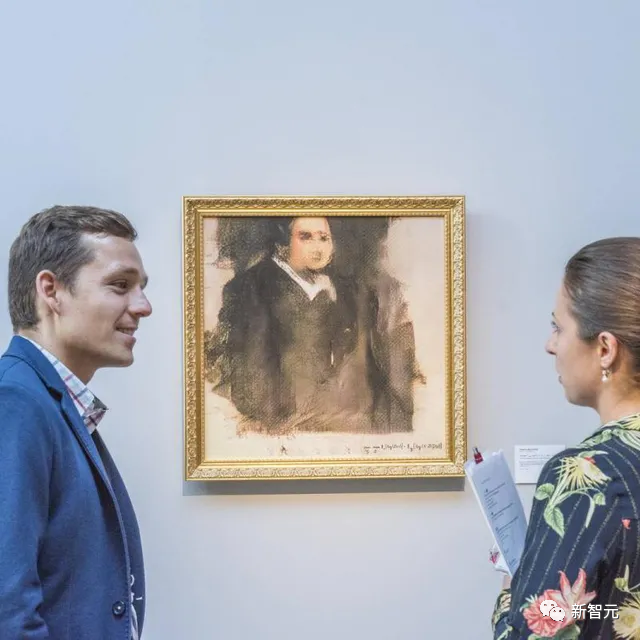
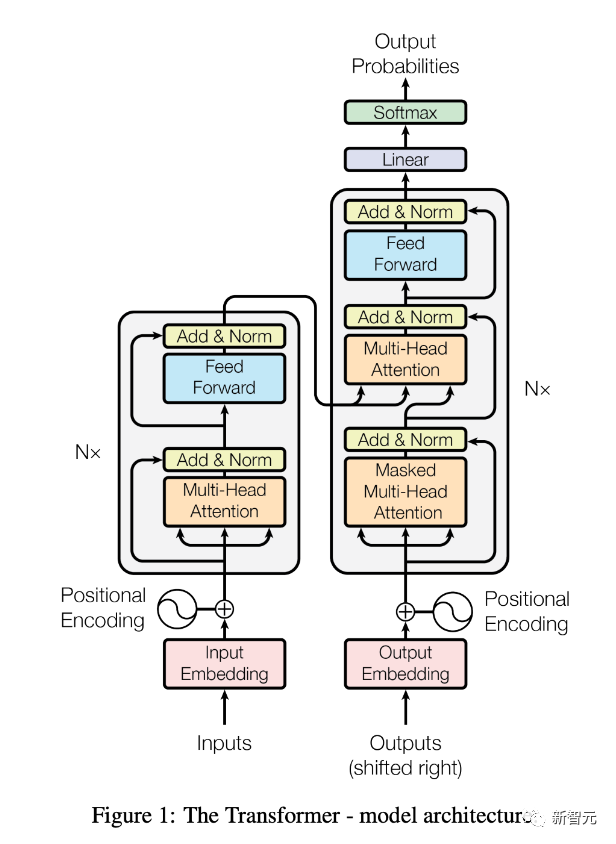
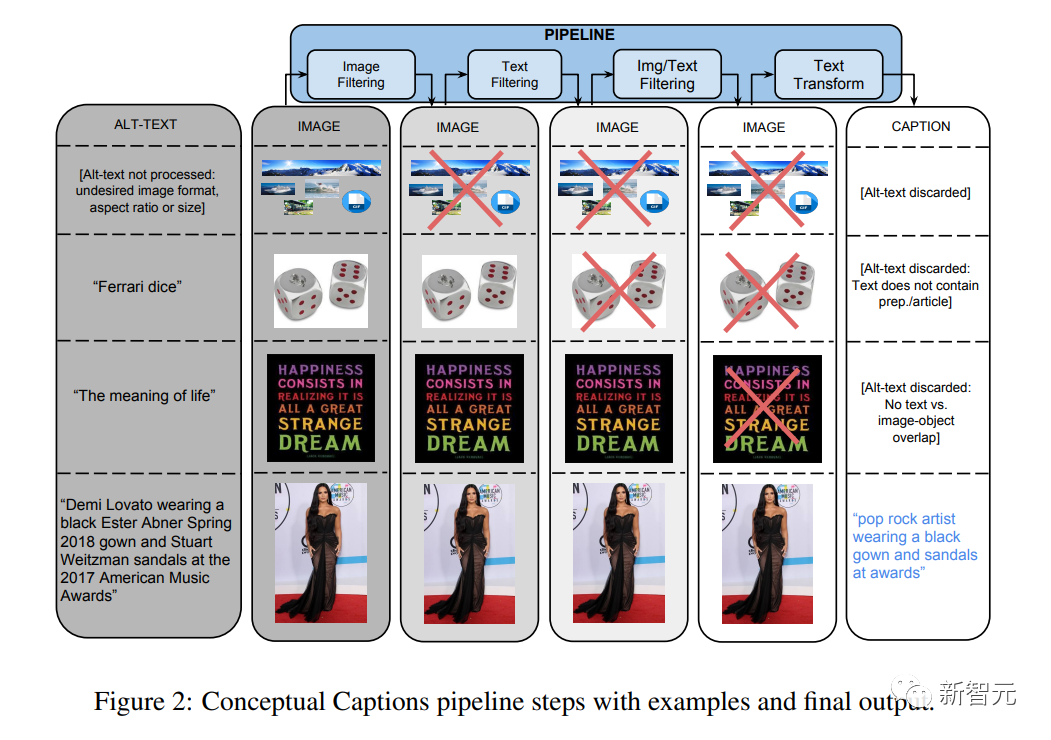
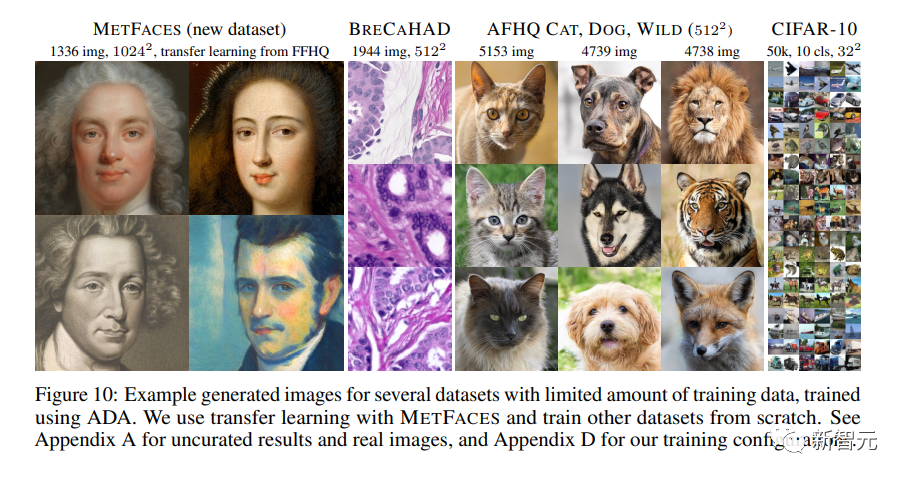
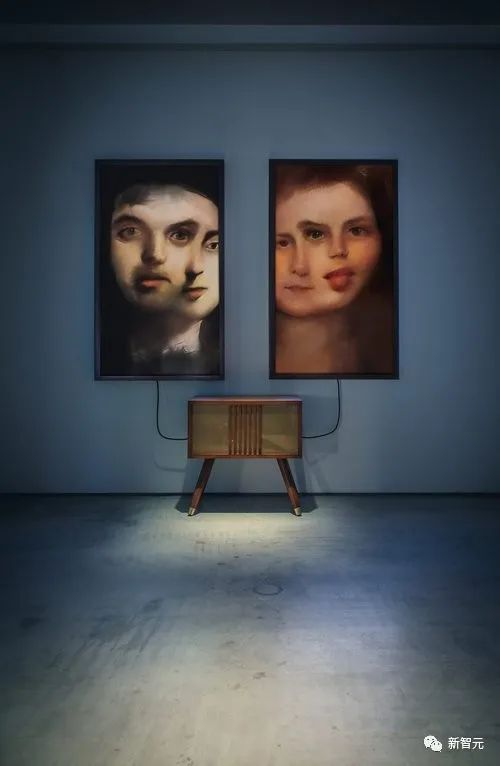
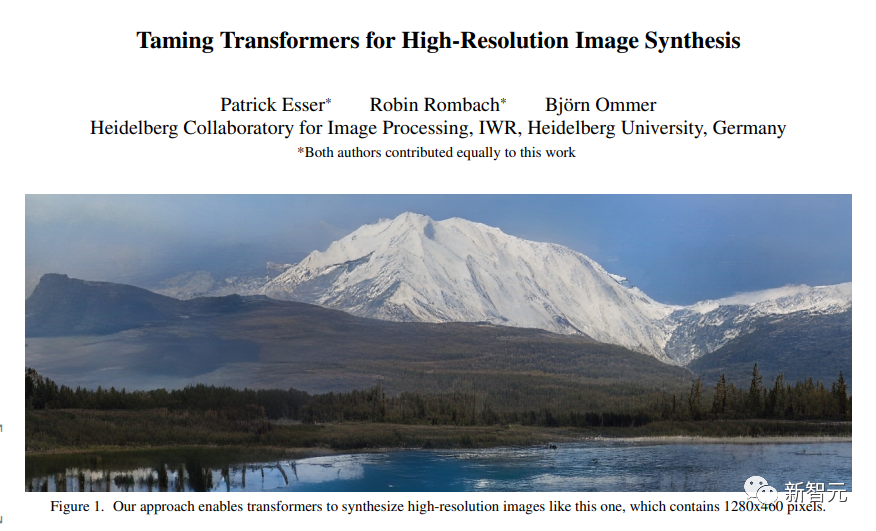
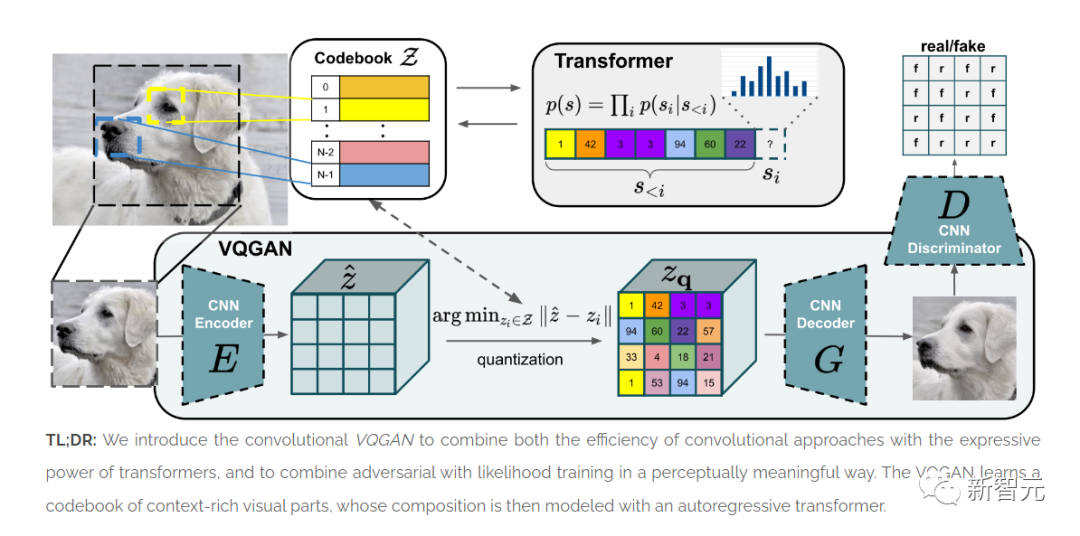
项目地址:https://github.com/nightrome/really-awesome-gan与此同时,GAN的艺术实验开始兴起,Mike Tyka、Mario Klingenmann、Anna Ridler、Helena Sarin 等人的第一批作品出现。第一个「AI 艺术」丑闻发生在2018年。三位法国学生使用「借来」的代码生成一副AI肖像,这副肖像成为第一幅在佳士得被拍卖的AI画像。与此同时,transformer架构彻底改变了NLP。《Attention Is All You Need》论文发布。在《Transformers, Explained: Understand the Model Behind GPT-3, BERT, and T5》里,也有详实的解释。自此,Transformer架构(以BERT等预训练模型的形式)彻底改变了自然语言处理 (NLP) 领域。《概念性标注:用于自动图像字幕的清理、上位化、图像替代文本数据集》论文发表。这个和其他多模态数据集对于 CLIP 和 DALL-E 等模型将变得极其重要。NVIDIA的研究人员对GAN 架构进行了一系列彻底改进。在《使用有限数据训练生成对抗网络》这篇论文中,介绍了最新的StyleGAN2-ada。GAN 生成的图像第一次变得与自然图像无法区分,至少对于像Flickr-Faces-HQ (FFHQ)这样高度优化的数据集来说是这样。Mario Klingenmann, Memories of Passerby I, 2018. The baconesque faces是该地区AI艺术的典型代表,其中生成模型的非写实性是艺术探索的重点OpenAI的LLM Generative Pre-trained Transformer 3(GPT-3)展示了变压器架构的强大功能。论文《用于高分辨率图像合成的Taming transformers》发表。ViT表明,Transformer架构可用于图像。本文中介绍的方法VQGAN在基准测试中产生了SOTA结果。2010年代后期的GAN架构的质量主要根据对齐的面部图像进行评估,对于更多异构数据集的效果很有限。因此,在学术/工业和艺术实验中,人脸仍然是一个重要的参考点。Transformer的时代(2020-2022)
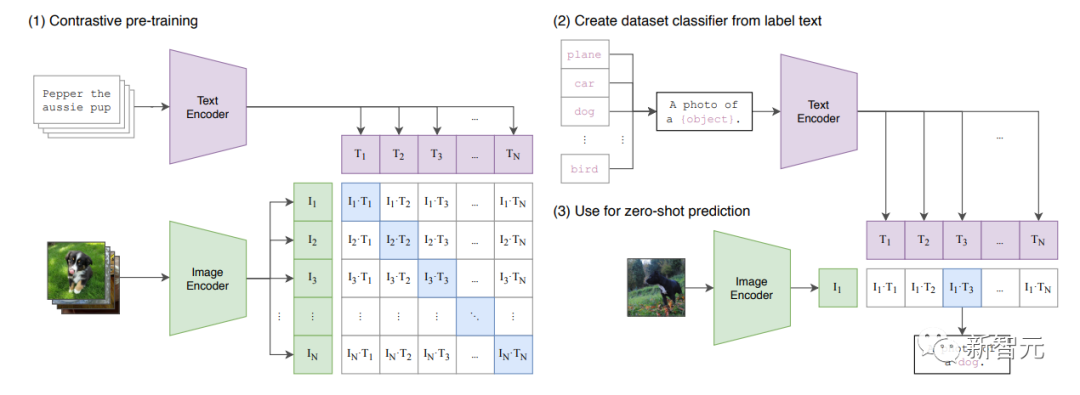
Transformer架构的出现,彻底改写了图像合成的历史。「多模态」深度学习整合了NLP和计算机视觉的技术,「即时工程」取代了模型训练和调整,成为图像合成的艺术方法。《从自然语言监督中学习可迁移视觉模型》这篇论文中,提出了CLIP 架构。可以说,当前的图像合成热潮,是由CLIP首次引入的多模态功能推动的。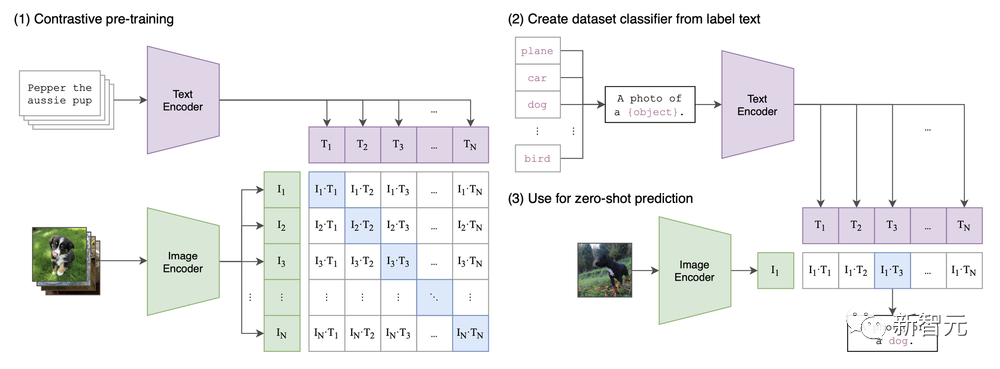
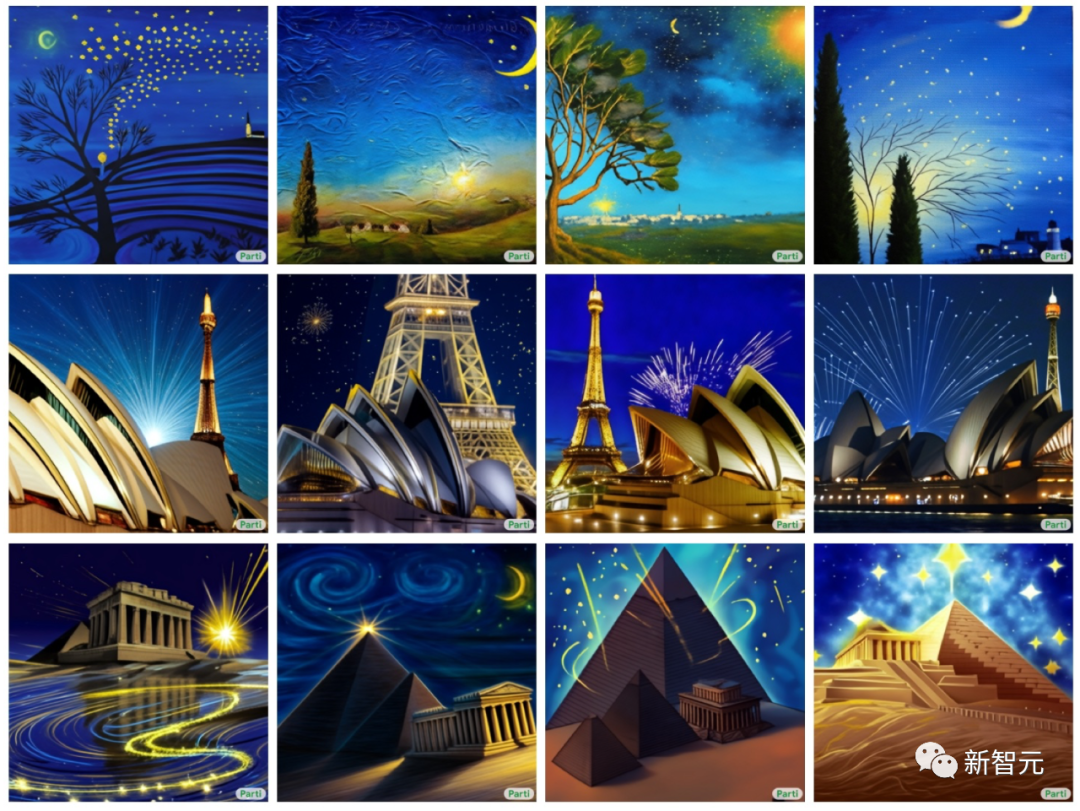
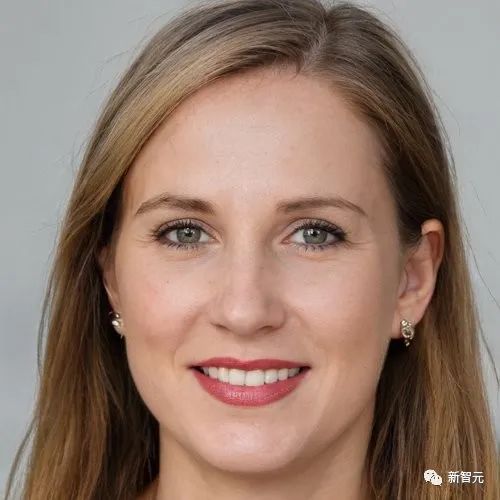
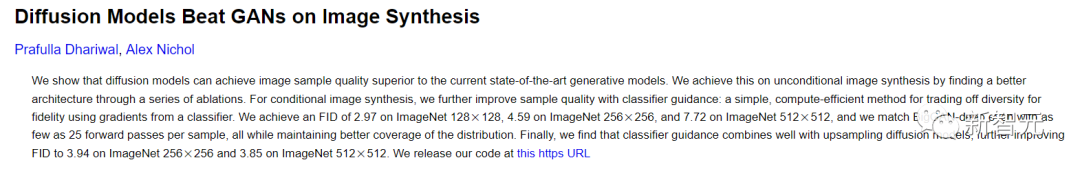
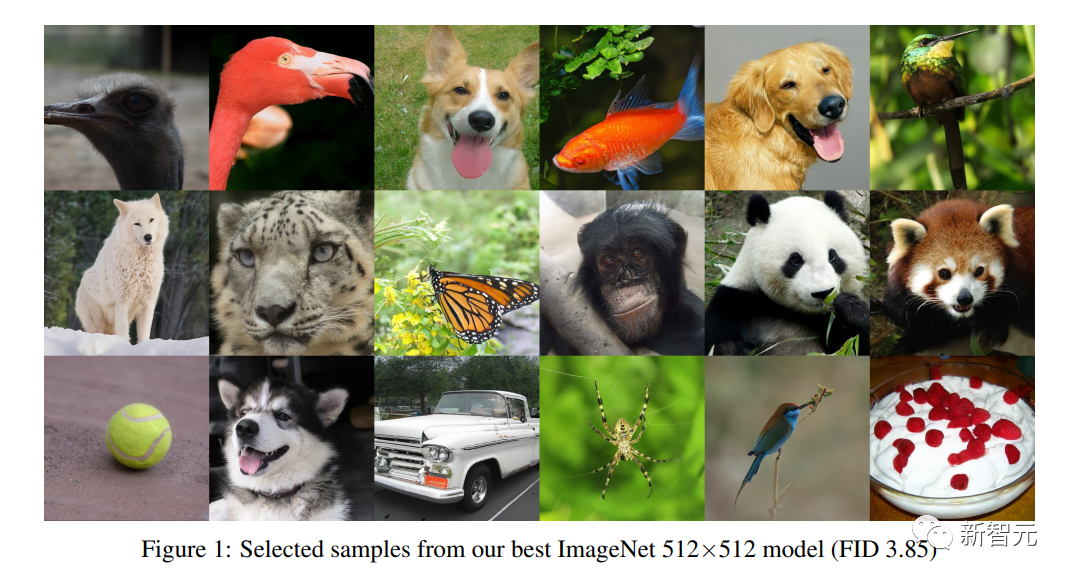
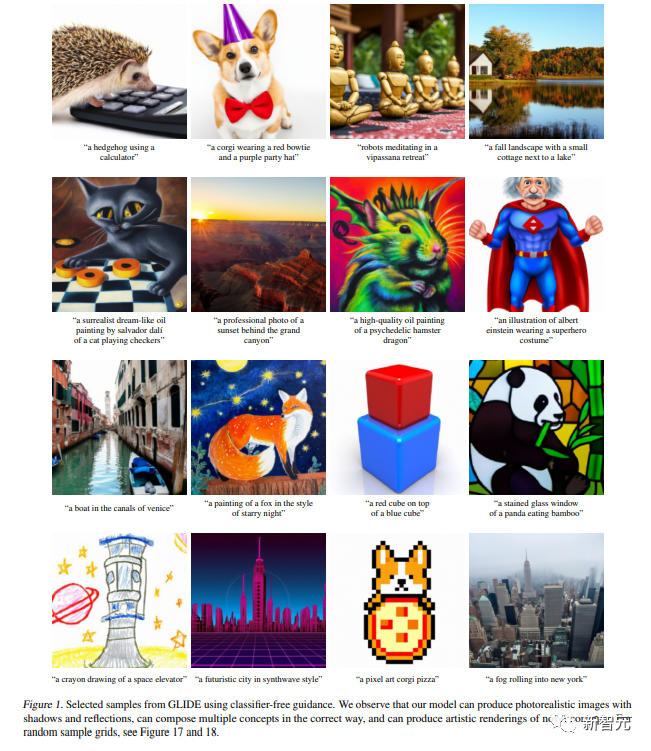
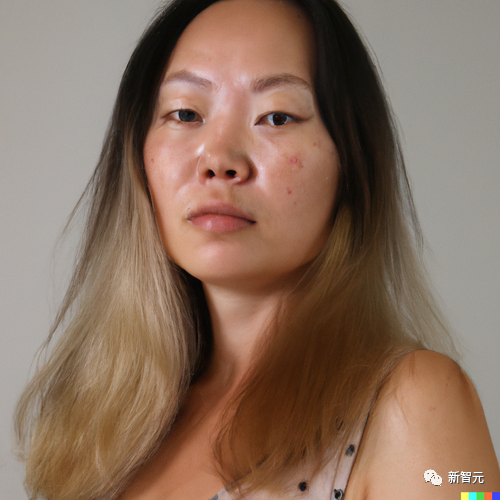
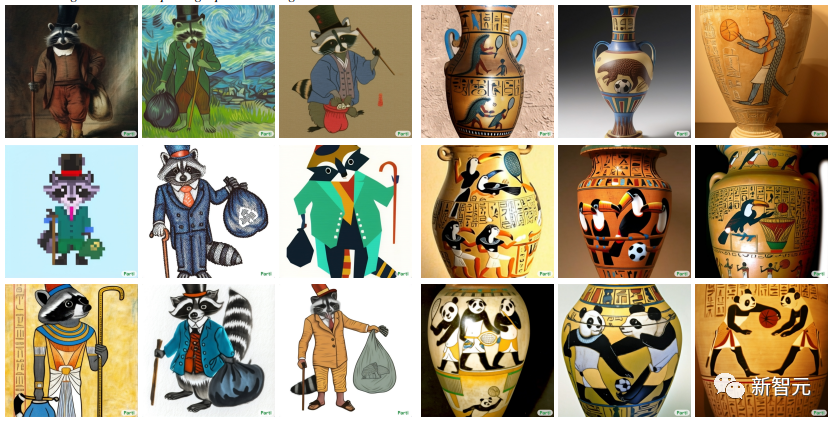
论文《零样本文本到图像生成》发表(另请参阅OpenAI 的博客文章),其中介绍了即将轰动全世界的DALL-E的第一个版本。这个版本通过将文本和图像(由VAE压缩为「TOKEN」)组合在单个数据流中来工作。该模型只是「continues」the「sentence」。数据(250M 图像)包括来自维基百科的文本图像对、概念说明和YFCM100M的过滤子集。论文中介绍了CLIP,这是一种结合了ViT和普通Transformer的多模态模型。CLIP会学习图像和标题的「共享潜在空间」,因此可以标记图像。模型在论文附录A.1中列出的大量数据集上进行训练。论文《扩散模型的发布在图像合成方面击败了GAN》发表。扩散模型引入了一种不同于GAN方法的图像合成方法。它是DALL-E的复制品(体积更小,对架构和数据的调整很少)。数据包括Conceptual 12M、Conceptual Captions以及 OpenAI 用于原始 DALL-E 模型的YFCM100M相同过滤子集。因为没有任何内容过滤器或 API 限制,DALL-E mini为创造性探索提供了巨大的潜力,并导致推特上「怪异的 DALL-E」图像呈爆炸式增长。Katherine Crowson发布了一系列CoLab笔记,探索制作 CLIP 引导生成模型的方法。例如512x512CLIP-guided diffusion和VQGAN-CLIP(Open domain image generation and editing with natural language guidance,仅在2022年作为预印本发布但VQGAN一发布就出现了公共实验)。就像在早期的GAN时代一样,艺术家和开发者以非常有限的手段对现有架构进行重大改进,然后由公司简化,最后由wombo.ai等「初创公司」商业化。论文《具有 CLIP 潜能的分层文本条件图像生成》发表。它建立在仅几周前发布的 GLIDE论文(《 GLIDE:使用文本引导扩散模型实现逼真图像生成和编辑》的基础上。同时,由于 DALL-E 2 的访问受限和有意限制,人们对DALL-E mini重新产生了兴趣。根据模型卡,数据包括「公开可用资源和我们许可的资源的组合」,以及根据该论文的完整CLIP和 DALL-E数据集。「金发女郎的人像照片,用数码单反相机拍摄,中性背景,高分辨率」,使用 DALL-E 2 生成。基于 Transformer 的生成模型与后来的 GAN 架构(如 StyleGAN 2)的真实感相匹配,但允许创建广泛的各种主题和图案5月,论文《具有深度语言理解的真实感文本到图像扩散模型》发表。6月,论文《用于内容丰富的文本到图像生成的缩放自回归模型》发表。这两篇论文中,介绍了Imagegen和Parti。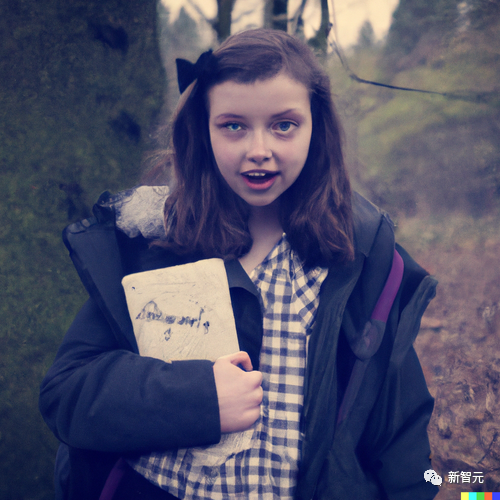
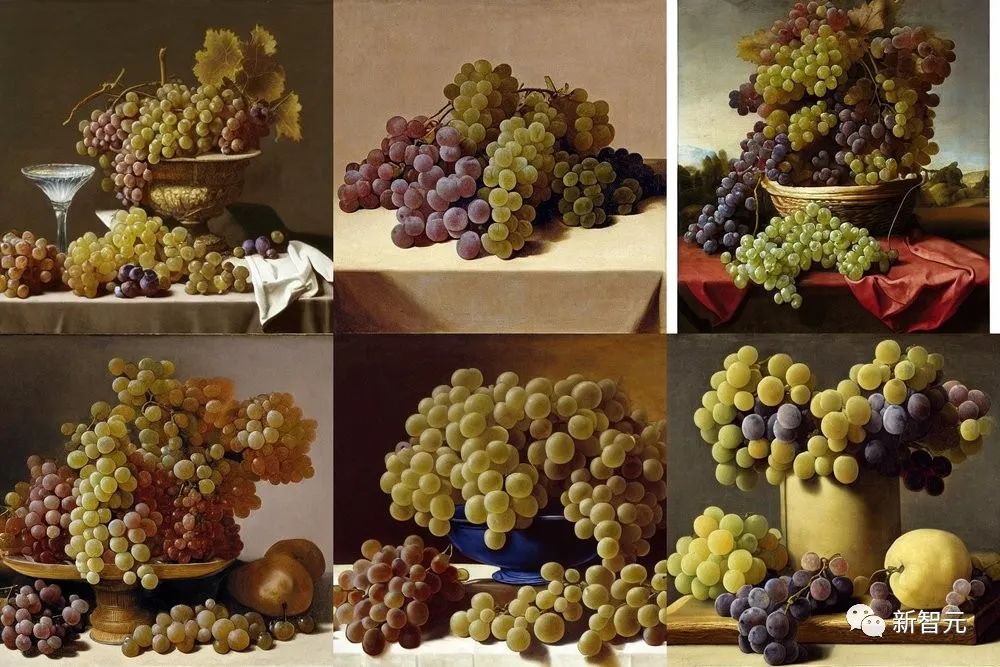
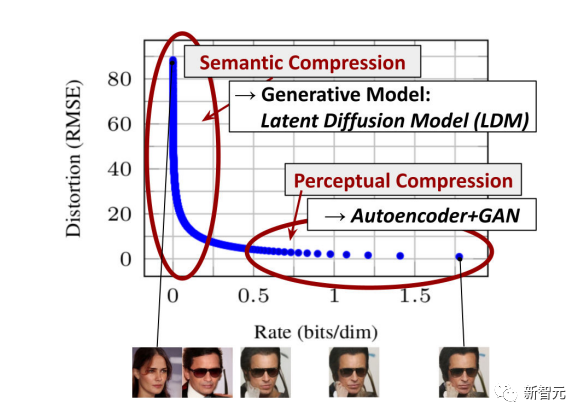
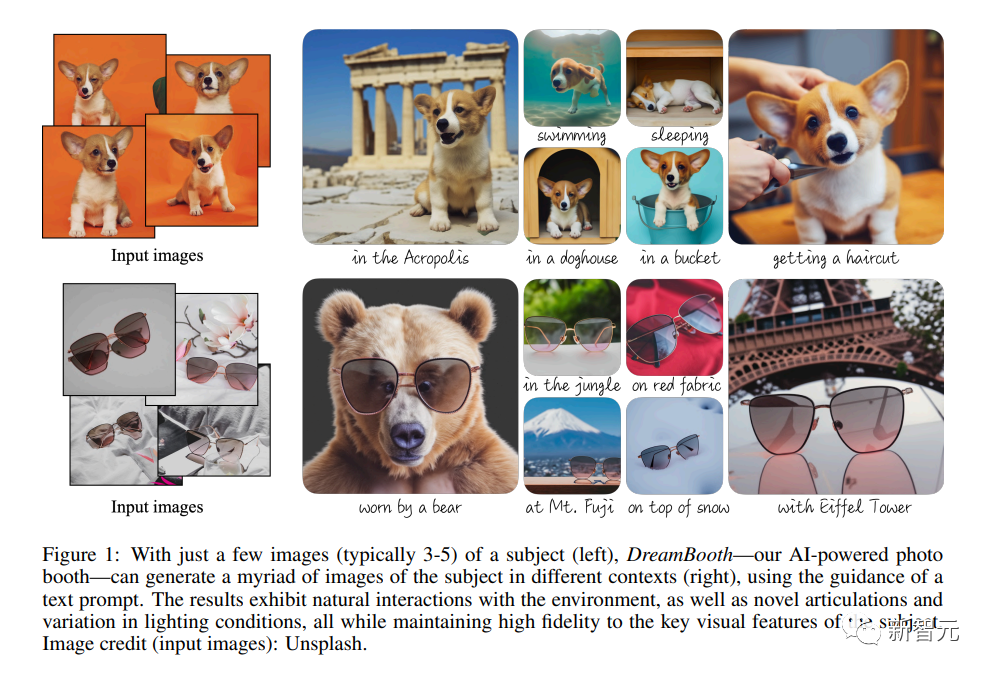
「你知道我今天为什么阻止你吗?」由DALL-E 2生成,「prompt engineering」从此成为艺术图像合成的主要方法虽然DALL-E 2为图像模型设定了新标准,但它迅速商业化,也意味着在使用上从一开始就受到限制。用户仍继续尝试DALL-E mini等较小的模型。紧接着,随着石破天惊的Stable Diffusion的发布,所有这一切都发生了变化。可以说,Stable Diffusion标志着图像合成「Photoshop时代」的开始。「有四串葡萄的静物,试图创造出像古代画家 Zeuxis Juan El Labrador Fernandez,1636 年,马德里普拉多的葡萄一样栩栩如生的葡萄」,Stable Diffusion产生的六种变化Stability.ai发布Stable Diffusion模型。在论文《具有潜在扩散模型的高分辨率图像合成》中,Stability.ai隆重推出了Stable Diffusion。这个模型可以实现与DALL-E 2同等的照片级真实感。除了DALL-E 2,模型几乎立即向公众开放,并且可以在CoLab和Huggingface平台上运行。谷歌发表论文《DreamBooth:为主题驱动生成微调文本到图像扩散模型》。DreamBooth提供了对扩散模型越来越细粒度的控制。然而,即使没有此类额外的技术干预,使用像 Photoshop 这样的生成模型也变得可行,从草图开始,逐层添加生成的修改。最大的图库公司之一Shutterstock宣布与 OpenAI 合作提供/许可生成图像,可以预计,图库市场将受到Stable Diffusion等生成模型的严重影响。https://zentralwerkstatt.org/blog/ten-years-of-image-synthesis