- 0
- 0
- 0
分享
- 我,开发者,在元宇宙里有一行自己的代码!
-
2022-12-12
新智元报道
新智元报道
【新智元导读】随着元宇宙热潮兴起,扩展现实领域也蓬勃发展。但对研究者而言,想要上手研究扩展现实领域,还需要耗费不少时间、精力去解决繁琐的环境配置、不同代码库的底层规范以及代码库之间串接的问题。
图源:Arplanet
从0到1
为更好地解决上述问题,推动扩展现实领域算法更高效地研发、迭代和集成,上海人工智能实验室联合浙江大学、商汤科技共同于2022年9月1日在世界人工智能大会上,正式发布了OpenXRLab扩展现实开源平台。
平台官网:https://openxrlab.org.cn/
1+3平台架构
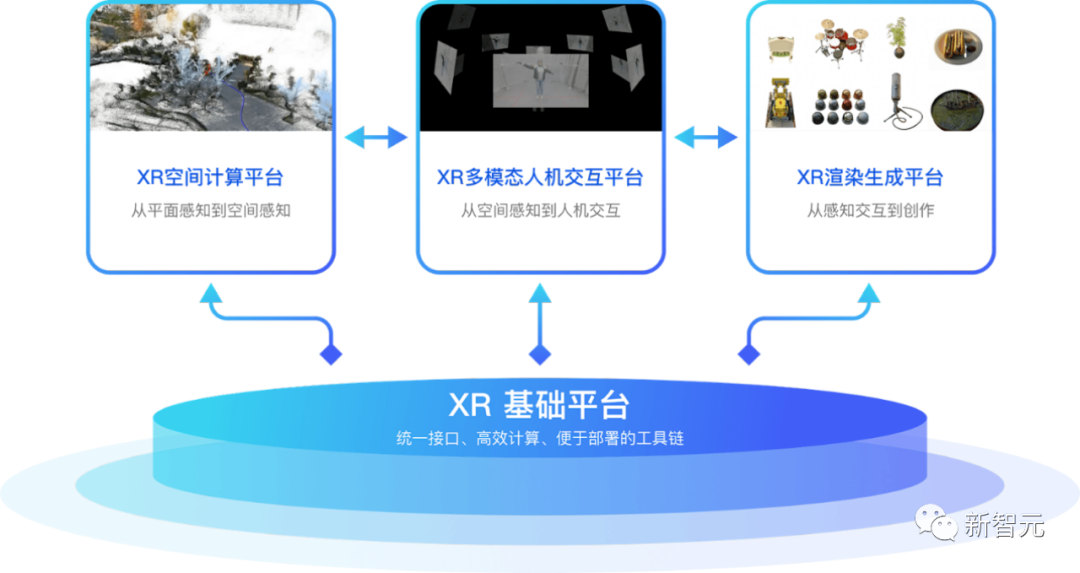
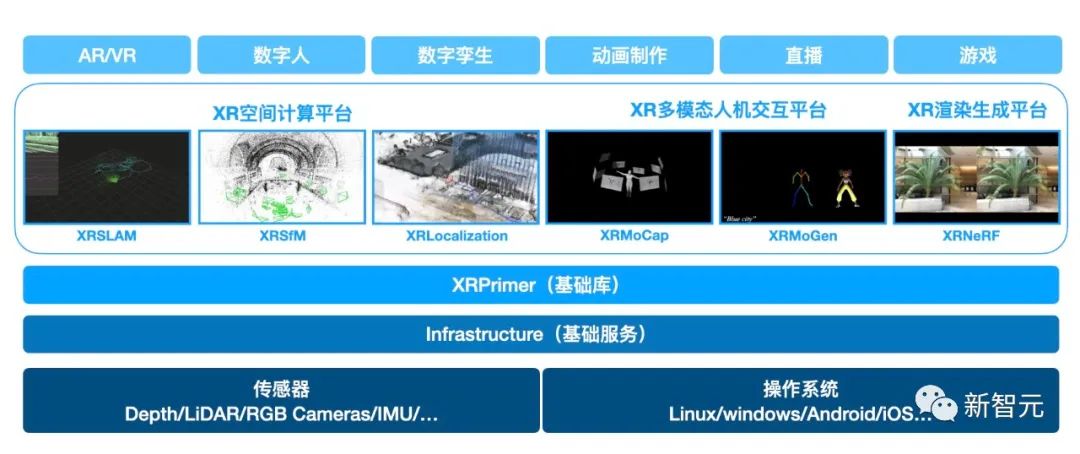
OpenXRlab开源平台可以进一步拆分为以下四个子平台,即1个基础平台和3个应用算法平台。
XR空间计算平台使得我们对世界感知从平面更加走向空间; XR多模态人机交互平台可以成为我们和机器交互的工具; XR渲染生成平台使我们从感知和交互走向创作。
7个代码库
项目地址:https://github.com/openxrlab/xrprimer
XRPrimer是为XR算法提供统一的数据结构和数据处理接口的库。XRPrimer的取名是为了致敬计算机同学们耳熟能详的经典基础书籍《C++ Primer》。
作为基础库,它外层提供统一的数据结构和算法接口,同时支持C/C++和 Python 的调用,内部提供通用的算法和高效的计算,提供扩展,方便外部贡献。
同时,底层的库安装是否方便决定了用户的上手难易度,团队也谨慎选择了XRPrimer的第三方依赖,支持不同平台源码编译,也搭建了配套基础设置提供部分平台预编译库,使得安装更加简单。
XRSLAM
项目地址:https://github.com/openxrlab/xrslam
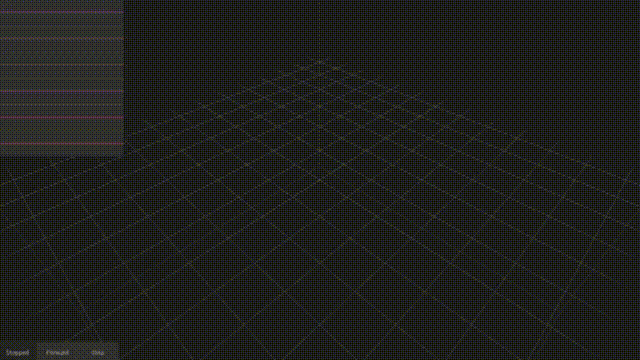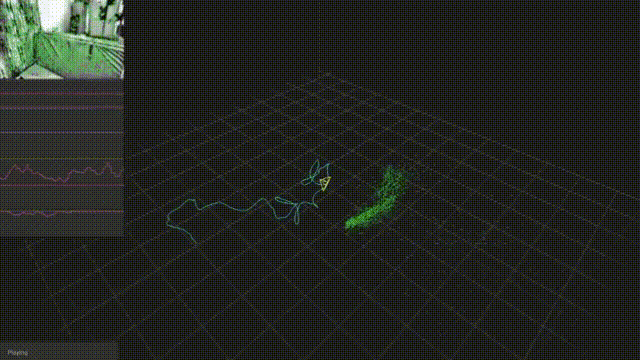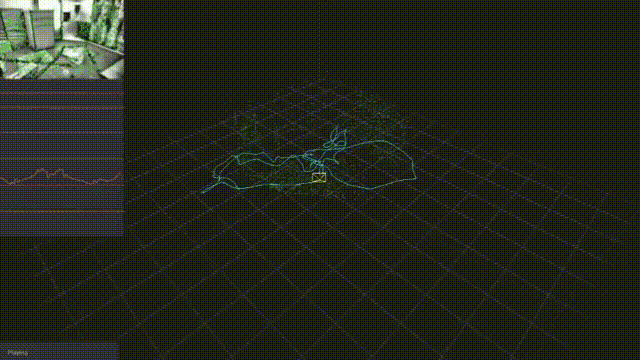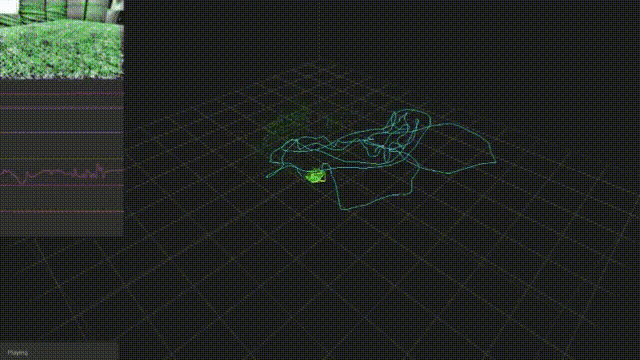
XRSLAM是一个基于多传感器融合的SLAM开源项目,是OpenXRLab空间计算平台的核心技术模块之一。
XRSLAM目前提供了一个基于优化的鲁棒实时的轻量级视觉惯性里程计,同时支持桌面平台和移动平台。
和其他SOTA系统相比,XRSLAM在精度和效率方面都具备很强的竞争力,且非常容易上手使用。作为AR领域的基础设施,团队提供了在iPhone端可实时交互的移动端应用。
基于XRSfM预先构建好的三维几何地图,XRSLAM可以结合XRLocalization实现云-端结合的实时AR定位导航效果。
未来XRSLAM还会持续迭代更新,将会加上全局地图和后端优化形成一个完整的视觉惯性SLAM系统,并且考虑支持双/多目相机和RGB-D相机等更多类型的传感器。
XRSfM
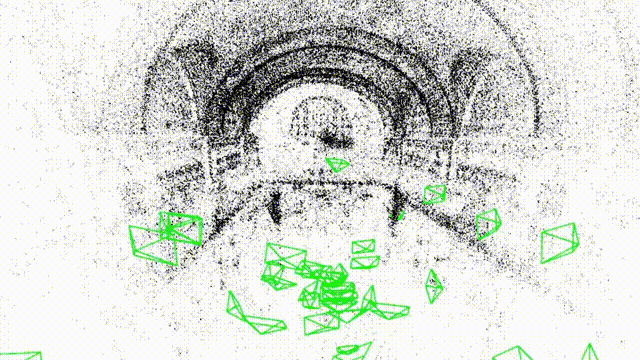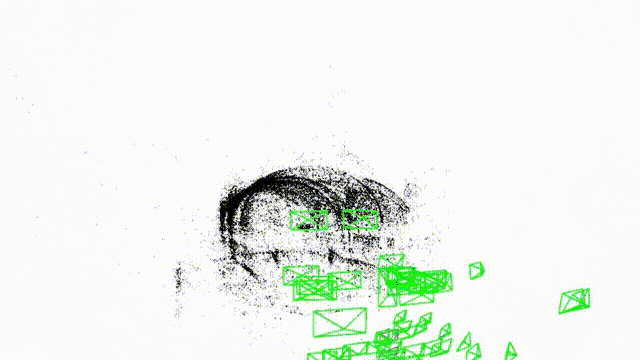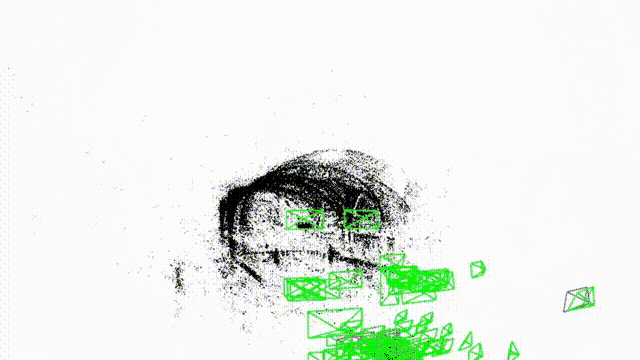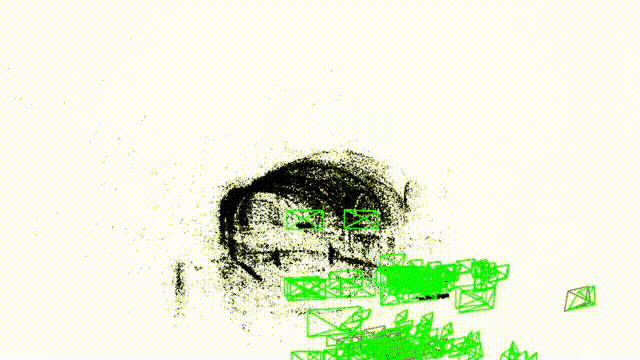
项目地址:https://github.com/openxrlab/xrsfm
XRSfM是一个开源的Structure-from-Motion(运动恢复结构)的代码仓库,属于OpenXRLab空间计算平台。
XRSfM能够从影像数据中恢复场景的稀疏点云结构和图像的相机位姿,重建结果可以支持后续的场景定位和稠密重建。
XRSfM实现了基于共视的高效匹配方法[1]和基于关键帧的高效集束调整,相较于其他开源SOTA系统,其重建速度具有数量级优势,并且提供了基于人工标志物的尺度估计功能,能够恢复出场景的真实尺度。
XRLocalization
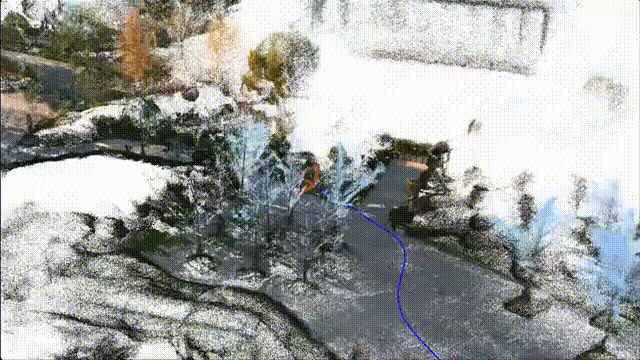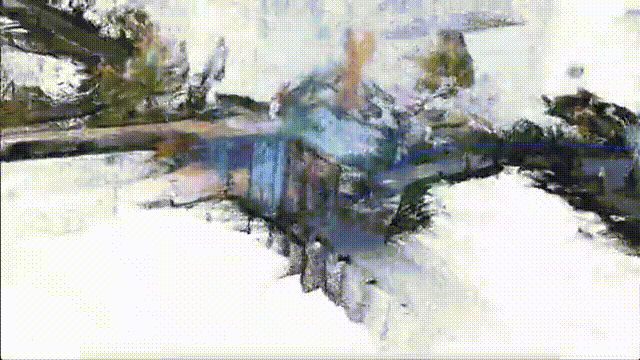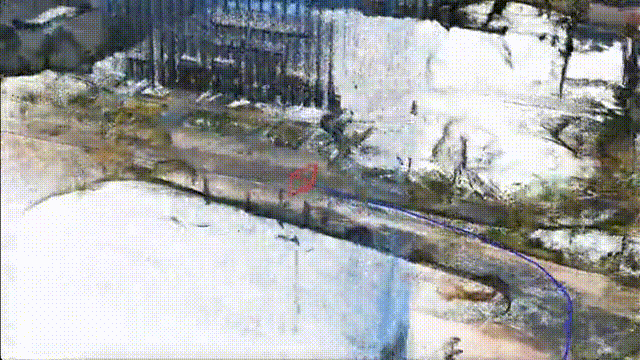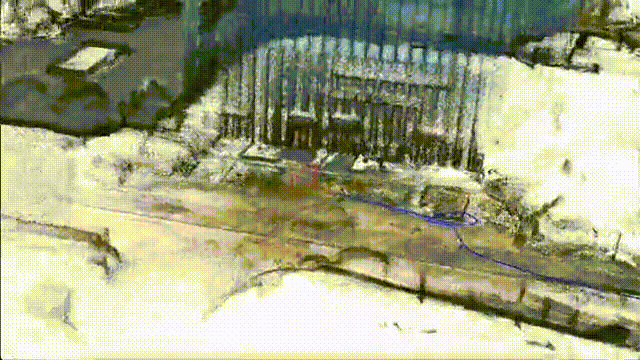
项目地址:https://github.com/openxrlab/xrlocalization
XRLocalization是一个基于高精地图的视觉定位工具箱,属于OpenXRLab空间计算平台。
XRLocalization采用模块化的设计,并提供了一套层次化视觉定位算法,使其能够在大尺度场景下实现高效、精准且鲁棒的定位。
该框架支持使用不同的特征检测、特征匹配和图像检索方法,以及离线和在线两种定位模式。
其中,局部特征目前支持SuperPoint[2]和D2Net[3], 图像检索目前支持NetVLAD[4],特征匹配目前支持最近邻搜索和GAM[5, 6]算法。
该项目将提供更多的基础模块算法以及更多的视觉定位pipeline,为学术研究和工业应用提供灵活的代码工具。
XRMoCap
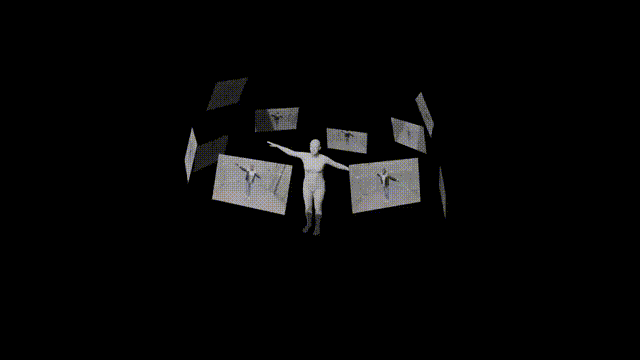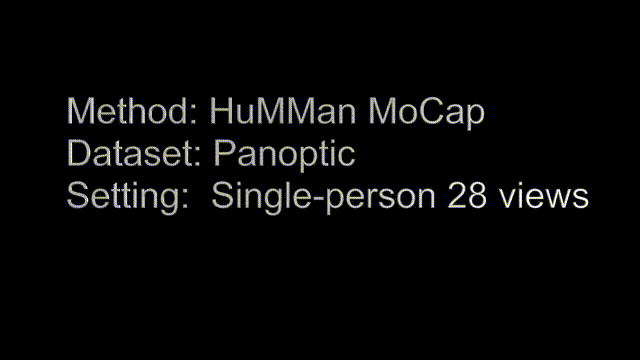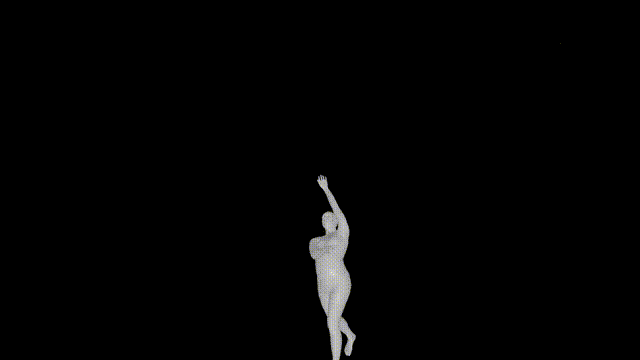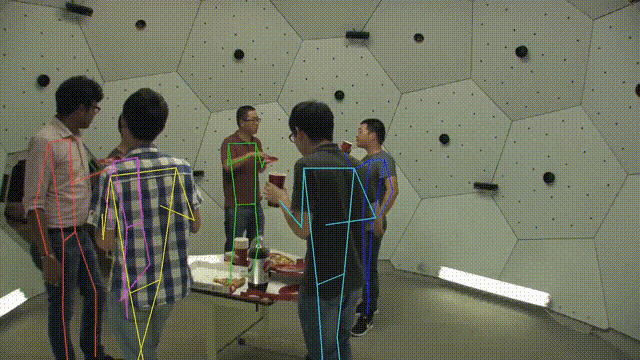
项目地址:https://github.com/openxrlab/xrmocap
XRMoCap是一个多视角的动作捕捉工具箱,属于OpenXRLab多模态人机交互平台。
XRMoCap目前有3大特点:
第一,它同时支持了单人和多人的多目动作捕捉,可以支持大于2个视角的任意数量的标定后相机作为输入,并且提供了一系列高效选择相机和关键点的策略,其中单人工具箱由HuMMan[7]原作者添加。
第二,它同时支持输出3D关键点和人体参数化模型,3D关键点和人体参数化模型是当前人体的2种主流表示形式,也提供了它们互相转换和优化的算法。
第三,它将基于优化和基于学习的算法融入在统一的框架中,支持了MvPose[8], MvPose Tracking[9], MvP[10], 4D Association[11]等多个经典算法。用户可以通过修改配置文件,快速构建和测试一个多视角动作捕捉的算法原型。
XRMoGen
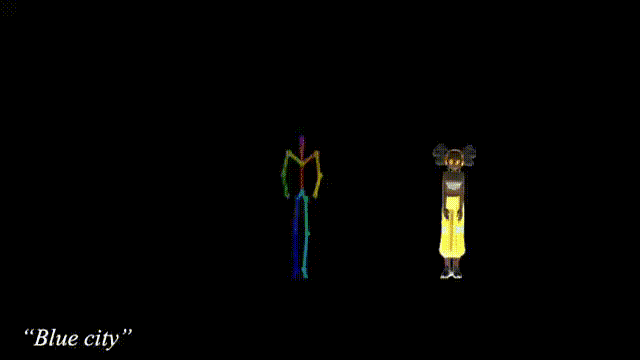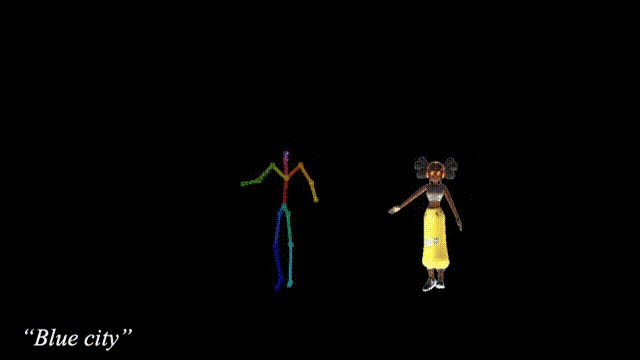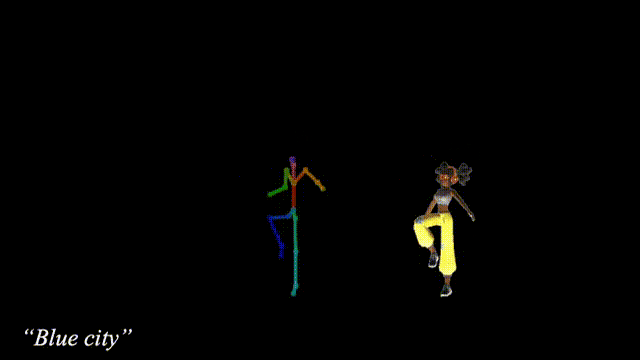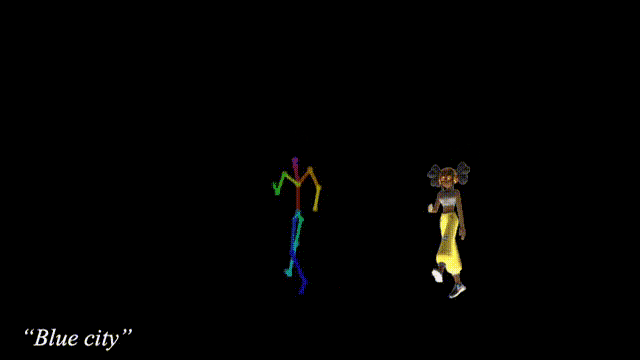
项目地址:https://github.com/openxrlab/xrmogen
XRMoGen是一个多模态人体动作生成的工具箱,属于OpenXRLab多模态人机交互平台。目前,该框架以音乐生成舞蹈为切入点,构建人体动作生成代码库。
XRMoGen的亮点有3个:
第一个是代码结构清晰,易读性高,提供了较为详细的使用文档。
第二个是框架容易上手。由于动作生成代码库相对比较繁杂,XRMoGen试图将不同算法的代码风格统一到一个框架下,实现对算法的抽象,达到用户易上手易扩展的目的。
第三个是复现了该领域的2个经典算法:DanceRevolution[12]和Bailando[13]。其中Bailando[13]由原作者添加,不仅效果与SOTA相当,代码结构也更加清晰易拓展。
XRNeRF
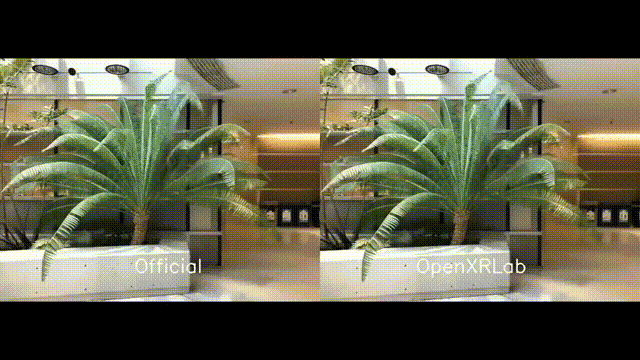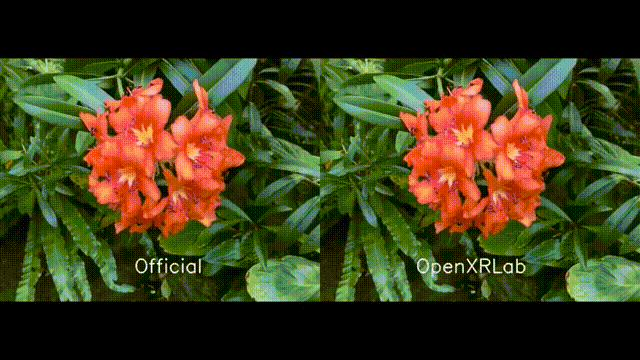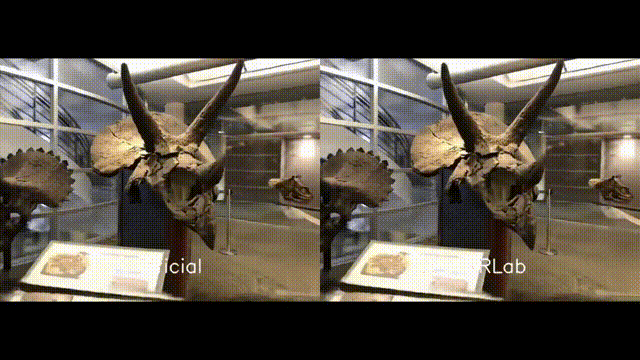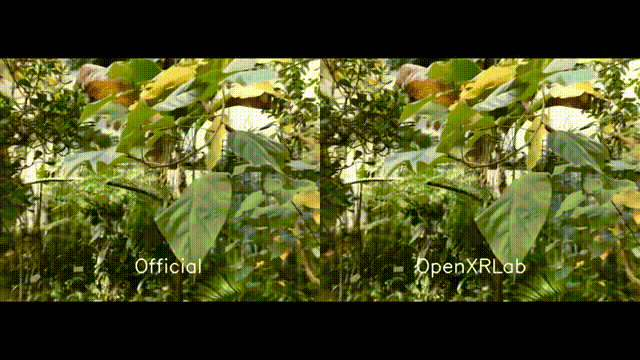
项目地址:https://github.com/openxrlab/xrnerf
XRNeRF是基于PyTorch的通用型模块化神经渲染框架,属于OpenXRLab渲染生成平台。
XRNeRF集成了4个面向场景和3个面向人体的NeRF前沿算法,其中场景算法包括NeRF[14], Mip-NeRF[15], KiloNeRF[16]和Instance-NGP[17],人体算法包括NeuralBody[18], AnimNeRF[19]和GNR[20],人体算法均为原作者支持开发。
针对当前开源NeRF代码库线性流程、模块化程度低、二次开发难度大的问题,XRNeRF具有如下特点:模块化程度高、标准的数据处理管线、模块化的网络构建方法。
仅需要修改配置文件,就可以完成对数据处理管线和网络构建的修改,支持高便捷性地实现新算法搭建。
除了易于使用和拓展的模块化设计,XRNeRF在所有复现算法上,平均指标与官方代码库对齐,可视化效果也与源代码库对齐。
从1到N
XR的各种硬件正在高速发展,新算法也层出不穷。对算法的研究者和开发者来说,保持高度热度的同时,未来还有大量的工作需要完成。
OpenXRLab的开源只是迈出了一小步,这个领域的发展道阻且长。非常欢迎更多有热情的社区小伙伴加入进来,一同成为这个方向的贡献者!
团队表示,欢迎任何形式的贡献,可以在wishlist中添加想要复现的算法,可以在issue中报告问题,也可以PR提交修改,甚至还可以加入他们。
代码库地址:https://github.com/openxrlab
参考文献:
[1] Ye, Z., Zhang, G., & Bao, H. (2020, May). Efficient covisibility-based image matching for large-scale SfM. In 2020 IEEE International Conference on Robotics and Automation (ICRA) (pp. 8616-8622). IEEE.
[2] DeTone, D., Malisiewicz, T., & Rabinovich, A. (2018). Superpoint: Self-supervised interest point detection and description. In Proceedings of the IEEE conference on computer vision and pattern recognition workshops (pp. 224-236).
[3] Dusmanu, M., Rocco, I., Pajdla, T., Pollefeys, M., Sivic, J., Torii, A., & Sattler, T. (2019). D2-net: A trainable CNN for joint detection and description of local features. arXiv preprint arXiv:1905.03561.
[4] Arandjelovic, R., Gronat, P., Torii, A., Pajdla, T., & Sivic, J. (2016). NetVLAD: CNN architecture for weakly supervised place recognition. In Proceedings of the IEEE conference on computer vision and pattern recognition (pp. 5297-5307).
[5] Yu, H., Ye, W., Feng, Y., Bao, H., & Zhang, G. (2020, November). Learning bipartite graph matching for robust visual localization. In 2020 IEEE International Symposium on Mixed and Augmented Reality (ISMAR) (pp. 146-155). IEEE.
[6] Yu, H., Feng, Y., Ye, W., Jiang, M., Bao, H., & Zhang, G (2022). Improving feature-based visual localization by geometry-aided matching. ArXiv preprint arXiv:2211.08712.
[7] Cai, Z., Ren, D., Zeng, A., Lin, Z., Yu, T., Wang, W., ... & Liu, Z. (2022). HuMMan: multi-modal 4D human dataset for versatile sensing and modeling. In European Conference on Computer Vision. Springer, Cham.
[8] Dong, J., Jiang, W., Huang, Q., Bao, H., & Zhou, X. (2019). Fast and robust multi-person 3D pose estimation from multiple views. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 7792-7801).
[9] Dong, J., Fang, Q., Jiang, W., Yang, Y., Huang, Q., Bao, H., & Zhou, X. (2021). Fast and robust multi-person 3d pose estimation and tracking from multiple views. IEEE Transactions on Pattern Analysis and Machine Intelligence.
[10] Zhang, J., Cai, Y., Yan, S., & Feng, J. (2021). Direct multi-view multi-person 3d pose estimation. Advances in Neural Information Processing Systems, 34, 13153-13164.
[11] Zhang, Y., An, L., Yu, T., Li, X., Li, K., & Liu, Y. (2020). 4D association graph for realtime multi-person motion capture using multiple video cameras. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition (pp. 1324-1333).
[12] Huang, R., Hu, H., Wu, W., Sawada, K., Zhang, M., & Jiang, D. (2020). Dance revolution: Long-term dance generation with music via curriculum learning. arXiv preprint arXiv:2006.06119.
[13] Siyao, L., Yu, W., Gu, T., Lin, C., Wang, Q., Qian, C., ... & Liu, Z. (2022). Bailando: 3D dance generation by actor-critic GPT with choreographic memory. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 11050-11059).
[14] Mildenhall, B., Srinivasan, P. P., Tancik, M., Barron, J. T., Ramamoorthi, R., & Ng, R. (2021). NeRF: Representing scenes as neural radiance fields for view synthesis. Communications of the ACM, 65(1), 99-106.
[15] Barron, J. T., Mildenhall, B., Tancik, M., Hedman, P., Martin-Brualla, R., & Srinivasan, P. P. (2021). Mip-NeRF: A multiscale representation for anti-aliasing neural radiance fields. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 5855-5864).
[16] Reiser, C., Peng, S., Liao, Y., & Geiger, A. (2021). Kilonerf: Speeding up neural radiance fields with thousands of tiny mlps. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 14335-14345).
[17] Müller, T., Evans, A., Schied, C., & Keller, A. (2022). Instant neural graphics primitives with a multiresolution hash encoding. arXiv preprint arXiv:2201.05989.
[18] Peng, S., Zhang, Y., Xu, Y., Wang, Q., Shuai, Q., Bao, H., & Zhou, X. (2021). Neural body: Implicit neural representations with structured latent codes for novel view synthesis of dynamic humans. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 9054-9063).
[19] Peng, S., Dong, J., Wang, Q., Zhang, S., Shuai, Q., Zhou, X., & Bao, H. (2021). Animatable neural radiance fields for modeling dynamic human bodies. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 14314-14323).
[20] Cheng, W., Xu, S., Piao, J., Qian, C., Wu, W., Lin, K. Y., & Li, H. (2022). Generalizable Neural Performer: Learning Robust Radiance Fields for Human Novel View Synthesis. arXiv preprint arXiv:2204.11798.
-
阅读原文
* 文章为作者独立观点,不代表数艺网立场转载须知
- 本内容由数艺网主动采集收录,信息来源为 “新智元” 公开网络发布内容。第三方如需转载本内容,必须完整标注原作者信息及 “来源:数艺网”,严禁擅自篡改、删减或未标注来源转载。 并附上本页链接: 若您的内容不希望被数艺网收录,或认为此举侵犯了您的合法权益,敬请通过微信 ID:d-arts-cn 联系数艺网。我们将致以诚挚歉意,并第一时间为您办理下架或删除处理。
-
-
北京
甲方 · 媒体平台
未认证的机构号
最近发布
-
2025-08-13
-
2025-07-18