【新智元导读】很多AI玩扑克不行,是因为它们不会像人类一样「玩心眼」。而DeepMind最新的DeepNash,唬起人来可是一套一套的。
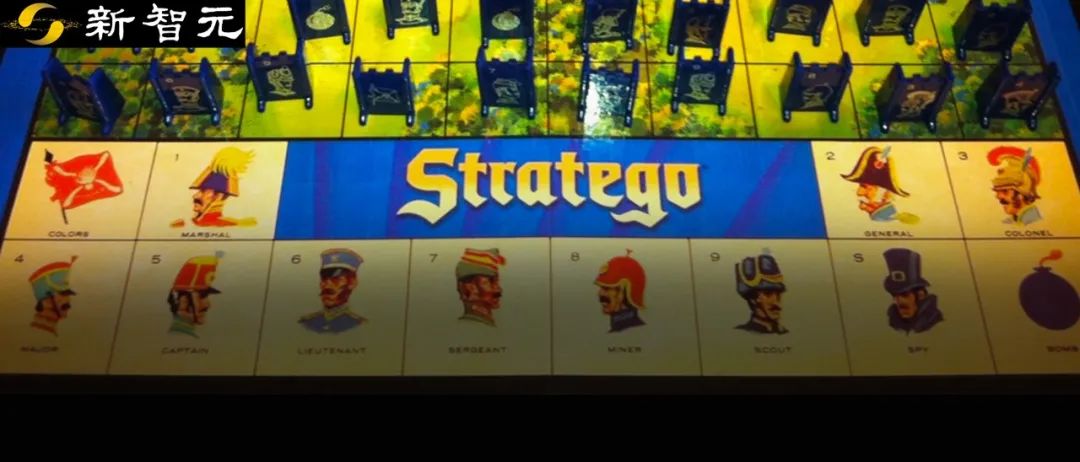
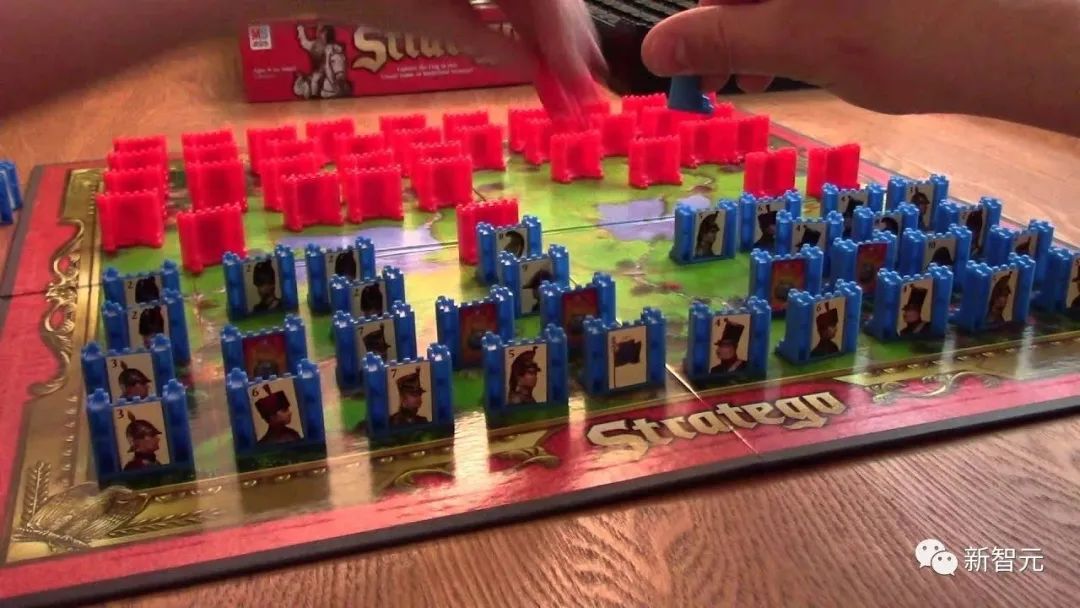
近日,DeepMind的AI智能体DeepNash,在西洋陆军棋(Stratego)中花式战胜专业级人类玩家,成功跻身Top 3。
论文地址:http://www.science.org/doi/10.1126/science.add4679
在如今这个时代,玩游戏的AI已经发展到一个全新的阶段。
以往,许多科学家会用国际象棋和围棋训练AI,而DeepMind这次用的Stratego,是一款经典的棋盘游戏,要比国际象棋和围棋更复杂,比扑克更巧妙。而这个名为DeepNash的AI智能体,通过与自己对战的方式,从零开始学习Stratego。现在,DeepNash在世界上最大的在线Stratego平台Gravon的人类专家中,排名历史前三。DeepNash采用的是一种全新的打法,理论依据是博弈论和无模型深度强化学习。看得出来,这个名字也意在致敬著名的美国数学家约翰·纳什(John Nash)。他提出的纳什均衡(Nash equilibrium),又称为非合作博弈均衡,是博弈论中非常重要的一环。
历来,棋盘游戏就一直是衡量AI进步的标准,因为它能够使我们研究人类和机器如何在受控环境中,制定和执行策略。
与国际象棋和围棋的不同之处在于,Stratego是一种不完全信息博弈:玩家无法直接观察对手棋子的身份。因为这种复杂性,基于AI的Stratego系统,往往再努力,也就是业余水平,不可能达到「专家」的水准。在以往,各种AI之所以在游戏中大获全胜、完爆人类,是因为一种叫「博弈树搜索」的AI技术。「博弈树搜索」虽然可以在充分掌握信息的各种游戏中大杀四方,但对于Stratego这样的游戏,却有些束手无策,因为它的可扩展性不够。而在这一点上,DeepNash就完爆了博弈树搜索。实际上,DeepNash掌握了Stratego的价值,已经远远超越了这个游戏本身。现实世界往往就是很复杂,信息是有限的。真正先进的AI系统,所面临的环境就如同Stratego这样。DeepNash成功地向我们展示了,AI如何在不确定的情况下,成功地平衡了结果,解决了复杂的问题。Stratego怎么玩
Stratego是一款回合制夺旗游戏。游戏中,玩家需要虚张声势,迂回战术,收集信息,巧妙地操作。
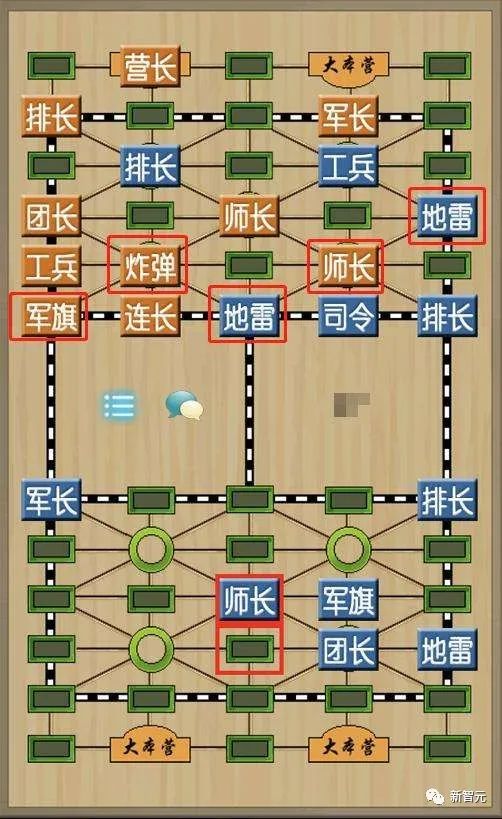
它是一款零和博弈,所以一个玩家的任何收益,都代表着对手同等数量的损失。Stratego与军棋的不同之处在于,它有更多数量的棋子、更多的军衔较多,棋盘设计较简单,没有铁路、行营和裁判。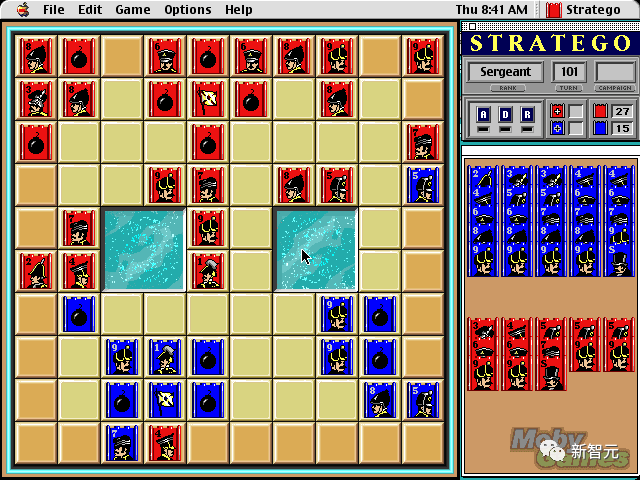
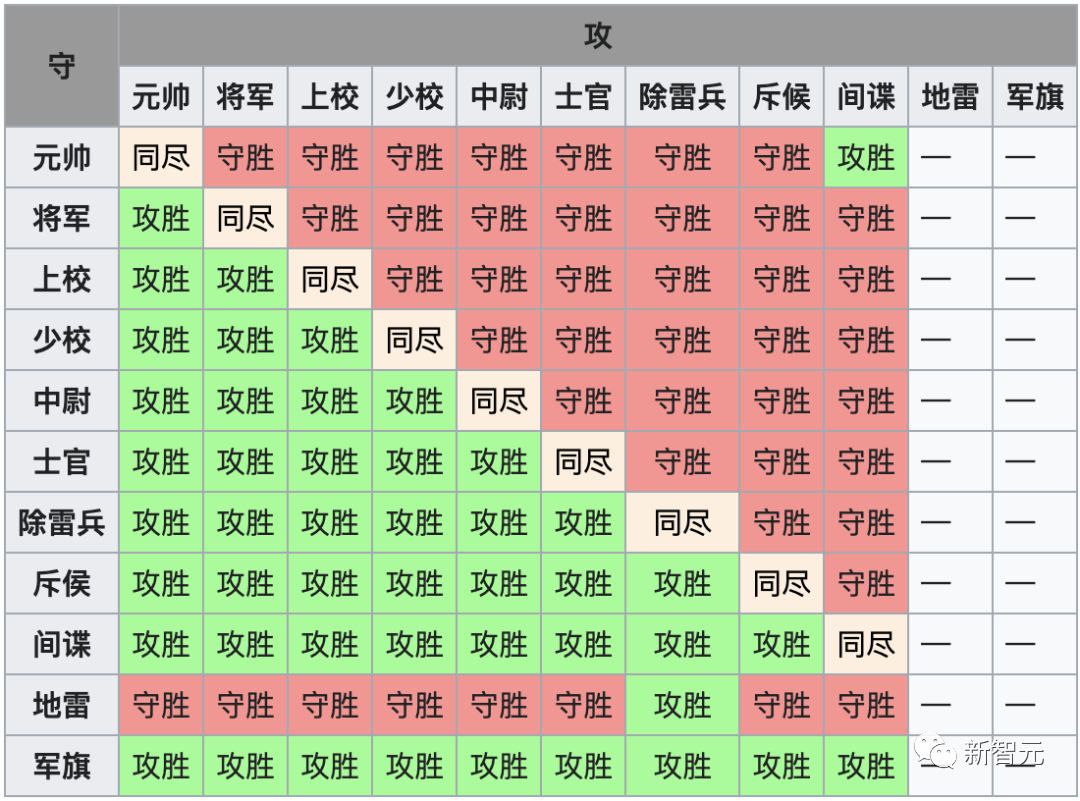
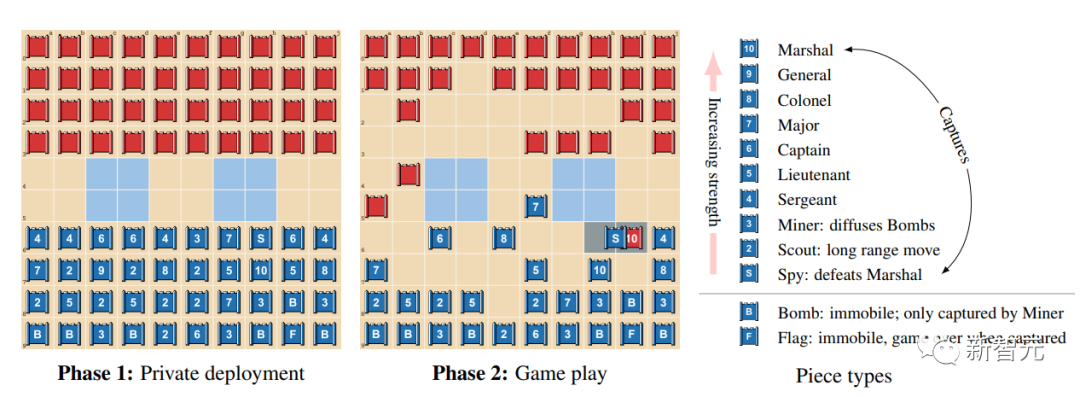
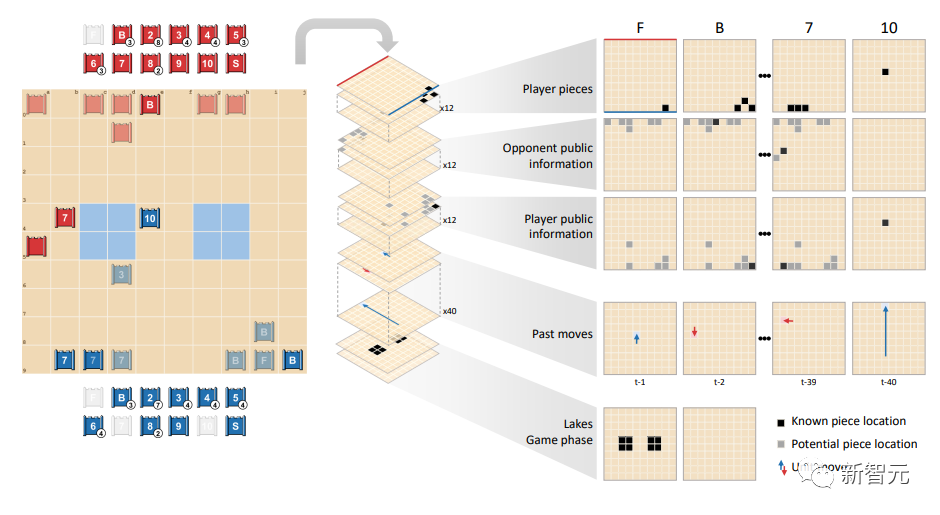
布阵完成之后,由红方先走棋,随后轮流移动一枚棋子。棋子中,军旗和地雷不能移动,侦察兵可以横竖移动任意格,不可越过棋子,其余棋子只能横竖走一格。当双方棋子在同一格内,就一同揭开,判断大小,胜的棋子放回原位、正面朝后,输的棋子就被移除。Stratego胜利方式与中国军棋类似,以夺得对方军旗或消灭所有能动的棋子为胜利。为什么Stratego对于AI这么有挑战性?部分原因在于,它是一种不完全信息博弈。Stratego中的两位玩家,在把40个棋子排成起始阵型时,是彼此隐藏的。因为玩家无法获得相同的知识,因此在做出任何决定时,他们都需要平衡所有可能的结果。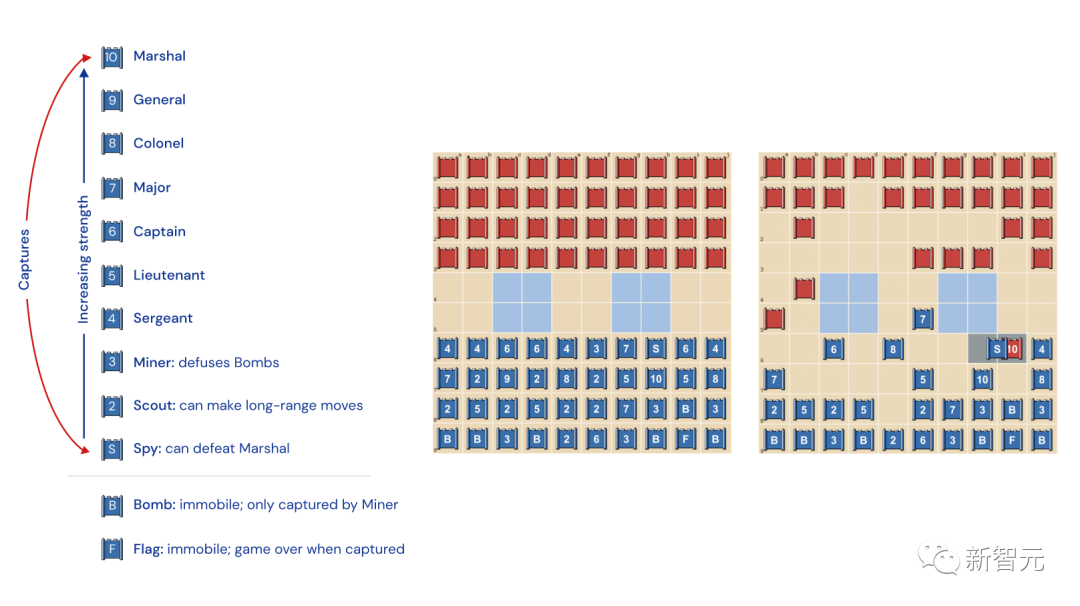 Stratego棋子的种类和排名
左:棋子排名。在游戏中,军衔较高的棋子获胜,唯一的例外是10(元帅)被间谍攻击;炸弹总是获胜,唯一的例外是被矿工捕获。中间:可能的起始阵型。旗帜要安全地藏在后面,两侧的炸弹提供保护。两个淡蓝色区域是「湖泊」,永远不能进入。右:一盘正在进行的游戏,可以看到,蓝方的间谍捕获了红方的元帅。
而国际象棋和围棋的不同之处在于,它们是「完美信息博弈」,因为对战双方确切地知道每一颗棋子的位置和身份。DeepMind的AlphaZero,在完美信息博弈中表现一向出色,但在Stratego中,它却被难倒了。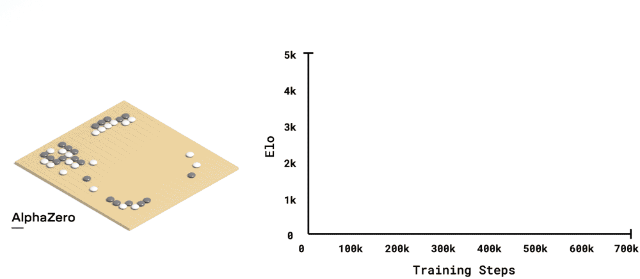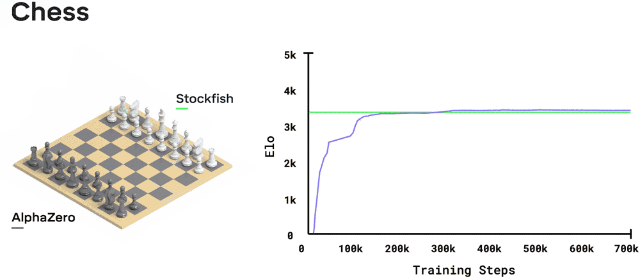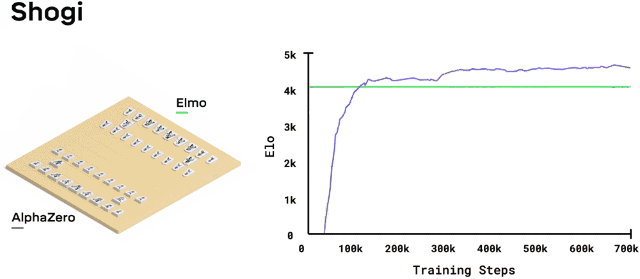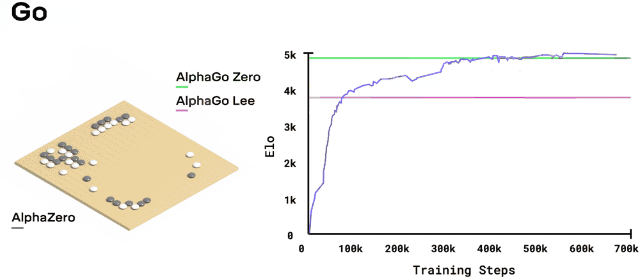 在国际象棋中,AlphaZero在4小时后就超越了Stockfish;在将棋中,AlphaZero在2小时后超越了Elmo;而围棋中,AlphaZero在30小时后超越了击败李世石的AlphaGoStratego更类似于德州扑克,需要类似人类的能力——人类需要在信息不全的情况下做出决定,还需要虚张声势。美国作家杰克伦敦曾经指出:「生活中,我们并不总是持有好牌,但有时,一手烂牌也能打得很好。」其实很多AI也很擅长打德扑,但它们面对Stratego时,却懵逼了——这个游戏的流程实在是太长了!玩家要获胜,需要走出数百步。所以游戏中的推理,必须针对大量的连续动作,在这个过程中,很难明显看出每个动作对于最终结果会有怎样的影响。
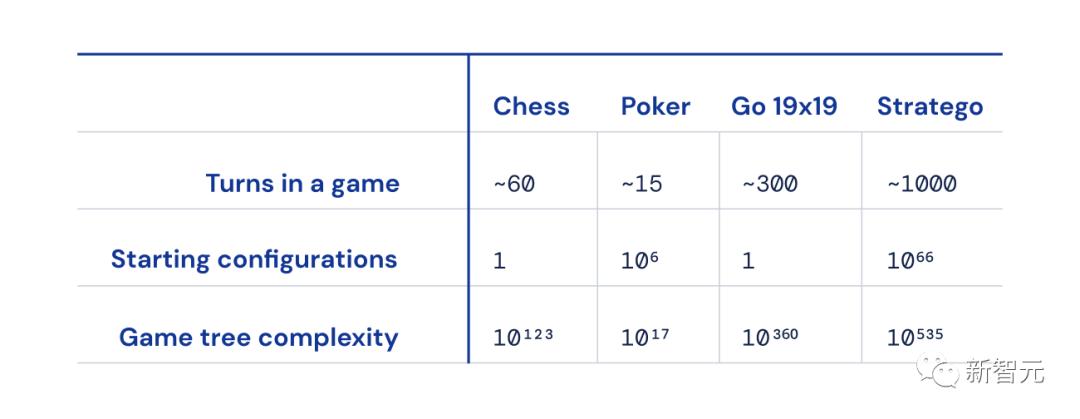 国际象棋、扑克、围棋和Strateg之间的规模差异
而且,与国际象棋、围棋和扑克牌相比,可能的博弈状态数量(「博弈树复杂性」)已经超出了图表,解决起来更是异常困难。而这,也正是Stratego令人如此兴奋的原因——它代表了AI社区长达数十年的挑战。
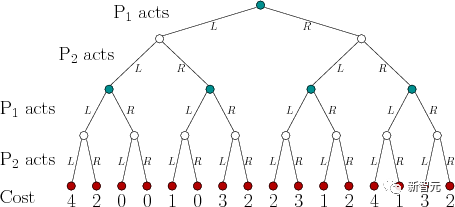
多年来,如何让人工智能在Stratego游戏中脱颖而出,成为AI研究者的重点。首先,该游戏的博弈树有10的535次方种状态,即一局游戏中会有10的535次方种可能的布局。相比之下,围棋的布局也只有10的360次方种可能。
其次,在Stratego中,人工智能需要推理对手超过10的66次方种部署策略,而扑克只有一千种可能出现的牌对。因此,想要破解Stratego纷繁复杂的布局并非易事,如何战胜人类Stratego玩家,是AI研究者面对的前所未有的挑战。
DeepNash之所以完爆其他AI,是因为它采用了一种基于博弈论和无模型深度强化学习相结合的新颖方法。
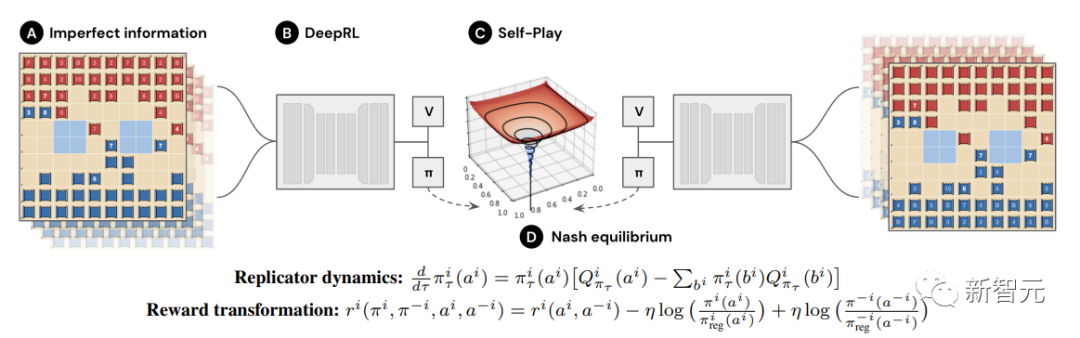
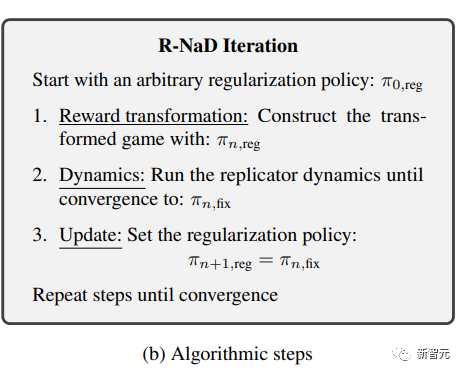
「无模型」就意味着,DeepNash并没有试图在游戏中明确地模拟对手的状态。尤其是在博弈的早期阶段,当DeepNash对对手的棋子知之甚少时,这种建模即使可能完成,大概率也是无效的。而且,由于Stratego的博弈树复杂性如此之大,DeepNash无法采用其他AI在玩游戏时用的蒙特卡洛树搜索。后者正是AI在不太复杂的棋盘游戏和扑克中,取得里程碑式成就的关键。可见,均衡策略虽然可以在对局双方轮流行动的完全信息博弈中发挥作用,但它在不完全信息博弈中就显得力不从心。DeepNash采用的,是一种新的博弈论算法思想——正则化纳什动态规划(Regularized Nash Dynamic,R-NaD)。这个无模型的强化学习算法,是DeepNash的核心。它引导着DeepNash,让它的学习行为朝着纳什均衡的方向发展。DeepNash将R-NaD与深度神经网络架构相结合,并收敛到纳什均衡。包括三步:奖励转换(reward transformation)、动态规划(dynamics)和更新迭代(udate)。研究团队通过重复应用这三个步骤,直到生成一系列固定点用以证明算法收敛到原始博弈的纳什均衡。对战最强的Stratego机器人(包括计算机战略世界锦标赛的几位获胜者)时,DeepNash的胜率高达97%,经常取得100%的胜率。而在Gravon游戏平台上,对抗顶级的人类玩家时,DeepNash取得了84%的胜率,赢得了历史前三的排名。当然,在对局中不能无限制地通过博弈论达到纳什均衡,因为这种方式下玩家的胜率无法保证。均衡策略只在完全信息博弈下充分适用,在不完全信息的游戏下,还需要别的策略才能出奇制胜。在初始的排兵布阵上,DeepNash就采用了一些非凡的玩法。为了变得难以利用(hard to exploit),DeepNash制定了一种不可预测的策略(unpredictable strategy)。这意味着在初期的部署上,就要足够多变,防止对手在随后的一系列对阵中,发现自己的模式。而在博弈阶段,DeepNash也会在看似相同的动作之间,尽量地随机化(randomise),来防止自己变得可利用。
现实场景下,人们还会用其他手段来取得胜利,如诈唬(bluffing)。正如「博弈论之父」冯·诺伊曼所描述的那样:「现实生活中充满『虚张声势』、『欺骗的小伎俩』以及『猜测别人会认为我打算做什么』。」
陶哲轩的「红眼睛与蓝眼睛自杀难题」:我知道,我知道他知道,我知道他知道他知道……
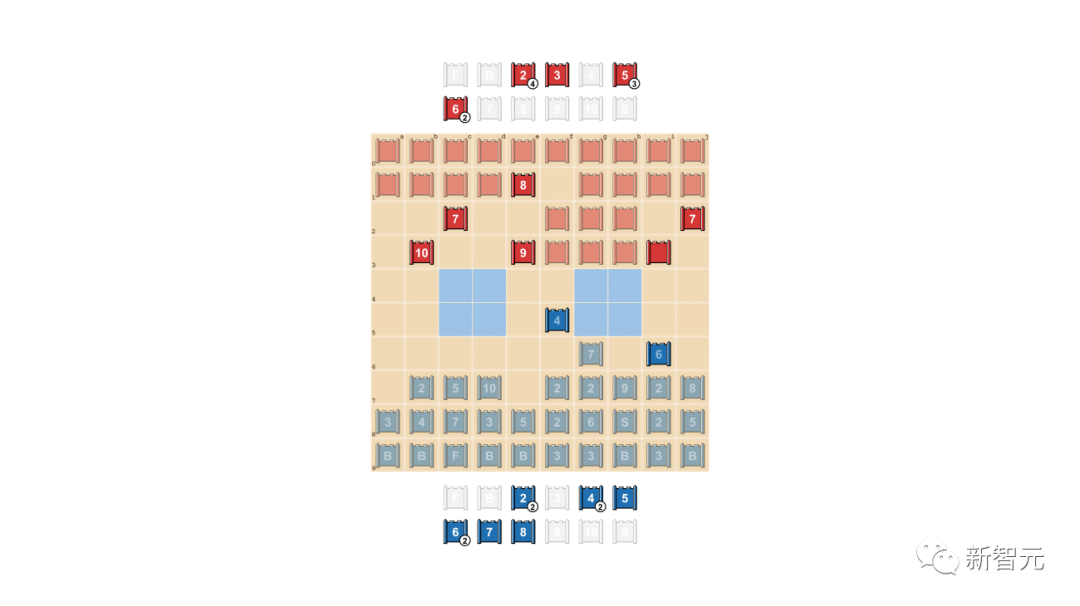
研究团队展示了DeepNash的两种唬人技巧:主动诈唬(positive bluffing)与被动诈唬(negative bluffing)。所谓主动诈唬,就是假装自己的棋子等级很高,威慑对手。简单来说就是「虚张声势」。在这个例子中,DeepNash就给我们好好地上了一课:在对战人类玩家(红方)时,DeepNash(蓝方)在游戏初期以牺牲了 7(少校)和 8(上校)等棋子的代价,找出了对手的 10(元帅), 9(将军),一个8和两个7。至此,DeepNash(蓝方)就找到对手的许多最强大的棋子,同时,将自己的关键棋子隐藏起来。乍一看,DeepNash似乎处于明显劣势:它的7和8 out 了,但人类对手保留了排名7及以上的所有棋子。但是,DeepNash笑到了最后——凭借着自己探得的对方高层的可靠情况,它估算自己的获胜几率为70%。虚张声势的「艺术」
在扑克中,优秀的玩家会玩心理战,即使在我方弱势的情况下,也要让对方形成威慑。DeepNash也学会了这种虚张声势的策略——被动诈唬(negative bluffing)。也就是我们常说的「扮猪吃老虎」:将自己等级高的棋子伪装成等级低的棋子,等到对方上当后再一举拿下。在下面这个例子中,DeepNash使用2(很弱是侦察兵)去追击对手暴露身份的8。人类对手据此判断,追击者很可能是10,因此尝试引诱它进入间谍的伏击圈。最终,DeepNash成功地以小博大,用小棋子2成功地灭掉了对手的关键棋子间谍。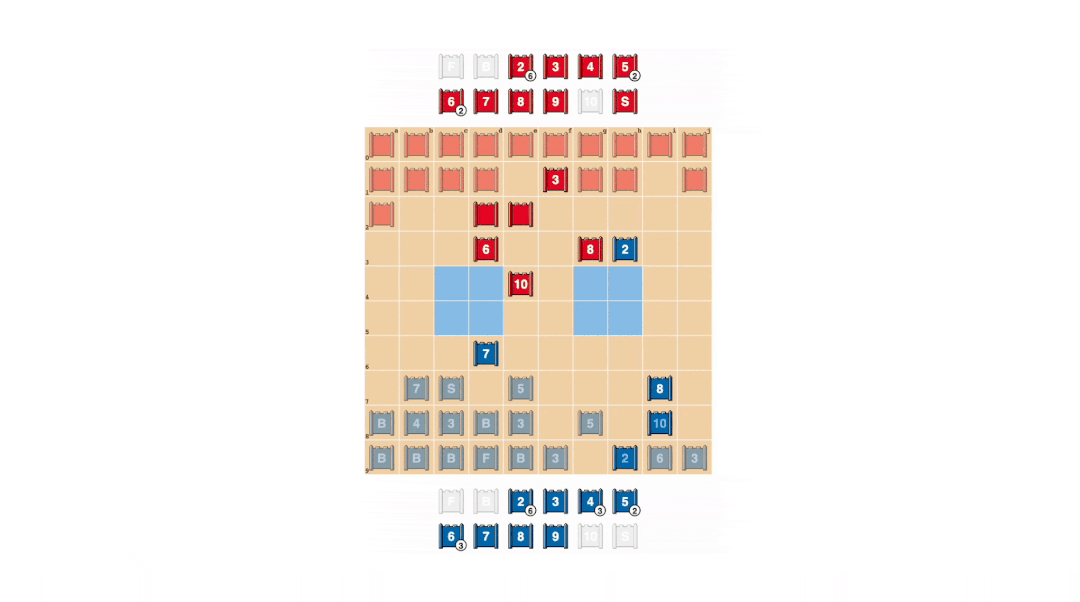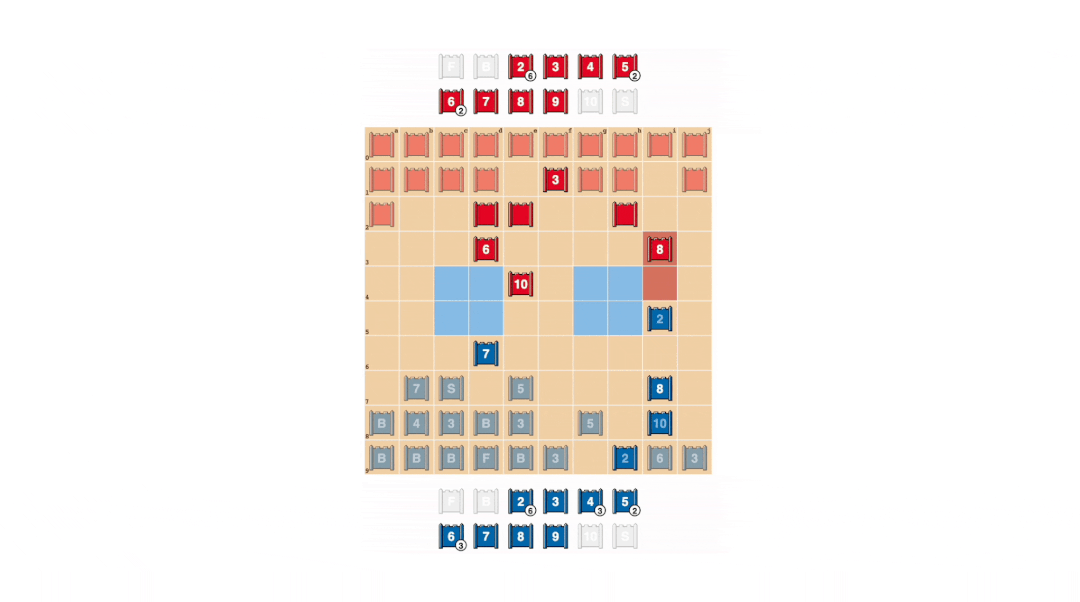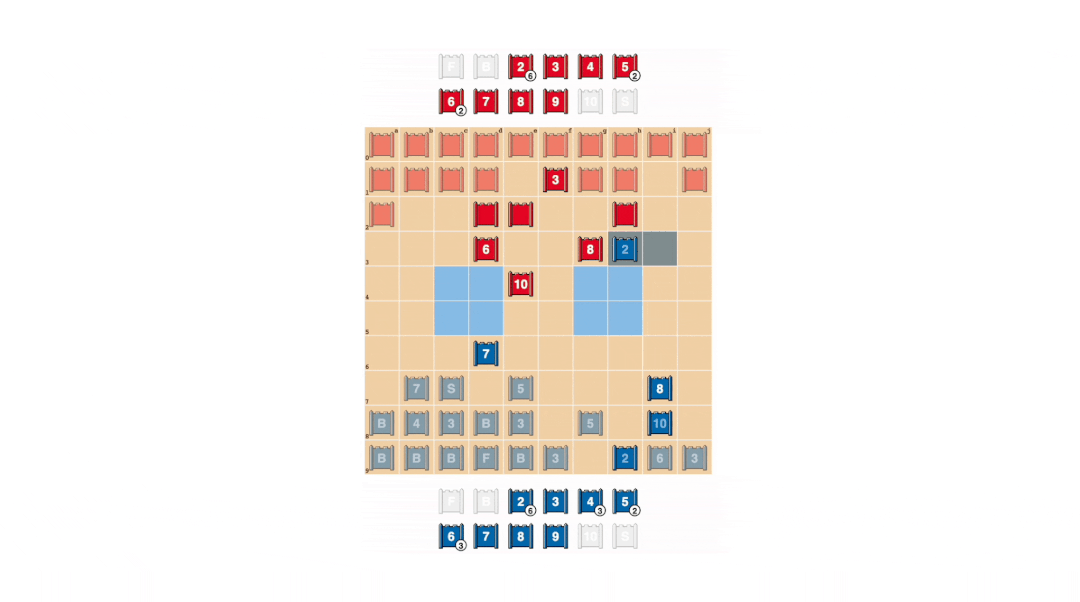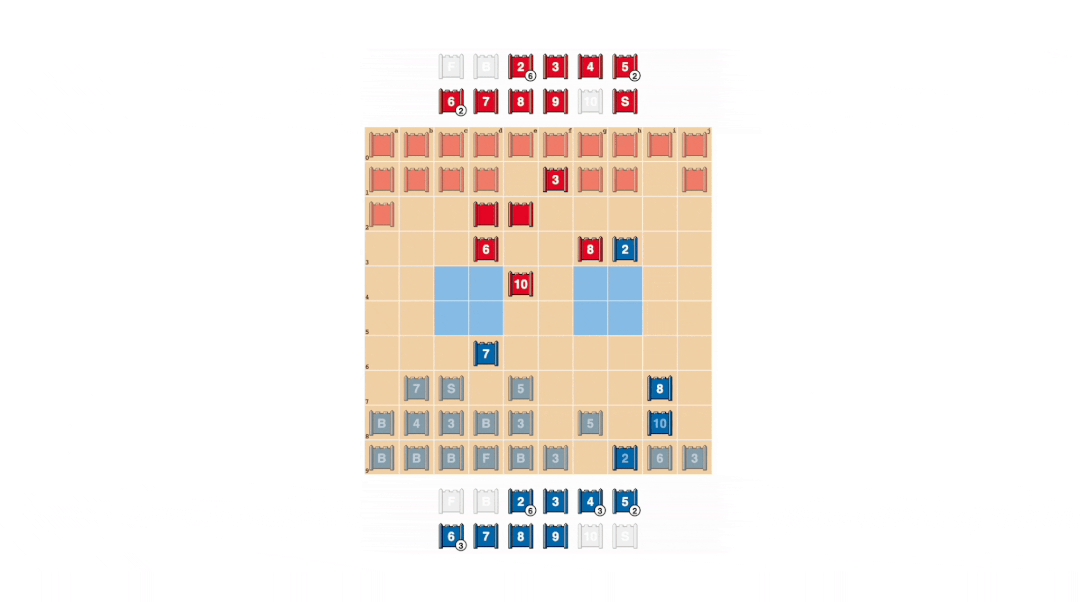 人类玩家(红方)确信追逐自己的8的未知棋子一定是 DeepNash 的 10(因为此时DeepNash已经输掉了自己唯一的9以下是DeepNash与(匿名)人类专家进行的这四个完整游戏视频,第 1场、第 2场、第 3场、第 4 场,点击进去,你会收获更多的惊喜。(视频地址在引用素材中列出)
DeepNash的游戏水平让我感到惊讶。我从未听说过,有哪个人造Stratego玩家的水平,能接近赢得人类玩家所需的水平。但亲自与DeepNash交手后,我对它在Gravon上取得前3的排名并不惊讶。我预测:如果让它参加人类的世界锦标赛,它会做得很好。——Vincent de Boer,论文合著者,前Stratego世界冠军
可以看到,DeepMind的这种新颖的R-NaD方法,可以直接应用于完美或不完美信息的其他双人零和博弈。R-NaD有潜力超越双人游戏的设定,解决大规模的现实世界问题。此外,R-NaD还有望在其他不同目标的领域,解锁AI的新应用。比如在交通管理的规模优化中,人们不清楚他人的意图或环境信息,此时R-NaD有望优化司机的出行时间。
而现在,人们创建了一个面对不确定性时具有鲁棒性的通用AI系统,这让我们对于人类的未来充满了想象。http://www.science.org/doi/10.1126/science.add4679https://www.nature.com/articles/d41586-022-04246-7https://www.deepmind.com/blog/mastering-stratego-the-classic-game-of-imperfect-informationhttps://youtu.be/HaUdWoSMjSYhttps://youtu.be/L-9ZXmyNKgshttps://youtu.be/EOalLpAfDSshttps://youtu.be/MhNoYl_g8mo