ChatGPT 军备赛开幕,哪些国内机构具备打造下一个 ChatGPT 的实力?
自从 2022 年底 ChatGPT 发布以来,海内外就掀起了一阵狂潮。推出仅两个月,ChatGPT 月活用户突破 1 亿,成为了史上用户增长速度最快的消费级应用程序。ChatGPT 成为了搅动人工智能领域风云的新势力,其背后的 OpenAI 也因此成为了当下最热门的 AI 公司,甚至引发了科技巨头们的深度焦虑。谷歌和微软两家科技巨头正在 ChatGPT 搜索上进行激烈竞争,先后宣布了将大型语言模型(LLM)整合到 Google 和 Bing 搜索中的计划。更有众多互联网公司迅速跟进,掀起了科技领域的又一场「军备竞赛」。有些机构开始着手研究同类型产品,有些机构从零开始布局对话式 AI 背后的一系列相关技术。中国版 ChatGPT 将诞生于何处,也成为了大众最关心的问题之一。鉴于 ChatGPT 是多项 AI 技术的集大成者,远非「一日之功」。这背后离不开算力、数据、人才等资源的支持。环顾国内群雄,谁最有可能造出下一个 ChatGPT?在这篇文章中,机器之心将盘点国内最具实力的一批学术型机构和 NLP 研究领域带头人,共分为高校、大厂、非营利研究机构、初创公司四个部分,供大家参考、讨论。如有盘点错误的地方,欢迎指正。
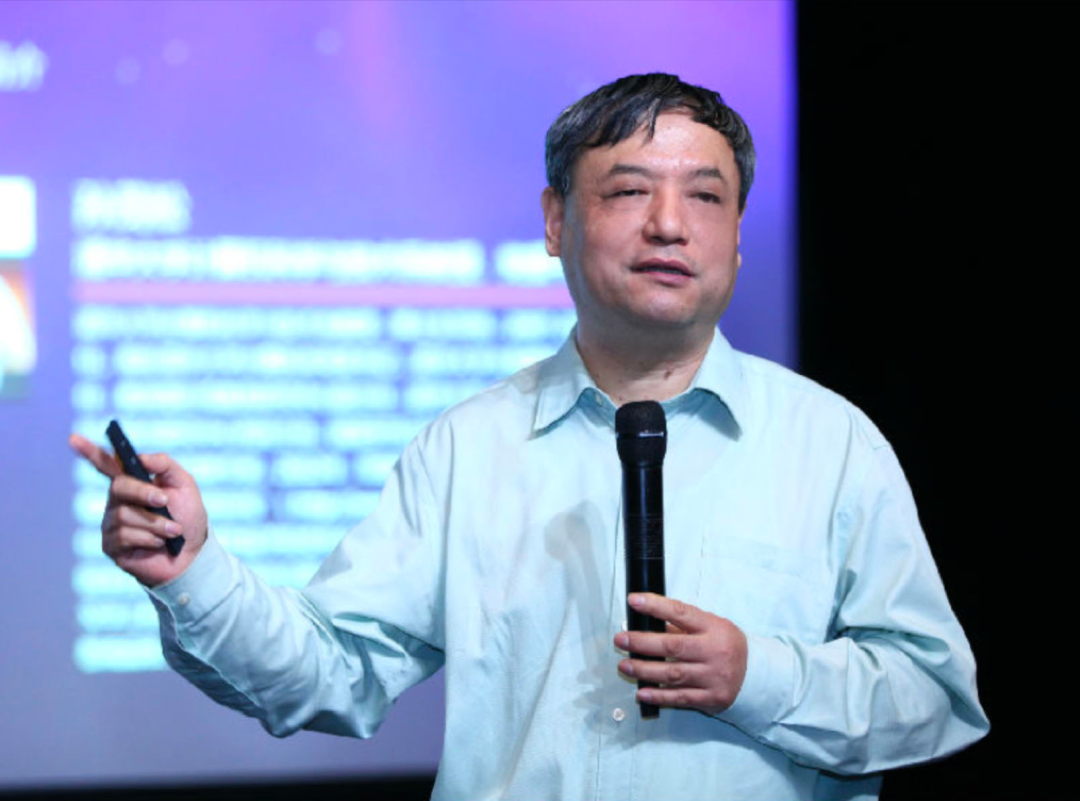
清华大学计算机系自然语言处理与社会人文计算实验室(THUNLP)成立于 20 世纪 70 年代末,是国内开展自然语言处理研究最早、深具影响力的科研单位。实验室围绕以中文为核心的自然语言处理,在大规模预训练模型、中文信息处理、机器翻译、社会计算、智慧教育和知识图谱等方面开展了系统深入的研究。实验室学科带头人是孙茂松教授,教师团队包括刘洋教授和刘知远副教授。近年来,该实验室承担了一系列国家重点研发项目、国家社会科学基金重大项目等重要研究任务,并与腾讯、华为、阿里、美团等企业建立了密切的学术合作关系。相关成果产生的 Github 开源工具包共获数万星标。孙茂松,THUNLP 实验室学术带头人,清华大学计算机与科学技术系长聘教授,清华大学人工智能研究院常务副院长,欧洲科学院外籍院士,中国人工智能学会、中国中文信息处理学会会士。研究方向为自然语言理解、中文信息处理、Web 智能、社会计算和计算教育学等。近几年在人工智能和自然语言处理领域顶级国际期刊或会议发表论文 200 余篇,获得国家授权发明专利 50 余项。作为首席科学家主持完成国家重点基础研究发展计划(973 计划)项目,国家社会科学基金重大项目。领衔研发中文诗歌自动生成系统「九歌」,累计为用户创作 3000 万首诗词。刘洋,清华大学计算机科学与技术系长聘教授,清华大学智能产业研究院副院长,国家杰出青年基金获得者。担任中国人工智能学会组织工作委员会副秘书长、中国中文信息学会计算语言学专委会常务副主任。研究方向是自然语言处理、机器翻译,获得国家科技进步二等奖 1 项、省部级科技奖励 4 项、重要国际会议优秀论文奖 2 项。刘知远,清华大学计算机科学与技术系长聘副教授。主要研究方向为表示学习、知识图谱和社会计算。已在 ACL、EMNLP、AAAI、IJCAI 等人工智能领域的著名国际期刊和会议发表相关论文 100 余篇,Google Scholar 统计引用 2.3 万次。曾获教育部自然科学一等奖(第 2 完成人)、中国中文信息学会钱伟长中文信息处理科学技术奖一等奖(第 2 完成人)、中国中文信息学会汉王青年创新奖,入选国家级青年人才、北京智源研究院青年科学家、2020 年 Elsevier 中国高被引学者、中国科学青年人才托举工程。「九歌」是孙茂松教授带领的 THUAIPoet 团队研发的中文诗歌自动生成系统,支持集句诗、绝句、藏头诗、词等不同体裁诗歌的在线生成。作为目前最有影响的诗歌生成系统之一,「九歌」 自 2017 年上线至今已累计为用户创作超过 700 万首诗词,并于全国计算语言学学术会议 (CCL) 荣获最佳论文奖 ( 2018 ) 和两次最佳系统展示奖 ( 2017, 2019 ) 。体验地址:http://jiuge.thunlp.org/清华大学知识工程实验室隶属于清华大学计算机系,同时承担了清华大学人工智能研究院知识智能中心、清华大学 - 中国工程院知识智能联合研究中心、互联网教育智能技术及应用国家工程实验室知识建模与分析中心的研究工作。实验室成立于 1996 年,致力于网络环境下知识工程理论、方法和应用研究,主要研究内容包括:知识图谱、社会网络、新闻挖掘等。研究成果在相关领域的 ACM/IEEE Transaction 以及计算机学会指定的 A 类国际期刊、会议上发表百余篇高水平论文,Google Scholar 统计论文引用次数 1 万余次。发表在顶级国际会议(KDD)和权威期刊(TKDE)的论文引用次数排列前茅。实验室在理论与应用研究结合方面成绩显著,构建了国内大规模跨语言知识图谱(http://XLore.org)、国内第一个全学科基础教育知识图谱(http://eduKG.cn)、科技情报大数据分析挖掘系统(http://AMiner.cn)、新闻挖掘分析系统(http://NewsMiner.net)。研究成果服务于华为、阿里、腾讯、搜狗等互联网公司以及中国科协、科技部、国家基金委、中国工程院等政府部门与研究机构,先后获得中国人工智能学会科技进步一等奖和北京市科技进步一等奖等多项奖励。
李涓子,清华大学计算机科学与技术系长聘教授,清华大学人工智能研究院知识智能中心主任,中国中文信息学会语言与知识计算专委会主任。2000 年在清华大学获得博士学位,研究领域为知识图谱、新闻与社会网络挖掘。主持研发了基于语义链接的跨语言知识图谱 XLORE,参与研发了研究者社会网络挖掘和服务系统 AMiner,曾获北京市科技进步一等奖、人工智能学会科技创新一等奖、王选新闻科学技术进步一等奖等多个奖项。唐杰,清华大学计算机系教授,曾入选 ACM Fellow、IEEE Fellow。主要研究领域包括人工智能、认知图谱、数据挖掘、社交网络和机器学习。2006 年毕业于清华大学,获博士学位。唐杰曾主持研发了参数规模超过 1.75 万亿的超大规模预训练模型「悟道」,以及研究者社会网络挖掘系统 AMiner,吸引了全球 220 个国家和地区的 2000 多万用户。开源双语千亿预训练模型 GLM-130B 项目原作解读转载清华大学交互式人工智能课题组 (Conversational AI, CoAI) 隶属于清华大学计算机系、清华大学人工智能研究院。交互式人工智能是指通过对话、问答等语言交互方式体现出来的智能行为,是人工智能最具挑战性、最综合性的技术,涵盖了语义理解、知识表示、逻辑与推理、语言生成等各个方面。课题组由朱小燕教授、黄民烈副教授指导,与众多国内外知名企业建立了广泛合作,例如华为、谷歌、微软、惠普、三星、斯伦贝谢、腾讯、阿里巴巴、搜狗、美团、好未来等。朱小燕,清华大学计算机系教授、博士生导师。曾任智能技术与系统国家重点实验室主任、北京市计算机学会副理事长、清华大学计算机系副主任、加拿大国际开发研究中心(DIRC)首席科学家。1982 年获北京科技大学学士学位,1987 年获日本神户大学硕士学位,1990 年获日本名古屋工业大学博士学位,1993 年到清华大学任教。长期在智能信息处理领域开展深入研究,在人工神经元网络、机器学习、自然语言处理、信息获取、智能问答系统、交互智能和人机交互等方面取得显著成果。黄民烈,清华大学计算机系长聘副教授,2000 年毕业于清华大学工程物理系,2006 年获清华大学计算机科学与技术博士学位。研究兴趣主要集中在人工智能与机器学习方法包括深度学习、强化学习等,自然语言处理方法与应用,包括自动问答、阅读理解、对话系统、情感分析等。主要研究语言理解、语言生成、语言匹配与推理中的科学问题,致力于解决对话系统、自动问答、阅读理解中具有挑战性的人工智能问题。曾获得汉王青年创新奖、微软合作研究奖(Microsoft Collaborative Research Award)、IJCAI-ECAI 2018 杰出论文奖、CCL 2018 最佳系统展示奖、NLPCC 2015 最佳论文奖。清华大学交互式人工智能课题组(CoAI)长期以来一直致力于构建开源的中文开放领域对话预训练基座模型,已有成果包括 CDial-GPT 、 EVA1.0、 EVA2.0、OPD 等。大规模、高性能,清华、聆心智能推出中文开放域对话预训练开源模型 OPD北京大学人工智能研究院自然语言处理研究中心将以研发通用自然语言处理技术为目标,探索通用自然语言处理理论、方法和技术体系,研究通用性鲁棒性强且支持跨模态的自然语言理解与生成方法,为通用人工智能平台和领域 AI 大任务系统的提供技术支撑。主要研究方向有:语义分析与理解、文本推理、问答与对话、文本生成、跨模态语言智能、认知与知识计算等。赵东岩,北京大学王选计算机研究所研究员,博士生导师。长期从事自然语言处理和大规模语义数据管理的前沿研究工作。主要研究方向为自然语言处理、大规模语义数据管理、基于知识的智能服务技术。主持科技部 2030 新一代人工智能重大项目(基础研究类)「面向自然语言的语义分析研究」等国家级项目 8 项,发表学术论文 100 余篇(包括 ACL、AAAI、IJCAI、SIGKDD、SIGIR、SIGMOD、VLDB,AI Journal、TKDE、VLDB Journal 等 CCF A 类会议和期刊 70 余篇),授权发明专利 23 项,先后七次获得国家和省部级奖励。近五年来牵头研制了具有自动扩展和质量控制功能的开放域语义知识库构建技术、基于知识库的语义理解与自然语言问答、语义搜索引擎等一系列自然语言理解与认知智能的前沿技术,并开展了面向智能知识服务的行业应用。采用上述技术构建的 PKUBase 是国内科研单位建设最早且规模最大的语义知识库之一。基于知识库的语义理解和自然语言问答系统在欧盟组织的国际权威评测 QALD 上连续三年取得了第一名的成绩,在美国 NIST 组织的 TREC 微博检索任务上连续两年取得第一名。万小军,北京大学王选计算机研究所研究员、博士生导师,语言计算与互联网挖掘研究室负责人,在北京大学获得学士、硕士与博士学位。研究方向为自然语言处理与文本挖掘,研究兴趣包括自动文摘、文本生成、情感分析、语义分析、多模态与多语言 NLP 等。曾担任计算语言学顶级国际期刊 Computational Linguistics 编委、国际会议 EMNLP-IJCNLP 2019 程序委员会主席,现任 CCF-NLP 专委会秘书长、TACL 执行编辑、NLE 编委、JCST 编委,10 多次担任相关领域重要国际会议领域主席,包括 ACL、NAACL、EMNLP、EACL,AACL 等。荣获 ACL2017 杰出论文奖、IJCAI 2018 杰出论文奖、2017 年吴文俊人工智能技术发明奖、CCF NLPCC 青年新锐奖等奖励。研制推出了多款 AI 写作机器人,如小明、小南、小柯等,应用于多家媒体单位。冯岩松,北京大学王选计算机研究所副教授。2011 年毕业于英国爱丁堡大学,获得信息科学博士学位。主要研究方向包括自然语言处理;连续多年在面向结构化知识库的智能问答评测中获得第一名;相关工作发表在 ACL、EMNLP、TPAMI、AIJ 等自然语言处理领域顶级会议及期刊上。多次担任 ACL、EMNLP、NAACL、IJCAI 等领域重要国际会议的领域主席或高级程序委员会委员;作为项目负责人或课题骨干承担多项国家自然科学基金、科技部 863 计划和重点研发项目;分别在 2014、2015 年获得 IBM Faculty Award,2016 年 IBM Shared University Research Award。复旦大学自然语言处理实验室由复旦大学首席教授吴立德先生创建,是我国最早开展自然语言处理和信息检索研究的实验室之一。经过 40 余年发展,在自然语言处理底层分析、文本检索、自动问答、社会媒体分析等方面取得了一系列的研究成果。实验室多年在国家自然科学基金、国家 863/973 / 重点研发计划、省部委基金的支持下,发表了大量高水平国际期刊和会议论文,其中包括中国计算机学会推荐的 A/B 类国际会议和期刊论文(ACL,SIGIR,IJCAI,AAAI,NIPS,ICML 等)论文 150 余篇;参加多项国内外评测,如在自动问答国际评测 TREC/QA 中获得第 3 名,在文本蕴涵评测 RITE 和阅读理解评测 SQUAD 都位居前列;发布了国内首家中文自然语言开源系统 FudanNLP,被包括联合国教科文组织在内的国内外多家研发机构采用。黄萱菁,复旦大学计算机科学技术学院教授、博士生导师,主要从事自然语言处理、信息检索和社会媒体分析研究,人工智能、自然语言处理学科方向带头人。兼任中国中文信息学会理事、社会媒体专委会副主任,中国计算机学会自然语言处理专委会副主任、学术工作委员会委员、中国人工智能学会女科技工作者委员会副主任、AACL 执委,EMNLP 2021 程序委员会主席。在高水平国际学术期刊和会议上发表了百余篇论文,负责的多个科研项目受到国家自然科学基金、科技部、教育部、上海市科委的支持。获 2021 年上海市育才奖,并入选「人工智能全球女性」、「AI 2000 人工智能全球最具影响力提名学者」及「福布斯中国 2020 科技女性榜」。
邱锡鹏,复旦大学计算机科学技术学院教授,博士生导师。国家优青获得者,于复旦大学获得理学学士和博士学位。主要从事自然语言处理、深度学习等方向的研究,发表 CCF A/B 类论文 70 余篇,获得 ACL 2017 杰出论文奖(CCF A 类)、CCL 2019 最佳论文奖、《中国科学:技术科学》2021 年度高影响力论文奖,有 5 篇论文入选 PaperDigest 发布的 IJCAI/ACL/EMNLP 的最有影响力论文(被引用数进入前当届会议的 20 名)。出版开源专著《神经网络与深度学习》,Github 关注数 1.5 万,豆瓣评分 9.4 分。主持开发了开源框架 FudanNLP 和 FastNLP,已被国内外数百家单位使用。2015 年入选首届中国科协青年人才托举工程项目,2018 年获钱伟长中文信息处理科学技术奖青年创新奖一等奖,2020 获第四届上海高校青年教师教学竞赛优等奖,2021 年获首届上海市计算机学会教学成果奖一等奖(第一完成人)等。培养学生多次获得一级学会优博、微软学者、百度奖学金等。 2 月 20 日晚,复旦大学自然语言处理实验室发布了具备 ChatGPT 能力的语言模型 ——MOSS,并面向大众公开邀请内测。MOSS 可执行对话生成、编程、事实问答等一系列任务,打通了让生成式语言模型理解人类意图并具有对话能力的全部技术路径。西湖大学 NLP 实验室由张岳博士带领,长期开展自然语言处理方面的研究,实验室研究方向包括自然语言处理、背后的机器学习算法以及相关的应用,在 ACL、EMNLP 等自然语言处理顶级会议发表过多篇高水平论文。张岳,2003 年毕业于清华大学计算机科学专业,获得学士学位;2006 年毕业于牛津大学计算机科学专业,获得硕士学位;2009 年毕业于牛津大学计算机科学专业,获得博士学位。2010 年 3 月 - 2012 年 6 月在剑桥大学计算机科学专业从事博士后研究,2012 年 7 月 - 2018 年 8 月在新加坡科技与设计大学担任助理教授。2018 年 9 月全职加入西湖大学,担任终身副教授。主要研究领域为自然语言处理、文本挖掘、机器学习和人工智能,具体研究方向包括:1. 中英文基础自然语言处理中的词法、句法及语义表示,分析。2. 信息抽取中的实体、关系、事件以及情感抽取。3. 金融领域、生物医药领域以及文学领域的文本挖掘。4. 自然语言生成及其在文本总结与机器翻译中的应用。张岳博士是近几年全球 NLP 相关顶会最高产的学者之一。根据相关统计,在 2012 年 - 2020 年期间,张岳博士在 NLP 领域的顶会发表的论文数量是全球第三,仅次于周明和 Yoshua Bengio。
蓝振忠,西湖大学助理教授、博士生导师,西湖心辰(杭州)科技有限公司创始人。蓝振忠博士毕业于卡耐基梅隆大学计算机学院,是 NLP 自然语言处理领域预训练语言模型「 ALBERT 」第一作者。蓝振忠长期致力于研究自然语言处理,计算机视觉及深度学习的结合与应用。此前在谷歌 AI 研究所工作,研发成果被应用于谷歌新闻、谷歌助手等多个拥有亿级以上用户的产品;2020 年受聘于西湖大学,创办深度学习实验室并担任博士生导师,而后迅速带领团队研发出了 AI 心理咨询师「小天」、智能写作平台 FRIDAY 以及 AI 绘画产品「盗梦师」;2021 年被麻省理工大学评选为亚太地区「 35 岁以下科技创新 35 人」之一。哈工大的自然语言处理研究开始于 1979 年俄汉题录翻译的研究,更加系统深入的研究开始于上世纪 80 年代,围绕中文信息处理这一核心,在机器翻译、中文输入法、自然语言处理平台、语言知识资源建设等方面相继展开研究,培养了一批以周明、王海峰、张民、荀恩东为代表的优秀校友,取得了一批以「语句输入」、「语言技术平台 LTP」为代表的标志性成果,成为我国在自然语言处理领域一支重要的力量。2020 年 7 月 17 日,哈尔滨工业大学计算学部批准成立自然语言处理研究所。研究所隶属于哈工大计算学部,由本部的社会计算与信息检索研究中心、语言技术研究中心和深圳校区的智能计算研究中心组成。赵铁军,教授,博士生导师,哈工大教育部 - 微软语言语音重点实验室主任,兼任中国中文信息学会常务理事,中国计算机学会自然语言处理专业委员会副主任,《中文信息学报》、《自动化学报》编委。1987 年开始从事中文信息处理领域相关研究,主要研究方向:自然语言理解、人工智能应用。近年来承担国家自然科学基金重点项目、面上项目、国家重点研发计划项目、国家高技术计划项目、科技部国际合作项目等 7 项,2018 年担任国家重点研发计划司法专题项目(2018YFC0830700)首席科学家;发表学术论文 60 余篇。先后获部级科技进步奖 6 项,出版专著、译著 3 部。
车万翔,教授,哈尔滨工业大学计算学部长聘教授、博士生导师,社会计算与信息检索研究中心副主任。教育部青年长江学者,黑龙江省「龙江学者」青年学者,斯坦福大学访问学者。在 ACL、EMNLP、AAAI、IJCAI 等国内外高水平期刊和会议上发表学术论文 50 余篇,其中 AAAI 2013 年的文章获得了最佳论文提名奖,论文累计被引用 4,600 余次(Google Scholar 数据),H-index 值为 37。负责研发的语言技术平台(LTP)已被 600 余家单位共享,并授权给百度、腾讯、华为等公司使用。2018、2019 连续两年获 CoNLL 国际评测第 1 名。2015、2016 连续两年获谷歌专注研究奖。2017 年,所主讲的 MOOC 课程《高级语言程序设计(Python)》获国家精品在线开放课程。秦兵,教授,博士生导师,哈尔滨工业大学计算机学院社会计算与信息检索研究中心主任。担任中国中文信息学会理事、中国中文信息学会语言与知识计算专委会副主任,国家自然科学基金重点项目负责人。主要研究方向知识图谱构建、文本情感计算、文本理解与自动生成。连续主持多项国家自然科学基金面上项目及科技部重点研发计划课题。获黑龙江省科技进步一等奖、黑龙江省技术发明二等奖、钱伟长中文信息处理科学技术奖等奖项。在国内外重要会议和期刊发表论文 100 余篇,论文累计被引用 6234 余次(Google Scholar 数据),H-index 值为 31。持续与多家互联网企业开展合作,多项研究成果在企业应用落地。入选「2020 年度人工智能全球女性榜单」和「福布斯中国 2020 科技女性榜」刘挺,博士生导师,哈工大计算学部主任兼计算机学院院长。多次担任国家 863 重点项目总体组专家、基金委会评专家。中国计算机学会理事,中国中文信息学会常务理事 / 社会媒体处理专委会(SMP)主任,曾任国际顶级会议 ACL、EMNLP 领域主席。主要研究方向为人工智能、自然语言处理和社会计算,是国家 973 课题、国家自然科学基金重点项目负责人。主持研制「语言技术平台 LTP」、「大词林」等科研成果被业界广泛使用。曾获国家科技进步二等奖、省科技进步一等奖、钱伟长中文信息处理科学技术一等奖等。张伟男,哈尔滨工业大学计算机学院院长助理、副教授、博士生导师,黑龙江省中文信息处理重点实验室副主任。曾担任 ACL、EMNLP 领域主席、AAAI 高级程序委员会委员(SPC)及多个国际会议及期刊的程序委员会成员、审稿人及期刊编委。目前为中国中文信息学会青年工作委员会副主任,中国计算机学会(CCF)术语审定工作委员会执委、CCF 哈尔滨分部秘书长,中国人工智能学会教育工作委员会副秘书长,北京智源青源会会员。主要从事人机对话及自然语言处理等研究。在 ACL、AAAI、WWW、IJCAI、IEEE TKDE、ACM TOIS 等 CCF A 类国际会议及期刊发表学术论文多篇;主导研发了智能人机对话系统「笨笨」,2019 年 3 月「笨笨」中的开放域人机对话功能成功落地到科大讯飞 AIUI 智能交互平台;获黑龙江省科技进步一等奖、吴文俊人工智能科技进步二等奖及黑龙江省青年科技奖等。中科院自动化所模式识别国家重点实验室自然语言处理团队中科院自动化所模式识别国家重点实验室于 1984 年由国家计委批准筹建,1987 年通过国家验收并正式对外开放,依托于中国科学院自动化研究所。实验室目前的主要研究方向为模式识别、计算机视觉、图像处理与图形学,口语信息处理、自然语言处理以及模式识别应用与系统等。宗成庆,中科院自动化所研究员、博士生导师、国际计算语言学委员会(ICCL)委员、中国人工智能学会会士和中国计算机学会会士。他于 1998 年 3 月在中科院计算所获得博士学位,主要研究兴趣包括自然语言处理、机器翻译、文本数据挖掘和语言认知计算等领域,曾获国家科学技术进步奖二等奖、中国电子学会科技进步奖一等奖等若干奖励和荣誉。
张家俊,中国科学院自动化研究所研究员、博士生导师,主要研究方向为机器翻译和自然语言处理,获得国家优秀青年科学基金资助,入选中国科协首届青年人才托举工程、中国科学院青年创新促进会优秀会员和北京智源青年科学家。发表 CCF-A/B 类论文 80 余篇,出版学术专著 2 部、译著 1 部,获得中国中文信息学会钱伟长中文信息处理科学技术奖一等奖、青年创新奖一等奖和 2020 年北京市科学技术奖一等奖等。担任中国中文信息学会理事、青年工作委员会主任和机器翻译专委会副主任。担任 ACL/EMNLP/COLING 的 (资深) 领域主席,以及《自动化学报》等期刊的编委。中国科学院计算技术研究所自然语言处理研究组隶属于中国科学院智能信息处理重点实验室,主要从事自然语言处理相关的研究工作,主要研究方向包括机器翻译、人机对话等。研究组在自然语言处理领域旗舰会议 ACL 和影响力最大的期刊 CL 上分别发表了国内首篇论文;获 ACL 2019 最佳长文奖,为 ACL 开办以来国内单位首次获得此奖项;获 ACL 2006 Meritorious Asian NLP Paper Award,为国内学者首次获得 ACL 论文奖;获 EMNLP 2008 最佳论文提名奖、2020 世界人工智能大会青年优秀论文奖等。多次在 IWSLT 国际机器翻译评测和 CWMT 机器翻译评测中获得第一名,并在由美国国防部 DARPA 资助的、NIST 组织的世界权威机器翻译评测中获国内研究机构最好成绩。部分研究成果获国家科技进步奖二等奖、北京市科技进步二等奖、钱伟长中文信息处理科学技术奖一等奖、中国电子学会科学技术奖科技进步一等奖等。冯洋,研究员、博士生导师,中科院计算所「新百星人才引进计划」入选者、2019 年度「卓越之星」获得者、自然语言处理课题组负责人。研究方向为自然语言处理、机器翻译、人机对话。在中科院计算所获得博士学位后,先后在谢菲尔德大学和南加州大学信息科学研究所(USC/ISI)开展研究工作。曾获 ACL 2019 最佳长文奖,为 ACL 开办 50 多年以来国内首次获得该奖项。多次在 NIST、CWMT、DSTC 等国内外权威机器翻译评测和对话系统比赛中获得第一名,作为项目负责人主持国家重点研发计划、国家自然科学基金面上项目等,与华为、腾讯、百度、字节跳动等公司开展合作研究。中科院软件研究所中文信息处理实验室始于 1996 年成立的「开放系统与中文信息处理中心」。实验室当前主要围绕互联网环境下的自然语言理解这一中文信息处理领域的核心问题,开展中文信息的认知和理解机理、大规模中文知识图谱、基于知识的中文分析以及面向大数据智能服务的中文问答等关键技术研究。实验室成员 2000 年起参加 TREC、NTCIR、DUC、TAC 等信息检索和自然语言处理领域的权威国际评测,并多次取得优异成绩。实验室目前承担着国家重大研发计划、国家自然科学基金重点项目、新闻出版署重大专项、国家语委重点项目、大型互联网企业合作(华为、阿里、百度)等 10 多项研究和开发任务,近年来在 ACL、SIGIR、AAAI、EMNLP 等顶级国际会议发表论文 50 多篇。韩先培,中科院软件所研究员,担任中文信息处理实验室副主任,入选国家优青、中国科协青年人才托举计划及北京智源青年科学家。主要研究方向为信息抽取、知识图谱及自然语言理解。承担中科院战略先导、科技创新 2030 课题、国家重点研发专项等十余项课题。在 ACL、SIGIR、IJCAI 等重要国际会议发表论文 60 余篇。担任中国中文信息学会理事及语言与知识计算专业委员会副主任。相关成果获中国中文信息学会汉王青年创新奖一等奖及科学技术奖一等奖。中国人民大学高瓴人工智能学院由高瓴资本创始人、耶鲁大学校董、中国人民大学校友张磊先生捐资支持建设。高瓴人工智能学院博士生导师实行人才培养导师组的形式,研究方向为:人工智能基础理论,智能信息检索,机器学习,计算机视觉,自然语言处理,人工智能交叉应用等。学院已与百度、华为分别签订人才培养合作协议、「智能基座」产教融合基地合作协议,与百度共建「松果实践基地」,与北京智源人工智能研究院、微软亚洲研究院开展人工智能创新人才联合培养,与联通、京东、滴滴、浪潮、爱奇艺、美团点评等 20 余家知名企业设立了实训基地。2021 年学院师生共发表高水平论文(中国计算机学会 CCF A/B 类)100 余篇。文继荣院长作为北京智源研究院首席科学家,带领团队研发首个中文超大规模多模态预训练模型「文澜」,产生广泛影响。在国际排行榜 CSRankings 中,2021 年中国人民大学人工智能领域世界排名已升至第 16 位,在互联网与信息检索方向排名位居世界第一。更多国际一流学者正在陆续加入人才培养导师组。
文继荣,中国人民大学高瓴人工智能学院执行院长、信息学院院长,大数据管理与分析方法研究北京市重点实验室主任,北京智源人工智能研究院首席科学家。曾任微软亚洲研究院高级研究员和互联网搜索与挖掘组主任。长期从事大数据和人工智能领域的研究,已在信息检索、数据挖掘、机器学习、数据库等领域国际著名学术会议和期刊上发表论文 200 余篇,总计引用 15000 余次,H-Index 为 57。窦志成,中国人民大学高瓴人工智能学院副院长、教授,北京智源人工智能研究院「智能信息检索与挖掘」方向项目经理,基于大数据文科综合训练国家级虚拟仿真实验教学中心执行主任。2008 至 2014 年在微软亚洲研究院工作,2014 年开始在中国人民大学任教。主要研究方向为智能信息检索、自然语言处理、大数据分析。已在国际知名学术会议和期刊上(如 SIGIR、WWW、CIKM、WSDM、ACL、EMNLP、TKDE 等)发表论文 50 余篇,获 SIGIR 2013 最佳论文提名奖,AIRS 2012 最佳论文奖。卢志武,中国人民大学高瓴人工智能学院教授,博士生导师。2005 年 7 月毕业于北京大学数学科学学院信息科学系,获理学硕士学位;2011 年 3 月毕业于香港城市大学计算机系,获 PhD 学位。主要研究方向包括机器学习、计算机视觉等。主持 NSFC、KJW 等多个国家项目。设计首个公开的中文通用图文预训练模型文澜 BriVL,并发表于 Nature Communications。以主要作者身份发表学术论文 70 余篇,其中在 TPAMI、IJCV、TIP、TCYB、TGRS 等重要国际期刊和 NeurIPS、AAAI、IJCAI、CVPR、ICCV、ECCV 等重要国际会议上发表论文 40 余篇,CCF A 类论文 25 篇,入选 ESI 高被引论文 1 篇。
赵鑫,教授、博士生导师。研究方向为自然语言处理以及推荐系统。近五年内在国内外著名学术期刊与会议上发表论文 80 余篇,其中包括信息检索领域顶级学术期刊 ACM TOIS 和学术会议 SIGIR、数据挖掘领域顶级学术期刊 IEEE TKDE 和学术会议 SIGKDD、自然语言处理顶级会议 ACL 和 EMNLP。所发表的学术论文取得了一定的关注度,据 Google Scholar 统计,已发表论文共计被引用 4000 余次,其中以第一作者发表《Comparing Twitter and Traditional Media Using Topic Models》被引用 1300 余次。在中国人民大学高瓴人工智能学院执行院长、智源首席科学家文继荣教授的带领下,中国人民大学、北京智源人工智能研究院、中科院计算所的研究团队合作开展了大规模中文多模态预训练模型的研究,并发布了第一代悟道・文澜,旨在发掘预训练模型在中文通用多模态数据上的理解能力。文澜模型经过 6.5 亿弱相关中文图文对的预训练,学习到独特的中文语义理解能力并能很好地将中文语义与视觉信息联系起来,尤其擅长读取中文独有的含蓄语义与图片中的抽象概念。最懂中国传统文化的 AI 绘画模型,画作有形更有神,传达儒释道思想南京大学自然语言处理研究组从事自然语言处理领域的研究工作始于 20 世纪 80 年代。近年来,研究组在自然语言处理的多个方向上做了大量、深入的工作,集中关注文本分析、机器翻译、社交媒体分析推荐、知识问答等多个热点问题,结合统计方法和深度学习方法进行问题建模和求解,取得了丰富的成果。研究组在自然语言处理顶级国际会议 ACL、EMNLP、NAACL 和人工智能顶级国际会议 IJCAI 和 AAAI 上发表论文三十余篇,相关系统在机器翻译、中文分词、命名实体识别、情感计算等多个国际国内评测中名列前茅。陈家骏,教授、博士生导师。南京大学计算机系自然语言处理实验室主任,中国中文信息学会理事。毕业于南京大学计算机软件专业,获学士、硕士和博士学位。20 世纪 80 年代就开始从事自然语言处理和软件工程领域的研究与系统开发工作,研究方向包括机器翻译、汉语语言处理以及程序设计语言等。承担过国家 863 高技术、国家自然科学基金、国家社科基金以及教育部博士点基金等项目的研究工作;获得过国家七・五科技攻关重大成果奖、教育部科技进步二等奖等科研奖励;发表学术论文 180 余篇,其中包括领域顶级会议和期刊(ACL、EMNLP、NAACL、TALLIP、TACL、AAAI、IJCAI 等)论文数十余篇。随着 ChatGPT 的出圈,很多国内大厂也开始支持类 ChatGPT 大模型研究。如果说学术界更看重理论前沿的探索,那么对于企业界来说,想要打造出「ChatGPT」则意味着在各个层面的能力均有所布局。OpenAI 早在 2017 年就开始了 GPT 系列模型的研发,并且几年内来多次迭代。鉴于 OpenAI 并不是一家普通的「初创公司」,背后有微软提供的云算力支持,还有数年如一日、不计回报的高额研发投入,以及多年积累的海量用户数据。纵观国内,同时具备这几项基础条件的企业并不多。在搜索业务和问答业务方面已积累了大量经验的企业更具优势,更可能走在前列。目前,在自然语言处理领域,百度、腾讯、阿里等大厂各种都有相关的技术沉淀和产品化的积累,在硬件、模型、产品层面的积淀尚可与 OpenAI 或者谷歌、微软这类硅谷巨头对标。即使如此,做出对标 ChatGPT 的产品仍不容易,这也是当下各大企业实验室集中攻关的主题。百度是最早针对 ChatGPT 做出明确表态的公司之一,2 月 7 日即官宣在 3 月上线百度版 ChatGPT「文心一言」(英文名 ERNIE Bot)。百度给出的回应中提到「ChatGPT 相关技术百度都有」:「百度在人工智能四层架构中有全栈布局,包括底层芯片、深度学习框架、大模型以及最上层的搜索等应用。」在国内的科技企业中,百度大模型产品体系和开发工具是比较成熟的。此外,百度搜索早就接入了文心相关技术,这次「文心一言」的推出或将对百度搜索的升级起到重大作用。近日,据 36 氪报道,百度目前筹备「文心一言」的团队主要由 TPG(技术中台事业群)、MEG(移动生态事业群)两大部门协同。前者负责技术攻坚,后者进行搜索、内容产品承接。项目由百度 CTO 王海峰任总指挥,其他带队高管还包括:百度集团副总裁吴甜(同时担任深度学习技术及应用国家工程研究中心副主任)、百度技术委员会主席吴华等人。
王海峰,现任百度首席技术官,深度学习技术及应用国家工程研究中心主任。王海峰博士是自然语言处理领域世界上最具影响力的国际学术组织 ACL(Association for Computational Linguistics)50 多年历史上首位华人主席(President)、ACL 亚太分会创始主席、ACL Fellow,还是 IEEE Fellow、CAAI Fellow 及国际欧亚科学院院士等。王海峰博士先后创建和发展了自然语言处理、知识图谱、语音、图像、机器学习和深度学习等百度人工智能技术方向,先后负责百度搜索、百度地图、百度翻译、百度智能云等业务。吴甜,百度集团副总裁、深度学习技术及应用国家工程研究中心副主任。负责百度人工智能技术平台与生态,涵盖自然语言处理、知识图谱、计算机视觉、增强现实、飞桨深度学习平台(PaddlePaddle)、百度大脑开放平台等。
吴华,百度技术委员会主席。主要研究领域包括自然语言处理、机器翻译、人机对话、知识挖掘、机器学习等。负责的百度翻译项目翻译质量处于世界领先水平,并获国家科学技术进步奖二等奖。吴华在语法语义分析、机器学习、人机交互、自动问答等方向上进行了多项创新,其成果已应用于百度多数产品。2015 年,吴华曾在百度带队研发出世界上首个互联网 NMT (神经网络机器翻译) 系统。2019 年开始,百度深耕预训练模型研发,先后发布知识增强文心(ERNIE)系列模型。文心系列模型基于持续学习的语义理解框架,从大规模知识和海量数据中融合学习,具备跨模态、跨语言的深度语义理解与生成能力。2021 年 12 月,ERNIE 3.0 升级为全球首个知识增强千亿大模型鹏城 - 百度・文心,同时,产业级知识增强大模型文心全景图亮相。通过多年的技术探索与产业实践,百度文心大模型已经构建了「模型 + 工具平台 + 产品社区」三层体系。即将推出的「文心一言」就位于模型层。阿里巴巴达摩院语言技术实验室为机器智能技术实验室下属实验室,是阿里巴巴负责 NLP 技术研发的核心团队,为阿里巴巴经济体提供包括 NLP 基础技术、对话技术、应用算法、机器翻译、内容搜索推荐等技术,在经济体内数千业务方应用,日调用万亿级,并在很多重要行业如电商、司法、医疗、通信等赋能数千家合作伙伴和外部客户。其中,对话智能团队专注于人机对话交互的创新研究和大规模应用,打造了智能对话开发平台 Dialog Studio,以及 KBQA、TableQA、FAQs、MRC 等智能问答技术,在自然语言理解、多轮对话管理、元学习、迁移学习、基于知识图谱问答等多个方向上取得前沿进展。开发的对话技术平台和云小蜜产品已经大规模服务于淘宝天猫电商平台、钉钉、公有云、私有云、国际化等业务中,并在智能服务市场居于业界领先地位。周靖人,哥伦比亚大学计算机科学博士,浙江大学兼职教授,IEEE Fellow。现任阿里巴巴集团资深副总裁,达摩院副院长。曾负责阿里云计算平台,淘宝和支付宝搜索、推荐、广告等数据智能业务。研究方向包括云计算、大数据、人工智能算法及应用。多次担任 VLDB,SIGMOD,ICDE 等国际顶级会议程序委员会主编、主席,在顶尖国际期刊和会议上发表论文超百篇,并拥有几十项技术专利。2022 年 12 月,任阿里云智能 CTO 兼任达摩院副院长。
司罗,阿里巴巴副总裁兼达摩院语言技术实验室负责人,2014 年成为阿里人工智能科学家阵营的一员,带领阿里 NLP 团队取得多项重要成果。他领导阿里巴巴语言智能、机器翻译、文本分析、对话智能以及文本搜索等技术研究方向,累计发表学术论文 180 多篇,被广泛引用。司罗是最早一批从学术界转向工业界的人工智能科学家之一。在加入阿里巴巴之前,司罗是美国普渡大学计算机系的终身教授,并先后获得美国国家科学基金会成就奖、雅虎、谷歌研究奖等。更早之前,司罗先后获得清华大学和卡内基梅隆大学的计算机学士和博士学位。他曾先后担任 ACM 信息系统(TOIS)、ACM 交互信息系统(TIIS)和信息处理与管理(IPM)编辑委员会的副主编,并多次在国际学术会议担任重要职务(如 2016 ACM CIKM 技术主席)。2019 年,司罗当选 ACM 2019 杰出科学家。黄非,阿里巴巴达摩院机器智能语言技术实验室研究员,自然语言基础技术,对话技术和多模态翻译团队负责人。他领导 AliNLP 基础技术研发和业务落地,云小蜜对话技术和多模态翻译技术,并支持集团内外的国际化业务需求。黄非博士毕业于卡耐基梅隆大学计算机学院。之后在 IBM 和 Facebook 从事自然语言处理的研发和技术管理等职位。他在自然语言处理和人工智能的顶级会议和期刊发表文章 40 多篇,获得美国专利 10 多项,曾担任 ACL,IJCAI,COLING 等多个 NLP 国际会议的领域主席 / 资深程序委员和多个期刊会议论文的审稿人。
李永彬,毕业于清华大学,阿里巴巴达摩院资深算法专家,研究方向为Conversational AI & 预训练大模型。近年来围绕对话预训练、人机对话交互、人机协同交互、多模态对话等方向发表30+篇顶会论文(ACL/EMNLP/AAAI等),其中达摩院通义对话大模型SPACE-1/2/3 系列模型在11个国际公开对话数据集取得SOTA,并分别被AAAI22/COLING22/SIGIR22长文录用。2022年团队发表25篇顶会论文,其中EMNLP2022一次中稿10篇论文。同时负责对话智能在阿里云、电商、钉钉等场景的大规模产品化落地,在中国对话式AI云服务市场份额排名第一。
2021 年初,阿里巴巴达摩院提出了百亿参数的超大规模中文多模态预训练模型 M6,并持续推出多个版本,参数逐步从百亿规模扩展到十万亿规模,在大模型、绿色 / 低碳 AI、AI 商业化、服务化等诸多方面取得突破性进展。2022 年,在探索算力极限的同时,他们也积极展开了针对通用模型的探索,提出业界首个通用的统一大模型(模态、任务和架构)M6-OFA,极大地降低了模型在预训练、适配下游任务、推理过程中的难度。这个大模型是达摩院公布的阿里巴巴「通义」大模型系列的一部分。该系列分为三个层级:最底层为统一模型底座,中间基于底座的通用模型层覆盖了通义 - M6、通义 - AliceMind 和通义 - 视觉,专业模型层深入电商、医疗、娱乐、设计、金融等行业。在通用型 Chat AI 方向,京东云已经打造了包括京东智能客服系统、京小智平台商家服务系统、智能金融服务大脑、智能政务热线,言犀智能外呼、言犀数字人等系列产品和解决方案。拆解到细分技术领域,京东云在文本生成、对话生成、数字人生成方向等方向也已经做出了一些成果。何晓冬,京东集团副总裁,京东人工智能研究院执行院长,深度学习及语音和语言实验室主任,IEEE Fellow,同时在位于西雅图的华盛顿大学兼任教授、博士生导师。何晓冬博士的研究方向主要聚焦在人工智能领域。其在深度学习、自然语言处理、语音识别、计算机视觉及信息检索等方面均有重要贡献。其工作包括 DSSM(深度结构语义模型 / 深度语义匹配模型)和图像描述机器人 Caption Bot 等。在加入京东之前,何晓冬博士就职于美国微软雷德蒙德研究院,担任主任研究员(Principal Researcher)及深度学习技术中心(DLTC)负责人。何晓冬博士于 1996 年获清华大学学士学位,1999 年获中国科学院硕士学位,2003 年获美国密苏里大学 - 哥伦比亚分校博士学位。吴友政, 京东集团高级总监,京东科技语音语言算法部负责人。2006 年中科院自博士毕业后,先后在日本国立信息通信研究机构、英国爱丁堡大学、索尼中国研究院从事自然语言处理相关研究工作。工作主要聚焦自然语言处理、人机对话、语音识别、机器翻译等前沿技术研究和产品研发工作,并取得了诸多技术突破,累计发表顶级国际会议和期刊论文 30 余篇,曾获得语音识别(IWSLT2012、IWSLT2013)和自然语言处理(QuAC2021,DROP2022,Multiwoz2022)领域多项国际比赛的冠军。他与团队密切合作打造了言犀人工智能应用平台,为客户提供涵盖客户服务、营销导购、流程自动化的整体智能化解决方案,为京东超 5.8 亿用户提供智能服务,也为零售、政务、金融、交通等行业提供产品与解决方案。基于产业需求,京东云旗下言犀人工智能应用平台将推出 ChatJD,定位为产业版 ChatGPT,旨在打造优势、高频、刚需的产业版通用 ChatGPT。ChatJD 将通过在垂直产业的深耕,快速达成落地应用的标准,并不断推动不同产业之间的泛化,形成更多通用产业版 ChatGPT,构建数据和模型的飞轮,以细分、真实、专业场景日臻完善平台能力,最终反哺和完善通用 ChatGPT 的产业应用能力。ChatJD 将以「125」计划作为落地应用路线图,包含一个平台、两个领域、五个应用。- 1 个平台:ChatJD 智能人机对话平台,即自然语言处理中理解和生成任务的对话平台,预计参数量达千亿级;
- 2 个领域:零售、金融,得益于京东云在零售与金融领域 10 余年真实场景的深耕与沉淀,已拥有 4 层知识体系、40 多个独立子系统、3000 多个意图以及 3000 万个高质量问答知识点,覆盖超过 1000 万种自营商品的电商知识图谱,更加垂直与聚焦;
- 5 个应用:内容生成、人机对话、用户意图理解、信息抽取、情感分类,涵盖零售和金融行业复用程度最高的应用场景,在客户咨询与服务、营销文案生成、商品摘要生成、电商直播、数字人、研报生成、金融分析等领域将发挥广泛的落地价值。
腾讯 AI Lab 是腾讯的企业级 AI 实验室,于 2016 年 4 月在深圳成立。实验室由 100 余位来自世界知名院校的科学家,以及 300 多位经验丰富的应用工程师组成,并与世界顶级院校与机构合作,共同打造产学研用一体的 AI 生态。目前,实验室已在 ICML、CVPR、NeurIPS、ACL、ICASSP 等多个顶级学术会议或期刊累计入选论文超过 780 篇。在基础研究方面,关注机器学习、计算机视觉、语音技术及自然语言处理等四大方向,780 多篇研究论文已覆盖国际顶级学术会议。在技术应用方面,聚焦在游戏、数字人、内容、社交四大领域,在微信、QQ 等 100 多个产品中落地。在自然语言处理方向,腾讯 AI Lab 旨在借助腾讯丰富应用场景、大数据、计算力及一流人才方面的长期积累,赋予计算机系统以自然语言文本方式与外界交互的能力,追踪和研究最前沿的自然语言文本理解和生成技术,孵化下一代自然语言处理技术与商业应用场景。研究方向包括文本理解、文本生成、智能对话、机器翻译等。除腾讯 AI Lab 之外,腾讯 QQ 浏览器实验室、微信 AI 实验室等均设有 NLP 方向的研究团队。张正友,腾讯首席科学家、腾讯 AI Lab 及 Robotics X 实验室主任。1985 年本科毕业于浙江大学信息与电子工程系,于 1987 年在南锡第一大学(现洛林大学)获计算机科学硕士学位,并于 1990 年获巴黎第十一大学计算机科学博士学位。2021 年 1 月 8 日,张正友受聘腾讯历史上最高专业职级 ——17 级研究员 / 杰出科学家。俞栋,腾讯 AI Lab 副主任,主要研究领域涵盖自动语音识别、语音处理和自然语言处理等,是将深度学习技术成功应用到语音识别领域的开创者之一。作为 100 多项专利的发明人及开源软件 CNTK 的发起人和早期主要开发者,俞栋发表了多篇引领性的论文,获得了 IEEE 信号处理协会 2013、 2016、2020 和 2022 年的最佳论文奖(表彰过去 6 年内发表的最佳期刊论文),2021 年 NAACL 最佳长文奖, 2022 年 IEEE 信号处理杂志最佳论文奖(表彰过去 10 年内发表的最佳论文),以及 2022 年 IEEE 信号处理杂志最佳专栏奖(表彰过去 10 年内发表的最佳专栏文章),谷歌学术引用量高达 5 万多次,h-index 超过 80。他提出的理论与模型已经广泛用于业界的语音识别和处理系统中。腾讯公司的相关技术储备包括「混元」系列 AI 大模型、智能创作助手文涌(Effidit)等。混元系列 AI 大模型来自腾讯广告多媒体 AI 团队,完整覆盖了 NLP(自然语言处理)、CV(计算机视觉)、多模态等基础模型和众多行业 / 领域模型。去年,混元 AI 大模型团队推出了万亿级别中文 NLP 预训练模型 HunYuan-NLP-1T,该模型已落地于腾讯广告、搜索、对话等内部产品并通过腾讯云服务外部客户。智能创作助手「文涌」为腾讯 AI Lab 出品,实现融合了知识抽取、文本理解、文本生成、大规模预训练模型、经典语言模型、搜索等技术,具有智能纠错、文本补全、文本润色等功能,部分功能的实现使用「混元」系列 AI 大模型作为底层预训练模型。在 2 月 9 日对 ChatGPT 的相关回应中,腾讯公司表示:「目前,腾讯在相关方向上已有布局,专项研究也在有序推进。腾讯持续投入 AI 等前沿技术的研发,基于此前在 AI 大模型、机器学习算法以及 NLP 等领域的技术储备,将进一步开展前沿研究及应用探索。」科大讯飞在 NLP 方面同样有诸多研究积累。2005 年,科大讯飞研究院正式成立。2017 年 12 月 13 日,科技部批准依托科大讯飞股份有限公司建设认知智能国家重点实验室。这一实验室是科技部首批 20 家标杆全国重点实验室之一,多年来始终保持关键核心技术处于世界前沿水平,在去年曾获得 CommonsenseQA 2.0、OpenBookQA 等 12 项认知智能领域权威评测的第一。实验室瞄准国际认知智能技术的理论和技术发展前沿,面向国家重大战略需求和人工智能产业发展,以人机交互、智慧教育、智慧医疗、智慧司法等领域对认知智能技术的广泛和共性需求为牵引,重点开展语义计算、知识建模等认知智能基础理论及技术研究。与此同时,科大讯飞面向认知智能领域陆续开源了 6 大类、超过 40 个通用领域的系列中文预训练语言模型,成为业界最广泛流行的中文预训练模型系列之一,在 GitHub 获 13346 颗星,位列中文预训练模型星标数第一。 2 月 8 日,科大讯飞在投资者互动平台回应称,ChatGPT 主要涉及到自然语言处理相关技术,属于认知智能领域的应用之一,公司在该方向技术和应用具备长期深厚的积累。科大讯飞 AI 学习机将成为该项技术率先落地的产品,将于今年 5 月 6 日进行产品级发布。胡国平,认知智能全国重点实验室主任,科大讯飞高级副总裁,研究院院长,讯飞创始团队成员之一,中国科学技术大学兼职教授、博导,国家新一代人工智能重大专项指南专家,中国人工智能学会会士。自 1998 年以来,一直从事智能语音及人工智能核心技术研究及产业化工作,多次承担国家 863、自然科学基金以及省部级等层面的重大科研项目, 曾获国家科技进步二等奖、 国家信息产业重大技术发明奖、省科技进步一等奖、万人计划中青年领军人才等。美团搜索与 NLP 部是美团人工智能技术研发的核心团队,致力于打造高性能、高扩展的搜索引擎和领先的自然语言处理核心技术和服务能力,依托搜索排序、NLP(自然语言处理)、Deep Learning(深度学习)、Knowledge Graph(知识图谱)等技术,处理美团海量文本数据,打通餐饮、旅行、休闲娱乐等本地生活服务各个场景数据,不断加深对用户、场景、查询和服务的理解,高效地支撑形态各样的生活服务搜索,解决搜索场景下的多意图、个性化、时效性问题,给用户极致的搜索体验,构建美团知识图谱,搭建通用 NLP Service,为美团各项业务提供智能的文本语义理解服务。团队既注重 AI 技术的落地,也开展中长期的搜索、NLP 及知识图谱基础研究。目前项目及业务包括搜索引擎研发、知识图谱、智能客服、语音语义搜索、文章评论语义理解、智能助理等。快手 MMU 是负责快手短视频搜索系统以及视频理解的 AI 中台,业务覆盖 OCR,ASR,分词,NER 等基础 AI 算法;短视频分类,标签体系建设等中台技术;以及短视频搜索等系统服务。作为一款国民级短视频 App 背后的公司,快手的业务和 AIGC 息息相关。机器之心获悉,目前,快手正在开展大规模语言模型(LLM Large Language Model)正在开展大规模语言模型,并启动了相应专项,覆盖 LLM 模型训练、文案自动创作与生成、对话系统开发等领域。内部有关人士介绍称,快手在 LLM 领域的研究,更聚焦于用户体验的提升,以及和业务场景的融合。例如,对话系统在快手中的主要应用场景包括虚拟人、电商智能客服、智能助理等人机交互或人人交互场景。相关研究的推进,将赋予 LLM 与人类自然交互的能力,对于 to B 类业务场景的扩展将有重要帮助。王仲远,快手技术副总裁、MMU&Y-tech 负责人。曾担任 Facebook 公司 Research Scientist,负责 Facebook 产品级 NLP Service。在 Facebook 之前,王仲远是微软亚洲研究院的主管研究员,负责微软研究院知识图谱项目和对话机器人项目。后任美团点评高级研究员、高级总监、搜索与 NLP 部负责人。2020 年 10 月,王仲远加盟快手,负责多媒体内容理解部。多年来专注于自然语言处理、知识图谱及其在文本理解方面的研究,在国际顶级学术会议如 VLDB、ICDE、IJCAI、CIKM 等发表论文数十篇。张富峥,博士,快手 MMU NLP 中心负责人。主要负责 NLP 及相关多模态技术在快手场景下的建设和应用,发表论文 60+ 篇,谷歌引用 7800+。张富峥博士入选了斯坦福大学发布的 「全球前 2% 顶尖科学家榜单」 以及 「2022 年人工智能全球最具影响力学者榜单 AI 2000 中的数据挖掘领域排名前 30 的最具影响力学者」。字节跳动人工智能实验室成立于 2016 年,其主要研究重点是开发为字节跳动内容平台服务的创新技术。实验室的研究领域包括自然语言处理、数据挖掘、计算机视觉、机器学习、计算机图形 & 增强现实、系统 & 网络、安全 & 隐私、语音与音频等。李航,字节跳动科技有限公司研究部门负责人毕业于京都大学,是东京大学博士,曾就职于 NEC 公司中央研究所、微软亚洲研究院、华为技术有限公司诺亚方舟实验室。他的主要研究方向是自然语言处理、信息检索、机器学习、数据挖掘。他还是 ACL Fellow 和 IEEE Fellow,也是《机器学习方法》等书的作者。在 AIGC 方向,字节跳动的研究成果包括非自回归模型 DA-Transformer、端到端语音到文本翻译模型 ConST、多颗粒度的视觉语言模型 X-VLM、图片和文本统一生成模型 DaVinci 等。其中 DA-Transformer 在机器翻译上首次达到了 Transformer 同样的精度,而处理的速度提高了 7~14 倍。DA-Transformer 不仅可以用于机器翻译,而且可以用于任意的序列到序列任务。小米在 2014 年成立小米 AI 研究院,其前身为小米探索实验室,2016 年初正式成立小米 AI 实验室,研究方向包括计算机视觉、声学、语音、NLP、知识图谱、机器学习等多个领域。作为一家以智能手机、智能硬件和 IoT 平台为核心的消费电子及智能制造公司,小米关注基于硬件的 AI 技术支撑,将语音交互作为基础能力进行构建,优势体现在应用场景多样化、数据丰富度高。在自然语言处理核心技术上,团队重点打造了搜索、推荐、广告、多模态、机器翻译、人机对话和文本创作等方向。王斌,小米 AI 实验室主任,NLP 首席科学家,本科、硕士毕业于武汉大学,博士毕业于中科院计算所。加入小米之前在中科院从事 NLP 及信息检索的研发工作,曾为中科院研究员、博导,研究方向为信息检索与自然语言处理。目前主要负责小米 AI 实验室的技术研发和落地工作。小米 AI 实验室的搜索、推荐、广告等技术支持了小米商城、有品、新零售、广告推荐等业务。- 利用多模态技术自动生成广告创意,成功支持广告投放。
- 机器翻译广泛应用到小爱同学、手机、MIUI 传送门与网页翻译、小爱老师、小爱鼠标等设备。设备端翻译体验业界领先,同声传译已上线到小爱面对面同传、会议同传、AI 字幕、通话翻译等场景,成为小米高端机型产品宣传页功能。
- 人机对话方面重点研发了闲聊对话功能,是小爱同学在手机、音响等重要设备中用户最喜欢使用的功能之一。
- 机器写作基于最新的预训练生成技术在对联、诗歌生成领域达到接近人类水平的效果,应用到小爱同学节日运营传播;语言风格转换技术成功支持了小爱同学多款自定义音色的语言风格定制。
目前,华为未对「是否开展类 ChatGPT 产品研发」的问题进行具体回应。华为计算产品线相关负责人就「华为在大模型的布局」回应称,公司 2020 年在大模型开始有布局,2021 年基于昇腾 AI 与鹏城实验室联合发布了鹏程。盘古大模型,是业界首个千亿级生成和理解中文 NLP 大模型。2021 年 4 月的华为开发者大会 2021(Cloud)上,华为云便发布了盘古系列超大规模预训练模型,包括 30 亿参数的视觉(CV)预训练模型,以及与循环智能、鹏城实验室联合开发的千亿参数、40TB 训练数据的中文语言(NLP)预训练模型。在大模型产业化方面,华为已发起了智能遥感开源生态联合体、多模态人工智能产业联合体、智能流体力学产业联合体等。华为将以联合体的模式把科研院所、产业厂商等结合起来,更好地让大模型产业形成正向的闭环回路。这些联合体由国内多个学界、业界机构组成,他们围绕自身与华为构建的一些基础设施展开大模型研究。比如:- 中科院自动化所基于昇思 MindSpore 打造了全球首个千亿参数三模态大模型紫东。太初,通过跨模态语义关联达成了视觉 - 文本 - 语音三模态的统一表达和高效协同;
- 鹏城实验室基于昇思 MindSpore AI 框架打造了面向生物医学领域的 AI 平台 —— 鹏程。神农,包含蛋白质结构预测、小分子生成、靶点与小分子相互作用预测以及新抗菌多肽设计与效果评价等模块,深度赋能生物制药;
- 武汉大学利用武汉人工智能计算中心 AI 集群推出了武汉.LuoJia,包含全球首个遥感影像智能解译专用框架武汉.LuoJiaNET 和业界最大遥感影像样本数据集武汉.LuoJiaSET,并已于今年 6 月分别上线昇腾和昇思社区。
田奇,计算机视觉、多媒体信息检索专家,IEEE Fellow。1992 年本科毕业于清华大学电子工程系,1996 年硕士毕业于美国德雷塞尔大学,后赴美国伊利诺伊大学香槟分校学习,师从 Thomas S. Huang 教授获博士学位。2002 年至 2019 年间,任美国德克萨斯大学圣安东尼奥分校计算机系助理教授、副教授和正教授。2018 年至 2020 年间,任华为诺亚方舟实验室计算视觉首席科学家。2020 年 3 月,加入华为云,任华为云人工智能领域首席科学家。华为云盘古预训练大模型包括自然语言处理大模型、视觉大模型、多模态大模型、科学计算大模型、图网络大模型等多个系列大模型,可实现一个 AI 大模型在众多场景通用、泛化和规模化复制,减少对数据标注的依赖,让 AI 开发由作坊式转变为工业化开发的新模式。在预训练模型 + 微调的模式下,开发周期能够缩短到几天,甚至几个小时。与 OpenAI GPT-3 相比,华为盘古 NLP(自然语言处理)同样达到千亿级参数量,并且,盘古 NLP 是全球最大的中文语言 AI 训练大模型。2021 年 9 月,浪潮发布参数量为 2457 亿的中文语言大模型」源 1.0」,比此前 OpenAI 发布的 GPT-3 大模型,参数量增加 40%,训练数据集提升 10 倍,」源 1.0」发布时即获得中文语言理解评测基准 CLUE 榜单的零样本和小样本学习两类总榜冠军。2022 年,浪潮深入推进「源 1.0」开源开放计划,持续加强开发者社区建设及行业应用落地,当前社区已经拥有超过 3000 名开发者,打造了「AI 剧本杀」、「 心理咨询 AI 陪练」、「AI 反诈」「金陵诗会」等爆款应用,推出了对话、问答、翻译、古文等技能大模型 (Skill Model)。浪潮信息基于「源」大模型驱动的企业」智能客服大脑」,荣获了《哈佛商业评论》新技术突破奖。此外,大模型在巨量算力、海量数据和高效平台等方面的超高门槛,成为了当前 AI 领域众多初创企业、创新团队、大学或研究机构进行生成式 AI 研发创新方面的主要障碍。浪潮信息已推出相关 AI 算力服务,以加速国内 AIGC 创新步伐、赋力生成式 AI 产业创新的出发点。ChatGPT 的蹿红让其背后的研发公司 OpenAI 成为了 AI 界的当红炸子鸡。这家公司在 2015 年由一群科技领袖创办,包括山姆・阿尔特曼(Sam Altman)、彼得・泰尔(Peter Thiel)、里德・霍夫曼(Reid Hoffman)和埃隆・马斯克(Elon Musk)等,最初只是一家致力于学术研究的小型非营利性实验室。从反响平平的 GPT-1 到今天名声大噪的 ChatGPT,这家公司几度沉浮终见曙光。在国内,我们同样能看到一批非营利性研究机构的诞生和蓬勃发展。2018 年,北京智源人工智能研究院在科技部和北京市支持下,联合北京人工智能领域优势单位共建。成立三年多以来,智源研究院始终聚焦原始创新和核心技术,在北京建成全球最佳的人工智能创新生态,打造世界人工智能的「学术高地」。2021 年 3 月 20 日,智源研究院发布了我国首个超大规模智能模型系统「悟道」的第一阶段成果。「悟道」由智源研究院牵头,汇聚清华、北大、人大、中科院等高校院所,以及诸多企业的 100 余位 AI 领域专家共同研发,从基础性能、有效使用到预训练模型扩展,提出一系列创新解决方法,取得多项国际领先的 AI 技术突破和多个世界第一。2021 年 6 月,智源研究院发布「悟道 2.0」巨模型,以 1.75 万亿的参数量成为当时全球规模最大的预训练模型。不仅如此,悟道团队还基于 GPT 与 BERT 各自在自然语言生成(NLG)和自然语言理解(NLU)任务上的优点,成功将两者融合并提出通用语言模型 GLM,将所有自然语言任务都化归为生成任务进行统一处理,GLM 也成为首个在 NLU、NLG、Seq2Seq、不定长填空等任务中全部登顶的语言模型。鹏城实验室是中央批准成立的突破型、引领型、平台型一体化的网络通信领域新型科研机构。实验室拥有一支由院士专家、杰出领军人才、中青年骨干、博士生团队组成的多层次合理人才队伍,建成了以「鹏城云脑」「鹏城靶场」为代表的若干重大科技基础设施与平台,发布了「丝路」多语言机器翻译平台、「鹏程·盘古」中文预训练语言模型等一系列重大应用。其中,网络智能研究部由高文院士领衔,拥有全球领先的智能算力大科学装置「鹏城云脑」,贯通云态智能计算软件体系,研制体系化网络智能集群开源软件栈,突破感知、评价、决策一体化的多维度协同与持续进化的云网协同智能等共性关键技术,支撑智能制造、物联网、工业云、人工智能等规模化产业应用。研究部设有云脑研究所、高效能云计算研究所、视觉智能研究所、云脑使能研究所。研究部人员构成多元化,现有全职、博士后、双聘、访问学者、联培博士生等 500 多人,团队成员均来自海内外知名高校。高文,现任中国工程院院士、鹏城实验室主任,北京大学博雅讲席教授,新一代人工智能产业技术创新战略联盟理事长,全国专业标准化技术委员会副主任,数字音视频编解码技术标准 (AVS) 工作组组长,国际电气和电子工程师协会会士(IEEE Fellow)、美国计算机协会会士(ACM Fellow)。曾任第十届、十一届、十二届全国政协委员,国务院学科评议组计算机学科成员,中国计算机协会理事长,计算机学报主编;2013 年至 2018 年,在国家自然科学基金委员会工作,任自然科学基金委副主任。2018 年被聘为鹏城实验室主任。曾一次获得国家技术发明一等奖、一次获得国家技术发明二等奖、五次获得国家科技进步二等奖,获得「2005 中国十大教育英才」称号和中国计算机学会王选奖。主要从事人工智能应用和多媒体技术、计算机视觉、模式识别与图像处理、虚拟现实方面的研究,主要著作有《数字视频编码技术原理》、《Advanced Video Coding Systems》等。在本领域国际期刊上发表论文 200 余篇,国际会议论文 600 余篇。粤港澳大湾区数字经济研究院(International Digital Economy Academy,简称「IDEA 研究院」)的使命为「推动人类 AI 技术发展,立足社会需求研发颠覆式创新技术,并回馈社会,让更多的人从数字经济发展中获益。」研究院实行理事会领导下的院长负责制,由沈向洋博士担任理事长,理事会成员包括:中国工程院院士、鹏城国家实验室主任高文,深圳市科技创新委员会主任梁永生,福田区委副书记、区长黄伟,香港科技大学首席副校长倪明选。研究院目前已聚集一批包括院士、世界著名大学教授、世界知名开源系统发明人在内的国际一流技术专家,致力于在 AI 基础技术与开源系统、人工智能金融科技、区块链技术与机密计算、企业级 AI 系统、产业智能物联网与智能机器人等领域研发国际顶尖成果,并培育一批国际领先科技企业,带动深圳乃至大湾区万亿级数字经济产业发展。IDEA 研究院认知计算与自然语言研究中心(CCNL,Cognitive Computing and Natural Language)致力于在预训练大模型时代建设认知智能的基础设施、推动 AI 学术和产业发展。目前,研究中心在预训练模型生产、少样本 / 零样本学习、受控文本生成、自动化机器学习等技术领域,都达到了领先水平。沈向洋,IDEA 研究院创始人、理事长。沈向洋博士是美国国家工程院外籍院士和英国皇家工程院外籍院士,计算机科学与人工智能领域的世界级专家和全球科技产业领袖,在学术界、企业界、投资界拥有重要影响力。沈博士曾担任微软公司全球执行副总裁,主管微软全球研究院和人工智能产品线,并负责推动公司中长期总体技术战略及前瞻性研究与开发工作。他参与创建了微软亚洲研究院,担任院长兼首席科学家,培养了众多国际一流的计算机科学家、技术专家和企业家。张家兴,IDEA 研究院认知计算与自然语言研究中心讲席科学家。北京大学博士,清华大学、香港中文大学、香港科技大学等兼职 / 实践教授。曾任微软亚洲研究院研究员、蚂蚁集团资深算法专家、360 数科首席科学家 / 副总裁。在 IDEA 研究院期间,张家兴博士带领团队创建了中文最大的开源预训练模型体系「封神榜」,也成功于近期开源中文第一个 Stable Diffusion 模型太乙。封神榜开源大模型体系包括封神榜大模型、封神框架、封神榜单三个子项目,将数据和算力沉淀成具有认知能力的预训练模型,目标是成为海量下游任务和各种算法创新研究的坚实基础。其中「二郎神」模型已获得中文 NLP 权威榜单 FewCLUE 与 ZeroCLUE 的双料冠军。杭州元语智能科技有限公司成立于 2022 年,是一家致力于提供通用人工智能技术(AGI)的初创公司。公司愿景是「坚定通用人工智能信仰,持续不断在全球范围内,为实现可靠、有效、无害的通用人工智能贡献中国力量,让人类受益」。元语智能训练了元语 AI(ChatYuan)模型,它可以通过对话形式进行交互。模型可以用于回答问题、可以结合上下文做对话、做各种生成任务,包括创意性写作,也能回答法律、新冠等领域类问题。它基于 PromptCLUE-large 结合数亿条功能问答和多轮对话数据进一步训练得到。目前已经提供支持功能型对话的开源中文大模型免费下载及 API 服务,以及基于网页、小程序的类「ChatGPT」的机器人交互产品等。据天眼查信息显示,该公司成立于 2022 年,是一家以从事软件和信息技术服务业为主的企业,注册资本 100 万元人民币,持股 50% 的大股东徐亮也是杭州敬天爱人管理咨询合伙企业大股东,持股 70%。后者主要从事商务服务业,注册资本 100 万人民币,以 40 万元金额投资了元语智能,持股 40%。元语智能另一家持股 10% 的股东为西湖心辰(杭州)科技有限公司,创始人为蓝振忠。2 月初,元语智能推出了国内首个基于大模型的功能型对话产品 ChatYuan。ChatYuan 可以用于问答、结合上下文做对话、做各种生成任务(包括创意性写作),也能回答一些像法律、医疗等领域问题。元语智能表示,国内无论是大型科技公司还是创业公司,目前都面临着各式各样的挑战,很难有像 OpenAI 的资源和人才密度。国内创业公司或许在一段时间内可以专心技术研发,但很快就会受到盈利压力的挑战,而不断调整战略方向。大型科技公司虽然看起来资源充足,但是很少能在未有落地成效的情况下,坚定信念进行长期持续投入基础设施建设。在上线后不久,元语智能 ChatYuan 小程序页面提示已变更为「系统更新维护中」。2月21日,ChatYuan 发布升级版本,支持中英双语交互、多次编辑、上下文关联交互、模拟情景设定等多种新功能。澜舟科技是业界领先的认知智能公司,致力于以自然语言处理(NLP)技术为基础,为全球企业提供新一代认知智能平台,助力企业数字化转型升级。其主要产品是基于「孟子轻量化模型」打造的一系列 SaaS 功能引擎(包括搜索、生成、翻译、对话)等和垂直场景应用。澜舟科技拥有自主知识产权的「孟子轻量化预训练模型」,并融入了类 ChatGPT 的底层技术,在 AIGC 技术生成内容等方面有所布局。周明,澜舟科技创始人兼 CEO。世界著名的 NLP 专家、中国计算机学会副理事长,哈工大等 5 所学校博士导师。曾任国际计算语言学学会主席、微软亚洲研究院副院长。他是世界上发表 NLP 论文最多的学者之一,H-index 100。周明于 1991 年在哈工大获得博士学位,后在清华大学任教。1999 年加入微软亚洲研究院,长期领导 NLP 研究。2021 年创立澜舟科技,从事轻量化大模型和新一代 NLP 产品的研发,获北京 HICOOL(2021)创业大赛最高奖。2021 年 7 月,澜舟科技 - 创新工场团队与上海交通大学、北京理工大学等单位联合研发的中文语言模型 — 孟子轻量型模型,超越腾讯、搜狗等公司,在中文语言理解评测 CLUE 榜单上登顶第一,刷新业界记录。孟子预训练模型是基于澜舟团队自研技术研发的大规模预训练语言模型。可处理多语言、多模态数据,同时支持多种文本理解和文本生成任务,能快速满足不同领域、不同应用场景的需求。孟子模型基于 Transformer 架构,仅包含十亿参数量,基于数百 G 级别涵盖互联网网页、社区、新闻、电子商务、金融等领域的高质量语料训练。循环智能创立于 2016 年,为企业提供从全渠道沟通数据采集到录音转写、内容挖掘、NLP 语义建模、会话分析洞察和沟通实时辅助的完整解决方案。运用 NLP、语音、多模态、大模型等人工智能技术打造「销售科技」方案,帮助企业的销售团队提升销售业绩。杨植麟,循环智能联合创始人,清华大学交叉信息院 NLP 实验室负责人,智源青年科学家。本科毕业于清华大学,博士毕业于卡内基梅隆大学,Google Scholar 引用累计 10,000 余次,与多名图灵奖得主合作发表论文。作为第一作者发明的 XLNet 在 20 项任务上超越 Google BERT,是 2019 年全球引用最高的同行评审 NLP 论文。他发明的 Transformer-XL 是首个全面超越 RNN 的注意力语言模型,也是 ACL 2019 引用最高的论文。曾主导开发盘古 NLP 大模型,获世界人工智能大会「 2021SAIL 之星」,入选福布斯亚洲 30 under 30。他创办的公司循环智能累计融资超 4 亿元,连续三年营收增长超 100%。追一科技是一家企业级智能服务 AI 公司,创立于 2016 年 3 月,主攻深度学习和自然语言处理,为金融、零售、生活服务等领域企业提供智能服务系统和解决方案。追一科技的智能服务系统 AIforce,拥有 AI 语义理解能力、智能产品矩阵。「我们始终站在自然语言处理(NLP)技术研发和实践的前沿,在大规模预训练模型、自然语言智能交互(NL2X)、NLG(自然语言生成)等领域屡有创新,并将我们的技术成果开放给业界,持续推动 NLP 技术的发展。」追一在机器阅读理解与 NL2SQL 技术上拥有深厚积累,举办了国内首个中文 NL2SQL 比赛,并在机器阅读理解比赛中多次登顶榜首。2021 年 4 月,追一科技开源了国内首个中文生成式预训练模型 T5 PEGASUS,在自动摘要、问题生成多个自然语言处理任务上达到了新高度。凭借出色的小样本学习能力,T5 PEGASUS 可以帮助企业和开发者大大减轻数据标注训练负担。2021 年 11 月,追一科技联合粤港澳大湾区数字经济研究院(IDEA)发布 10 亿级大规模预训练模型「周文王」。类似于 ChatGPT 这样的大模型,对于任何一家企业来说,训练成本都是极高的。即使花巨资使用超级计算机集群、聘请专家,也难以实现 AI 模型的高效训练。针对这一行业痛点,也有很多初创公司在提出自己的解决方案,潞晨科技就是其中的代表。2021 年,潞晨科技发布大规模并行 AI 训练系统 ——「夸父」(Colossal-AI) ,通过多维并行、大规模优化器、自适应任务调度、消除冗余内存、降低能量损耗等方式,旨在打造一个高效的分布式人工智能训练系统,作为深度学习框架的内核,帮助用户在最大化提升人工智能训练效率的同时最小化训练成本。潞晨科技的团队核心成员均来自美国加州大学伯克利分校,斯坦福大学,清华大学,北京大学,新加坡国立大学,新加坡南洋理工大学等国内外知名高校。
尤洋,潞晨科技董事长兼总裁,新加坡国立大学校长青年教授。尤洋是 UC Berkeley 博士,曾创造 ImageNet 和 BERT 训练速度世界纪录,获 IPDPS 和 ICPP 最佳论文,西贝尔奖学金,ACM-IEEE HPC Fellowship,Lotfi A. Zadeh Prize,ACM Doctoral Dissertation Award,福布斯 30 岁以下精英榜(亚洲),IEEE-CS 超算杰出新人奖。小冰公司前身为微软(亚洲)互联网工程院人工智能小冰团队,是微软全球最大的人工智能独立产品研发团队。该团队于 2013 年 12 月在中国组建,2014 年 9 月扩展建立日本研发分部,团队分布于北京、苏州、东京等地,技术产品覆盖中国、日本及印度尼西亚等多个国家,商业客户覆盖全球范围。为加快小冰产品线的本土创新步伐,促进小冰商业生态环境的完善,2020 年 7 月 13 日,微软宣布将小冰分拆为独立公司运营。作为微软全球首个以中国为总部的人工智能产品线,小冰经多年发展,已成为微软最有价值的人工智能技术框架之一。小冰框架以自然语言处理(NLP)为基础,持续推动完备迭代发展,目前是全球承载交互量最大的完备人工智能框架之一,技术覆盖自然语言处理、计算机语音、计算机视觉及人工智能内容生成。其中,在开放域对话、多模态交互、超级自然语音及内容生成领域居于全球领先。
李笛,2013 年加入微软,同年创立微软人工智能情感计算框架,于 2014 年推出微软小冰。小冰是目前全球范围内承载交互量最大的人工智能系统,占全球交互总量 60% 以上。2020 年 7 月,微软宣布将小冰分拆为独立公司运营,李笛担任小冰公司 CEO。徐元春,小冰公司首席运营官、人工智能创造力实验室负责人,CCF 计算艺术分会执行委员,中国音像与数字出版协会音乐产业促进工作委员会专家委员会特聘专家,中国乐器协会未来音乐科技专业委员会委员。从 2017 年开始领导团队从事小冰在 AI 创造领域的技术研发、产品革新和应用落地。致力赋予 AI 拟合人类的创造能力,运用 AI 技术展开具有创造性的内容生成,并倡导通过 AI 技术解决高度定制化内容的供需矛盾。目前在文本、声音与视觉方面掌握全球领先的核心技术,拥有丰富的包括端到端的音乐创作(作词,作曲,编曲)、诗歌(现代诗,古诗)、绘画(西方油画,中国画)、艺术设计等创造模型,在 AI 创造领域不仅内容形态众多且质量稳定,并已形成完善的产品线,以及广泛的合作伙伴生态阵营。思必驰是国内专业的对话式人工智能平台公司,拥有全链路的智能语音语言技术,自主研发了新一代人机交互平台(DUI),和人工智能芯片(TH1520);为车联网、IoT及政务、金融等众多行业场景合作伙伴提供自然语言交互解决方案。截至2021年底,思必驰拥有各类已授权知识产权900余件,其中已授权专利近400项,软件著作权近300项。并拥有中英文综合语音技术。思必驰语音识别、声纹识别、口语对话系统等技术曾经多次在美国国家标准局、国际研究机构评测中夺得冠军。
思必驰被列入国家发改委「互联网+」重大工程和人工智能创新发展工程、工信部人工智能与实体经济深度融合创新项目、江苏省工业和信息产业转型升级项目、江苏省科技计划项目等,并累计参与40余项国家标准、行业标准制定。凭借雄厚的AI技术实力与广泛的产品业务落地,2020年,思必驰完成pre-IPO轮融资;2021年3月,思必驰完成股份制改造,正式更名为:思必驰科技股份有限公司。
俞凯,思必驰创始人、首席科学家、上海交大教授上海交通大学-苏州人工智能研究院执行院长。剑桥大学工程系博士,入选国家级人才工程、科技部中青年科技创新领军人才,国家自然科学基金委优青。中国计算机学会语音对话及听觉专业组副主任,中国人工智能产业发展联盟学术和知识产权组组长,中国语音产业联盟技术工作组副组长。2014年获得“吴文俊人工智能 科学技术奖”进步奖,2016年获评“科学中国人年度人 物”。IEEE高级会员,IEEE Speech and Language Processing Technical Committee委员。 在一流国际期刊和会议上发表论文 180 余篇,担任InterSpeech、ICMI等国际权威学术会议程序委员会主席,以及ACL、EMNLP、InterSpeech等国际会议的语音和对话技术领域主席,多次获得国际权威期刊和会议优秀论文奖,以及多个国际公开研究评测竞赛冠军。
面壁智能(ModelBest)是一家人工智能大模型加速与应用落地赋能公司。公司依托开源社区打造大规模预训练模型库与相关工具,加速百亿级以上大模型的训练、微调与推理,降低大模型使用门槛,并进一步推动大模型在人工智能典型场景与领域的应用与落地。公司创始团队来自于清华大学计算机系自然语言处理与社会人文计算实验室,并由知名清华大学教授担任首席科学家。公司目前已完成百万级天使轮融资,并与知名机构与公司达成战略合作。AIGC 初创企业聆心智能由清华大学黄民烈教授创立,成立于 2021 年 11 月,由清华大学计算机系孵化。团队核心成员均来自于清华大学、卡内基梅隆大学、谷歌等国内外顶尖高校及公司,具有丰富的商业化经验。聆心智能的核心人员是国内最早开展大模型底层技术的团队,在语言生成、对话生成方面具有独特的技术优势。自成立以来,聆心智能致力于将最先进的人工智能技术应用到健康服务上,通过建立先进的 AI 体系,为临床患者和广大心理亚健康人群提供高质量、低成本、个性化、全天候的情绪支持、心理咨询和干预方案,为用户提供更科学、高效的健康服务。作为 AI 心理赛道中自然语言处理基因领先的创业团队之一,聆心智能已开发了心理咨询及朋辈支持服务线上平台聆心悠然、AI 软件聆忧,可为不同需求层次的用户提供服务。基于生成式大模型,聆心智能打造了 Emohaa 情绪疗愈机器人,并与知名心理平台好心情达成合作,成功落地了国内首款人工智能心理陪伴数字人;与高端豪华电车品牌 Beyonca 合作,打造了新一代智能驾舱的贴心助手。同时,聆心智能自研全球技术指标领先的中文对话大模型 OPD,在自动评测和人工评测中显著优于同类模型;去年 11 月,推出了首个超拟人 AI 产品 ---「AI 乌托邦」,该系统允许用户快速定制 AI 角色,只需要输入简单的角色描述,就可以生成相应人设的 AI ,与之进行深度对话和聊天。最后说明,这是一份不完整的盘点,欢迎机器之心的读者们留言介绍自己觉得非常有实力的 NLP 团队与个人。建议留言格式:【机构名称 + 代表成员 + 代表成果】或者【姓名+个人简介】,机器之心会精选留言让更多人看到。这是一份全面、系统且高质量的 ChatGPT 文章合集,我们筛选出来了 89 篇相关文章,设计了阅读框架与学习路径,大家可以根据自己的需求进行浏览与研读。合集内容包括:
ChatGPT 及 OpenAI 大事件时间轴
概念·真正搞懂 ChatGPT:共 3 篇文章
研究·GPT 家族更迭:共 16 篇文章
八年·OpenAI 的历史与现在:共 13 篇文章
干货·GPT 相关研究与技术:共 18 篇文章
观点·专家谈 ChatGPT:共 8 篇文章
行业·应用与探索:共 23 篇文章
行业·同类产品:共 8 篇文章
点击阅读原文,开始学习ChatGPT。
投稿或寻求报道:content@jiqizhixin.com