- 0
- 0
- 0
分享
- 养分|极致的视觉体验:漫谈超分辨率技术
-
2021-03-24
本文转载自微信公众号:虚拟空间艺术
影视剧中,警察在追踪嫌犯时,经常会出现观看监控视频拍摄录像的桥段,警察把画面暂停,将嫌犯的脸部放大进行人脸比对或将交通工具局部放大以获得更多的破案线索,本来模糊不清的画质放大后反而变清晰了!这着实是不合常理,观众却早已习以为常,将这归功于影片设定下的神奇黑科技。但排除影片的戏剧化处理,这种剧情存在的真实性有多少呢?答案是:大有可能。运用超分辨率重构图像就能解决这个问题。
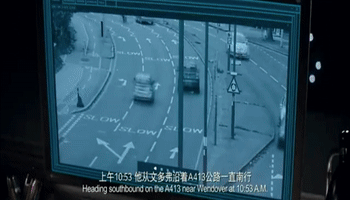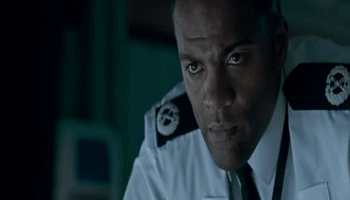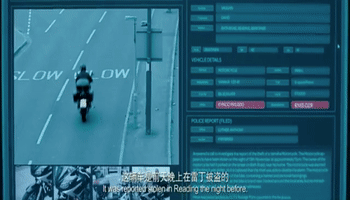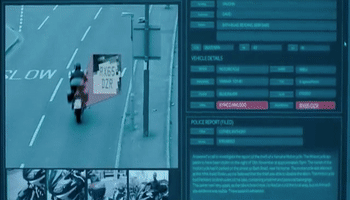
图 1参考画面
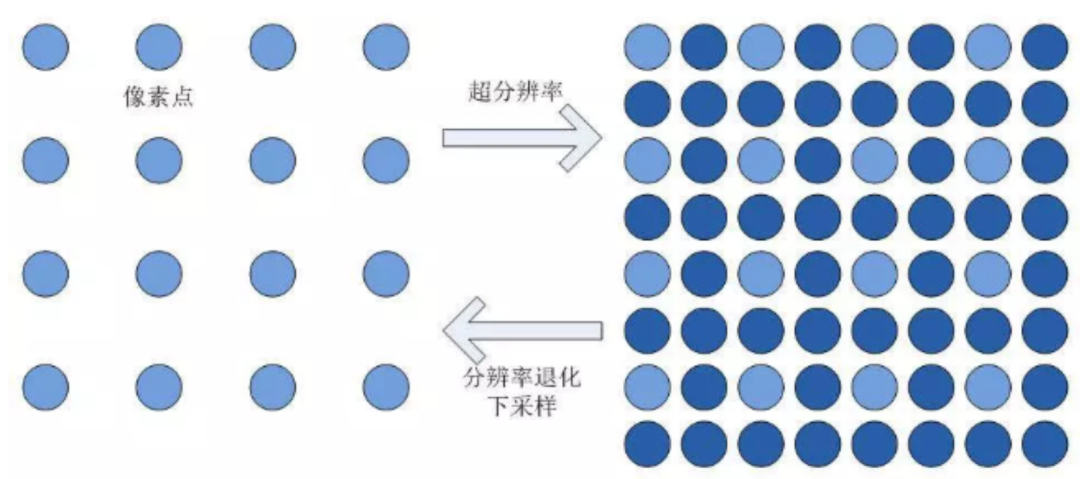
超分辨率(Super-Resolution)是通过软件或硬件的方式提高原有图像的分辨率,通过填充缺失的细节,从相应的低分辨率图像中生成高分辨率图像。下图很直观地表明了超分辨率的过程——在像素点的空间位置增加更多的像素点进行填充,更多的像素点代表更丰富的细节。它是计算机视觉研究的重要课题,现代的超分算法多依靠深度学习来实现。
除了上文所说的视频监控与安防的实际场景外,这项技术在视频图像修复重建中也有着广泛的应用。超分变率技术能够复原低像素的老照片、老视频,不久前微博用户“大谷Spitzer”就用AI技术修复了一段人民日报发布的100年前的北京城影像。原视频来自一位加拿大摄影师拍摄的黑白影片,分辨率很低,画面模糊不清。修复后的影像有了色彩,分辨率也提升了。快点开下面的视频体验穿越的感觉吧!
随着影像分辨率的提高,观众已经习惯观看4k及以上的画质,一些经典的老电影,由于技术、设备、保存不当等原因,很难达到目前的放映分辨率标准,实在令人惋惜。好在超分技术的发展,让经典得以“重生”。最近,VideoGorillas公司研发了一种生产辅助人工智能技术“Bigfoot超分辨率提升系统”,通过使用神经网络来预测丢失的像素,从而将480p电影转换为4K电影,这些像素的质量高得令人难以置信,使老电影焕发出新的光彩。说到这里,也许会有人疑问AI恢复后的影片是否还能保留影像本身的视觉风格?答案是肯定的。VideoGorillas的研究团队为每个项目训练了独特的递归神经网络(RNN),机器会学习同一时代、类型、制作方法创作的作品特点,并应用到影片的重建中,尽可能地保留影片原有的风格。

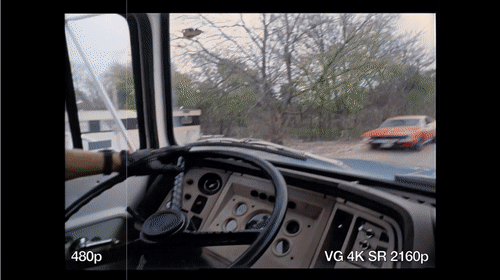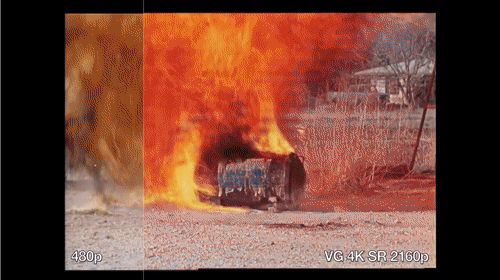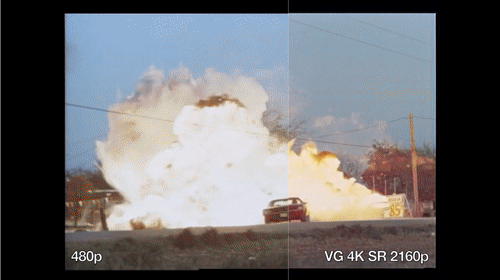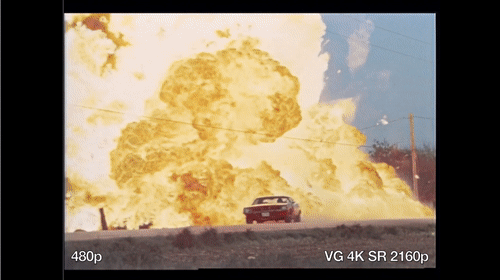
效果演示
与4K相比,近年大火的IMAX电影分辨率理论上可以达到18 K!也就是每帧分辨率18000✖13433。正常来说这种规格需要特殊的IMAX摄影机+胶片来完成,但以这种摄影机+胶片的顶级配置完成全片的拍摄需要巨大的成本,所以市面上的IMAX电影一般来说会采用IMAX摄影机拍摄部分镜头(比如诺兰的《敦刻尔克》就用IMAX 70mm胶片摄影机拍摄了70%的镜头),而对于非IMAX制式拍摄的影片就会使用数字原底翻版技术(DMR)进行转制,简单来说就是1、扫描胶片获得数字画面/原始画面为数字形式;2、对数字画面进行影像增强处理,这一步很大程度上依赖超分技术;3、经过增强处理后的高分辨率的数字信号被录制到胶片或IMAX数字硬盘上,供IMAX影院放映。
数字时代的到来,改变了信息传递的手段和方式。包含了大量视觉信息的图像和视频以数据的形式通过互联网传输,遍布在我们的日常生活中。不同尺寸的显示设备对于图像或视频分辨率的要求不同,这就涉及到分辨率的转换问题。举个具体的例子,最近网易云信将AI超分技术应用到了点播直播和实时音视频中,在视频或图像的发送源可能会因为摄像头采集能力不足、网络带宽不足、源端处理能力不足等原因无法传输高分辨率的文件,在终端设备上,网易云信可以动态加载超分模型,做到2-3倍的分辨率重建,使手机直播、移动终端实时视频通话、短视频、图片等应用场景的模糊图像、视频瞬间变高清,提升用户的视觉体验。
上文说了这么多高端的超分技术,其实在日常生活中,我们也能通过在线超分神器将模糊照片秒变清晰。waifu2x是一个使用卷积神经网络对动漫风格的图片进行放大操作的在线网站。其操作界面如下:
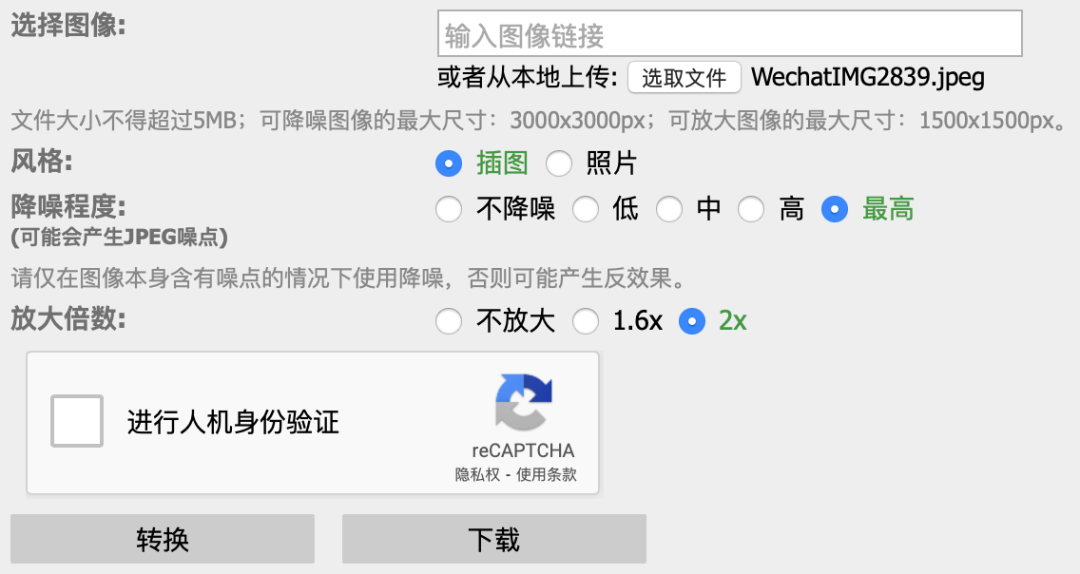
笔者用波妞的图片测试转换效果,设置参数见上图,下图绿线左为超分后,右图为原图。
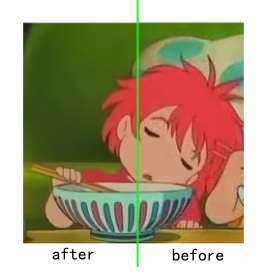
类似的网站还有PhotoEnlarger、Gigapixel AI、Let’s Enhance、Bigjpg,可以针对照片、数码绘画等不同类型的原素材进行不同算法的超分计算。
视频超分辨率一直是深度学习领域研究人员致力解决的问题。通常来说,超分辨率技术可以分为两种:只参考当前低分辨率图像的单幅图像超分辨率(single image super resolution),及参考多幅图像或多个视频帧的超分辨率技术——多图/帧超分辨率(multi-frame super resolution)。对视频超分项目而言,后面的方法显然更可取,视频帧内的信息十分丰富,微小的抖动变化都能够作为信息用于增强低分辨率帧的细节。当然了,与图像超分相比,视频超分辨率的技术更加复杂,不仅需要生成高分辨率的帧图像,还需保持每帧图像之间的连贯性,但同时因为有连续性的视频帧信息,所包含的跨位置的空间信息和跨帧的时间信息都可以为低分辨率帧的增强提供帮助。
解决视频超分任务的算法已有很多,在文章《基于深度学习的视频超分辨率:综合调查(Video Super Resolution Based on Deep Learning: A comprehensive survey)》中,研究人员就对基于深度学习的33种最先进的视频超分技术进行研究,利用帧间信息的方式将这些方法分为六类,并详细描述了所有方法的体系结构和实现细节。最后将一些代表性的视频超分方法在基准数据集上的表现进行比较,并提出了一些视频超分算法有待解决的问题。该文章是对视频超分任务的首次系统回顾,有助于加深对基于深度学习的视频超分技术的理解,感兴趣的朋友可以找来阅读。
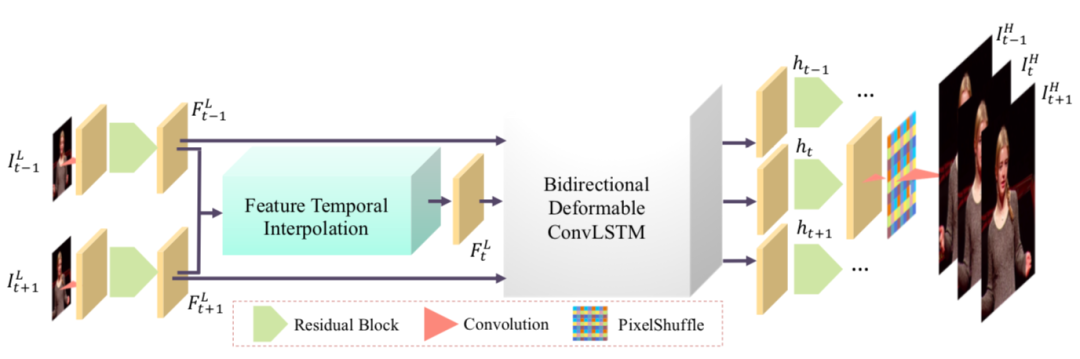
在CVPR 2020收录的文章中,《慢镜头变焦:快速准确的单阶时空超分(Zooming Slow-Mo: Fast and Accurate One-Stage Space-Time Video Super-Resolution)》更进一步讨论了时空意义上的视频超分问题,提出了一种由低帧率(LFR),低分辨率(LR)视频中生成高分辨率(HR)慢动作视频的方法。也就是说,除了视频逐帧的超分问题外,还需解决视频帧插值(VFI)的问题。通常情况下这类任务会分成两个子任务解决,但是时间插值和空间超分在这个任务中是内部相关的,且两阶段的模型通常包含大量参数,计算量大,所以研究人员提出了一个单阶时空视频超分框架(STVSR)来同时学习时间插值和空间超分辨率,可以直接从LFR、LR视频合成HR慢动作视频。利用所提出的特征时态插值网络,在捕获本地时态上下文的丢失LR视频帧中,对LR帧特征进行时态插值。然后提出一个可变形的convlst模型来同时对齐和聚合时间信息,以更好地利用全局时间上下文。最后,采用深度重构网络对HR慢动作视频帧进行预测。
下面是涉及的单阶STVSR框架:
下面是该方法结果的视频演示:
下面是该方法与其他两阶段(视频逐帧超分+视频帧插值)方法的数据集测试结果对比,标蓝标红的为表现最优秀的两个方法,可以看出文章中提出的方法运行速度比目前最新方法(DAIN+EDVR)要快三倍以上,效果更佳。
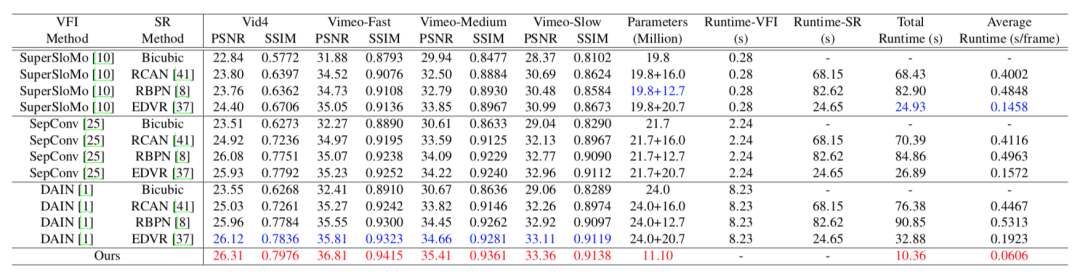
高分辨率的慢动作视频包含了精细的图像细节和清晰的运动动态,更具有视觉吸引力,在电影制作、高清电视等应用中非常受欢迎。上文提到的单阶STVSR框架很好地探索任务中时间插值和空间超分辨率之间的内在联系,一步到位地解决了慢动作视频的超分重建问题,为高清慢动作视频的呈现提供了一种新的可能性。
参考文献:
Xiang, X., Tian, Y., Zhang, Y., Fu, Y., Allebach, J.P. and Xu, C., 2020. Zooming slow-mo: Fast and accurate one-stage space-time video super-resolution. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition (pp. 3370-3379).
Liu, H., Ruan, Z., Zhao, P., Shang, F., Yang, L. and Liu, Y., 2020. Video super resolution based on deep learning: A comprehensive survey. arXiv preprint arXiv:2007.12928.
版式设计:韩碧
电影(电视)虚拟空间设计专业自2006年建立以来,以新技术变革下的电影为核心,拓展到未来视听形态和叙事表达的艺术与科技前沿,强调观念和视野的前瞻性,注重以多学科思维和手段实现艺术创新的聚合能力,为业界培养的本科生和研究生,获得众多国际重要奖项。
-
阅读原文
* 文章为作者独立观点,不代表数艺网立场转载须知
- 本文由 “数艺网” 授权数艺网发布,已由本站编辑优化排版。 转载请务必在开头或结尾标注 “作者:XXX | 来源:数艺网”,尊重原创及授权权益。 并附上本页链接: 本站部分图文取自网络,如涉及侵权问题,欢迎通过微信 ID:d-arts-cn 告知。我们会立即核实并及时处理,感谢您的理解与监督。
-
-
苏州
甲方 · 媒体平台
未认证的机构号