- 0
- 0
- 0
分享
- 只需训练一次,即可生成3D新场景!谷歌「光场神经渲染」进化史
-
2022-09-29
新智元报道
新智元报道
【新智元导读】NeRF的泛化性难题再被Google攻克!
视图合成(view synthesis)是计算机视觉和计算机图形学交叉领域的一个重点难题,指的是从一个场景的多张图片中创建该场景的新视图。
要准确地合成一个场景的新视图,一个模型需要从一小部分参考图片中捕捉多种类型的信息,比如详细的三维结构、材料和光照等。
自2020年研究人员提出神经辐射场(NeRF)模型以来,这个问题也受到了越来越多的关注,大大推动了新视图合成的性能。
其中一个超级大玩家就是Google,在NeRF领域也发表了诸多论文,本文将为大家介绍两篇Google发表在CVPR 2022和ECCV 2022上的论文,讲述光场神经渲染模型的进化。
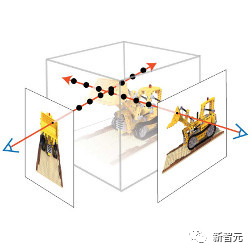
第一篇论文提出一个基于Transformer的两阶段模型来学习组合参考像素颜色,首先获得沿对极线(epipolar lines)的特征,然后获得沿参考视图的特征以产生目标射线的颜色,极大提升了视图重现的准确率。
论文链接:https://arxiv.org/pdf/2112.09687.pdf
经典光场渲染(Light Field Rendering)可以准确地再现与视图有关的效应,如反射、折射和半透明,但需要对场景进行密集的视图采样。基于几何重建的方法只需要稀疏的视图,但不能准确地模拟non-Lambertian效应,即非理想散射。
文中提出的新模型结合了这两个方向的优势并缓解了其局限性,通过对光场的四维表示进行操作,模型可以学会准确地表示与视图有关的效应。通过在训练和推理过程中强制执行几何约束,场景几何被隐含地从一组稀疏的视图中学习。
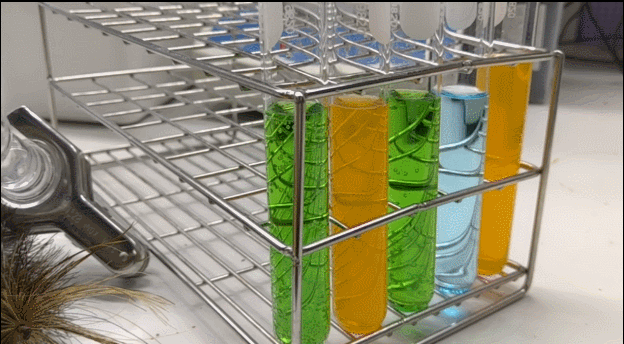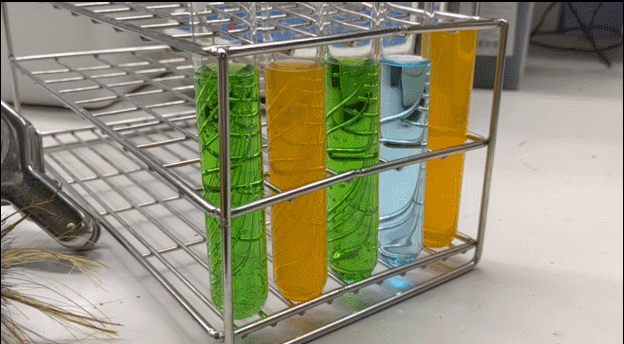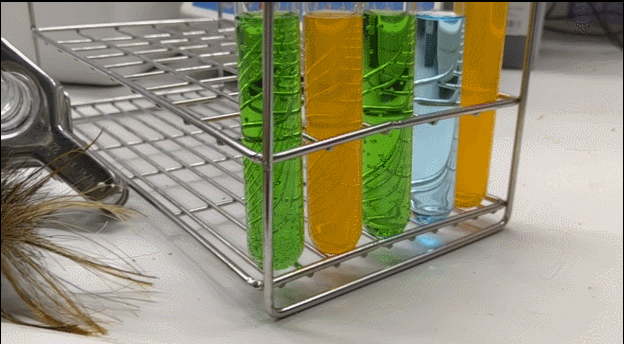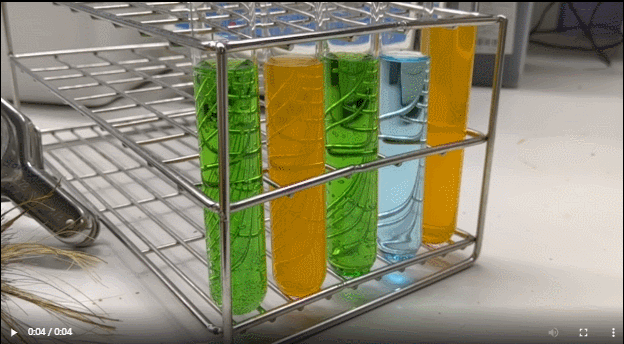
该模型在多个正向和360°数据集上的表现优于最先进的模型,并且在具有严重的视线依赖性变化的场景上有较大的余地。
另一篇论文通过使用具有规范化(canonicalized)位置编码的Transformer序列来解决合成未见过的场景的泛化性问题。模型在一组场景上训练后就可以用来合成新场景的视图。
论文链接:https://arxiv.org/pdf/2207.10662.pdf
文中提出了一个不同的范式,不需要深度特征和类似NeRF的体积渲染,该方法只需从场景中取样patch集合就能直接预测新场景中目标射线的颜色。
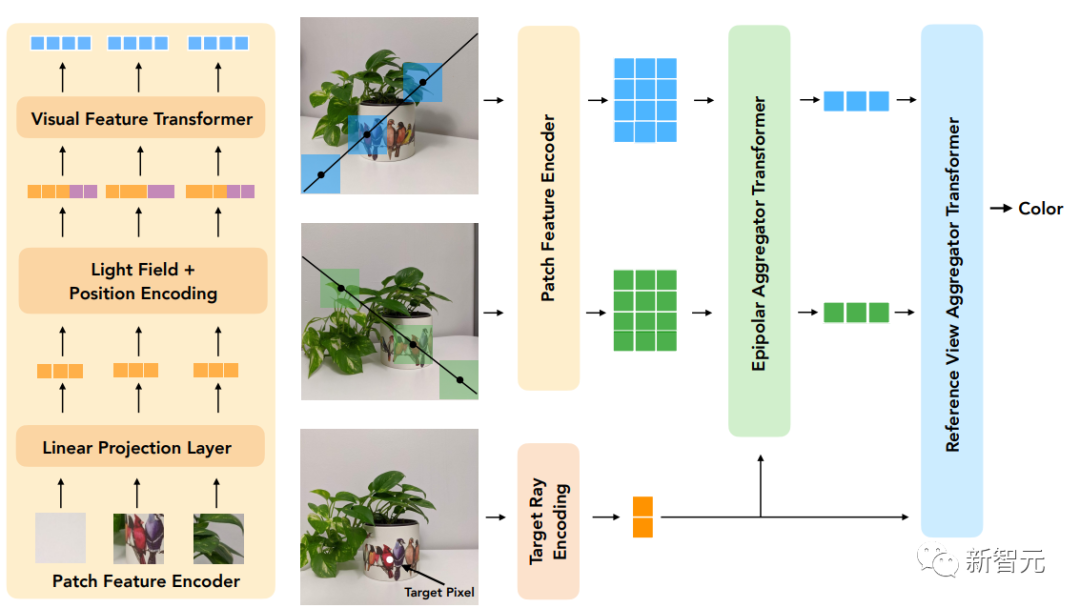
首先利用对极几何学,沿着每个参考视图的对极线提取patch,并将每个patch都线性地投射到一个一维特征向量中,然后由一系列的Transformer处理这个集合。
对于位置编码,研究人员采用和光场表示方法类似的方式对射线进行参数化,区别在于坐标是相对于目标射线的规范化,也使得该方法独立于参考框架并提高了通用性。
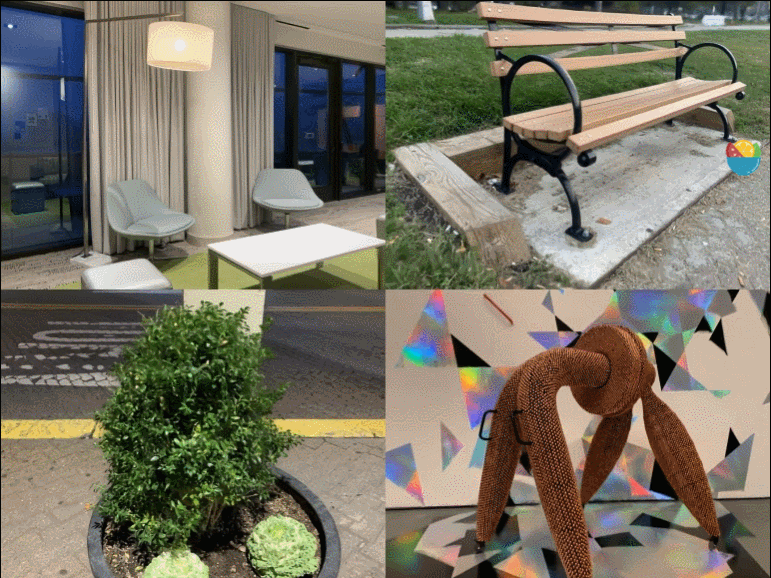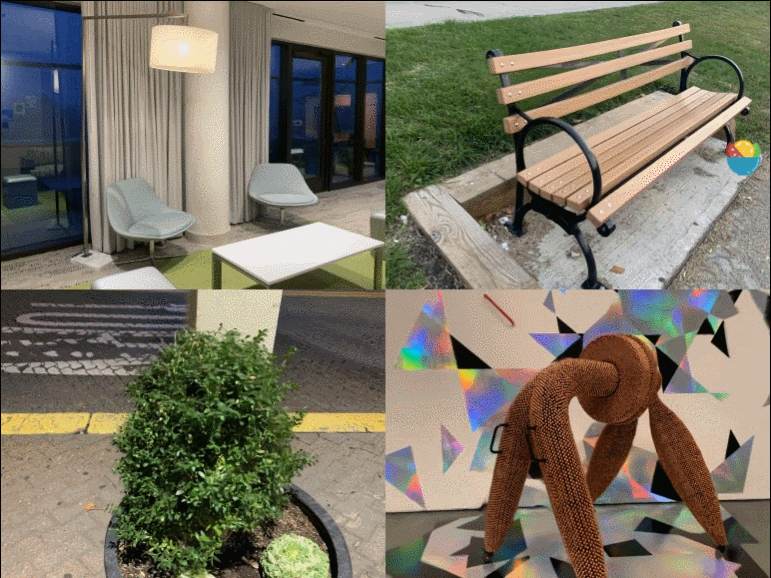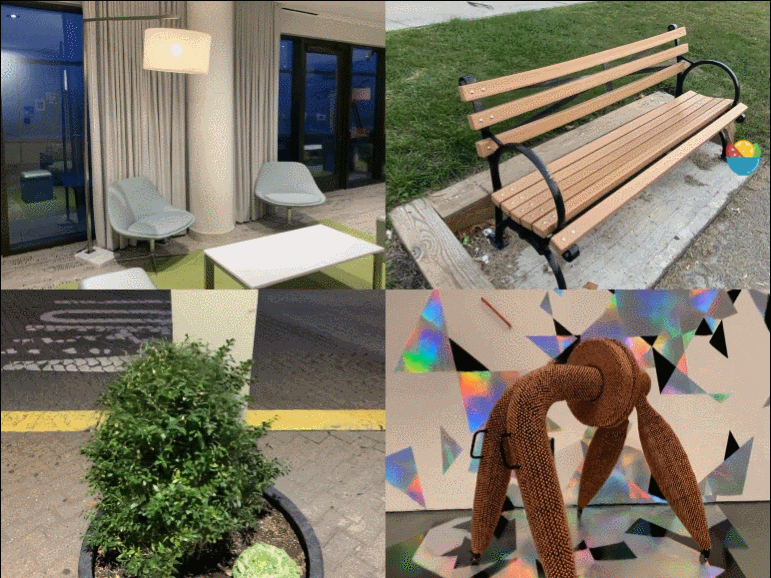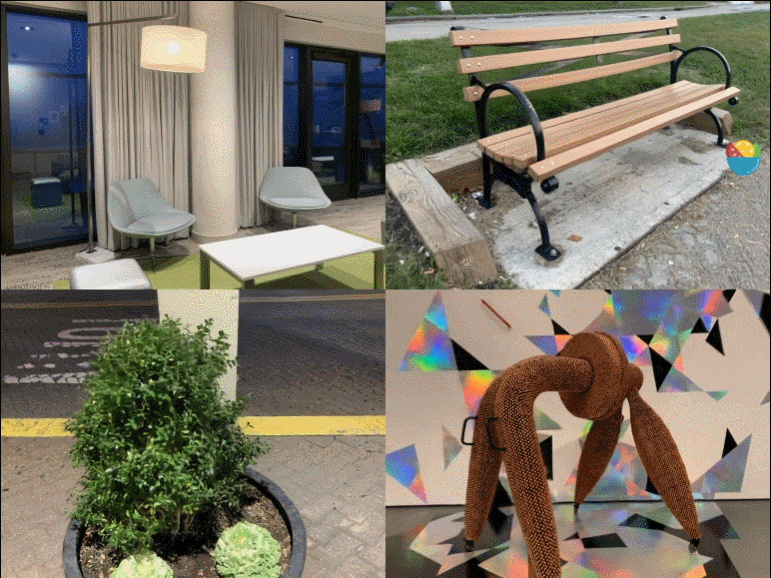
模型的创新点在于,它是进行基于图像的渲染,结合参考图像的颜色和特征来渲染新的视图,而且纯粹是基于Transformer的,在图像patch集上操作。并且它们利用4D光场表示来进行位置编码,有助于模拟与视图相关的效果。
最后实验结果表明,该方法在未见过的场景的新视图合成方面优于其他方法,即使在用比少得多的数据进行训练时也是如此。
光场神经渲染
光场神经渲染
模型的输入包括一组参考图像、相应的相机参数(焦距、位置和空间方向),以及用户想要确定其颜色的目标射线的坐标。
为了生成一个新的图像,我们需要从输入图像的相机参数开始,先获得目标射线的坐标(每一个都对应一个像素),并为每一个坐标进行模型查询。
研究人员的解决方法是,不完全处理每张参考图像,而只看可能影响目标像素的区域。这些区域可以通过对极几何学确定,将每个目标像素映射到每个参考框架上的一条线。
为了稳妥起见,需要在对极线上的一些点周围选取小区域,从而形成将被模型实际处理的patch集合,然后将Transformer作用于这组patch上以获得目标像素的颜色。
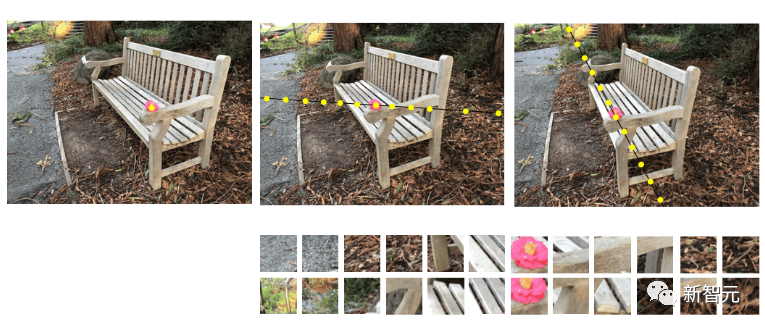
Transformer在这种情况下特别有用,因为其中的自注意力机制可以自然地将patch集合作为输入,注意力权重本身就可以用来结合参考视图颜色和特征来预测输出像素的颜色。
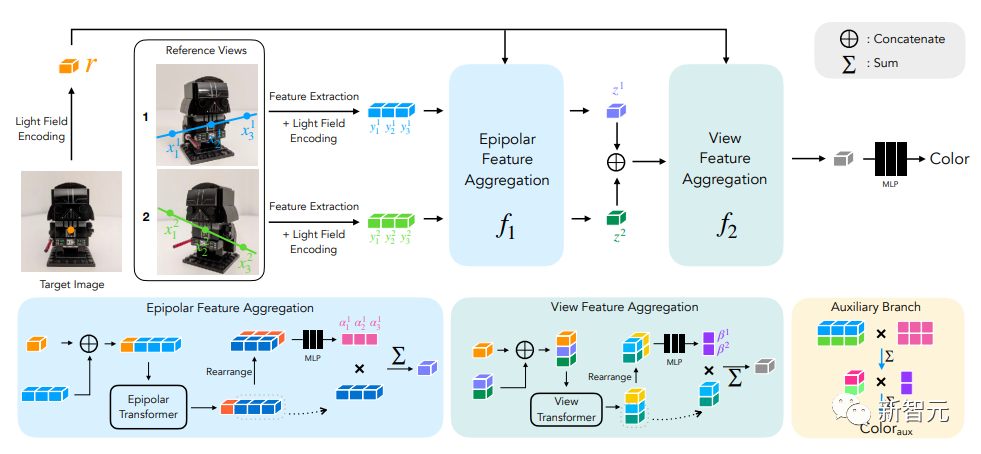
在光场神经渲染(LFNR)中,研究人员使用两个Transformer序列将patch集合映射到目标像素颜色。
第一个Transformer沿着每条对极线聚合信息,第二个Transformer沿着每张参考图像聚合信息。
这种方法可以把第一个Transformer解释为在每个参考帧上寻找目标像素的潜在对应关系,而第二个Transformer则是对遮挡和视线依赖效应的推理,这也是基于图像的渲染的常见难题。
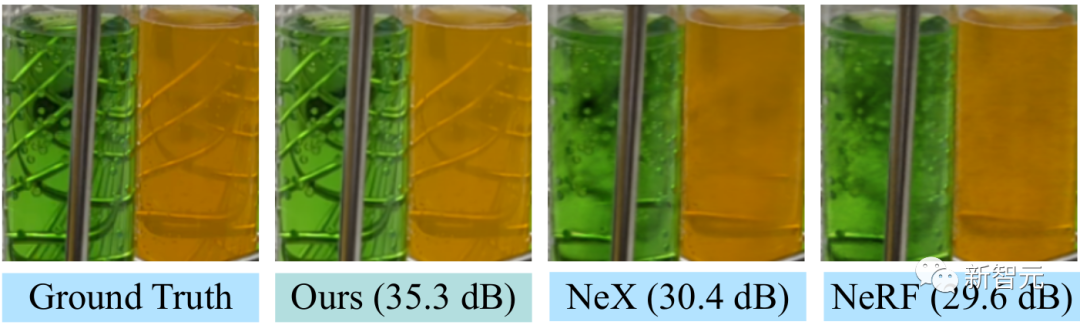
LFNR在最流行的视图合成基准(NeRF的Blender和Real Forward-Facing场景以及NeX的Shiny)上相比sota模型在峰值信噪比(PSNR)的提升幅度高达5dB,相当于将像素级的误差减少了1.8倍。
LFNR可以重现一些NeX/Shiny数据集中比较难的视线依赖性效果,比如CD上的彩虹和反射,瓶子上的反射、折射和半透明。
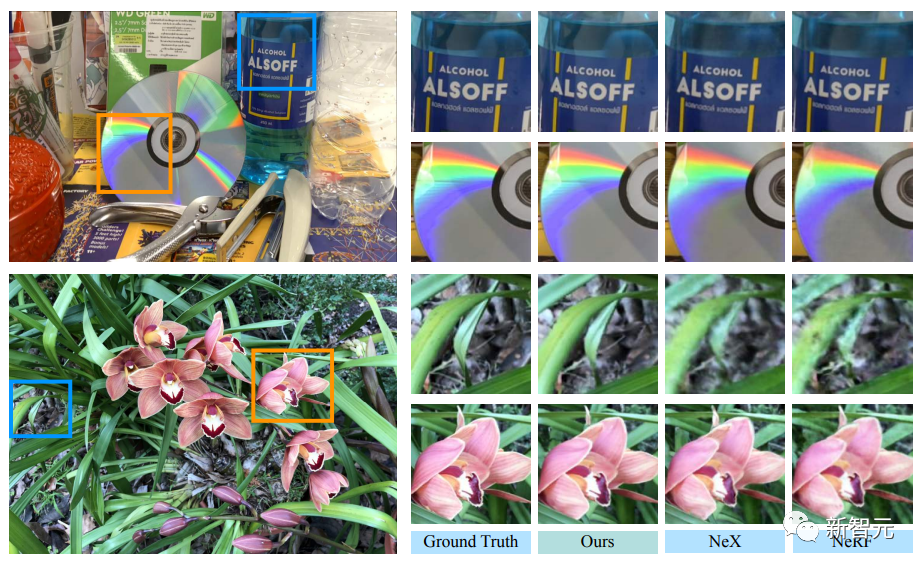
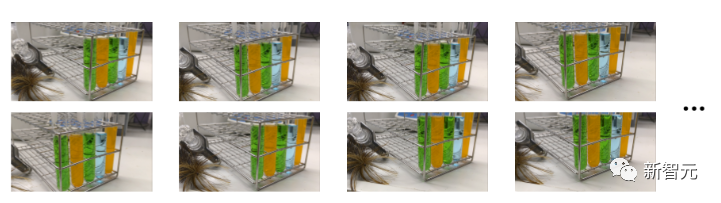
与之前的方法如NeX和NeRF相比,它们就没办法重现与视线相关的效果,如NeX/Shiny数据集中的实验室场景中的试管的半透明性和折射率。
一次训练,泛化新场景
但LFNR也有局限性。
第一个Transformer对每个参考图像独立地沿每条对极线折叠信息,这也意味着模型只能根据每个参考图像的输出射线坐标和patch来决定要保留哪些信息,这在单一场景的训练中效果很好(和大多数神经渲染方法一样),但它无法泛化到不同场景中。
可通用的模型很重要,因为可以直接应用于新的场景而不需要重新训练。
研究人员提出可通用的基于patch的神经渲染(GPNR)模型解决了LFNR的这个缺陷。
通过在模型中增加一个Transfomre,使其在其他两个Transformer之前运行,并在所有参考图像的相同深度的点之间交换信息。
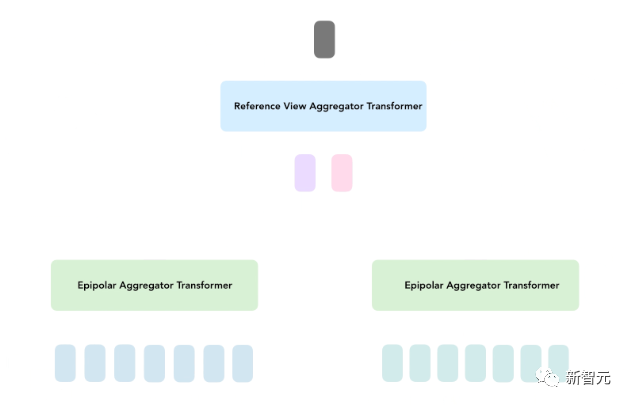
GPNR由三个Transformer序列组成,这些Transformer将沿对极线提取的一组patch映射为像素颜色。图像patch通过线性投影层被映射到初始特征,然后这些特征被模型连续细化和聚合,最终形成特征和颜色。
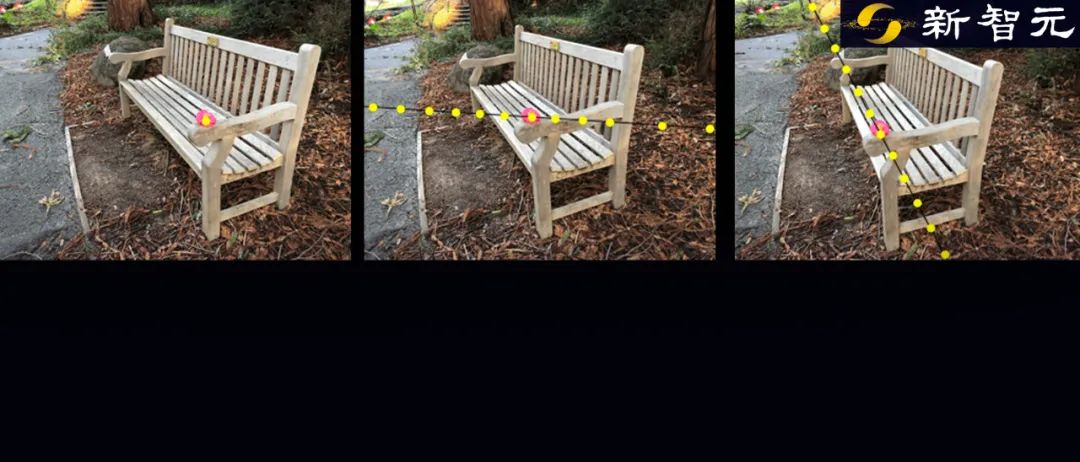
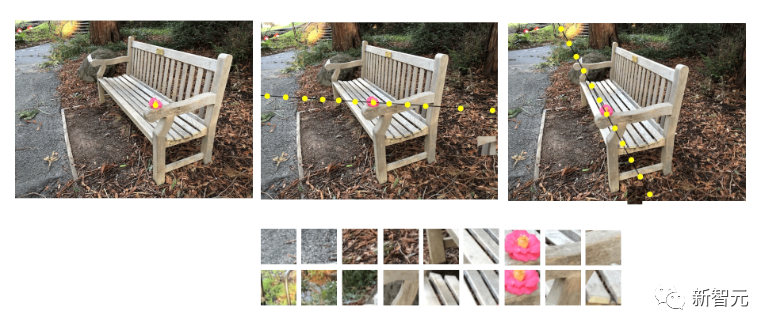
举个例子,第一个Transformer从「公园长椅」上提取出patch序列后,新模型可以使用在两个视图中出现在相应深度的「花」这样的线索,表明存在潜在的匹配。
这项工作的另一个关键idea就是根据目标射线将位置编码规范化,因为想要在不同的场景中进行泛化,就必须以相对而非绝对的参照系来表示quantities
为了评估模型的泛化性能,研究人员在一组场景上训练GPNR,并在新场景上进行测试。
GPNR在几个基准(遵照IBRNet和MVSNeRF协议)上平均提高了0.5-1.0 dB,尤其是在IBRNet基准上,GPNR 在只使用11%的训练场景的情况下,就超过了基线模型。
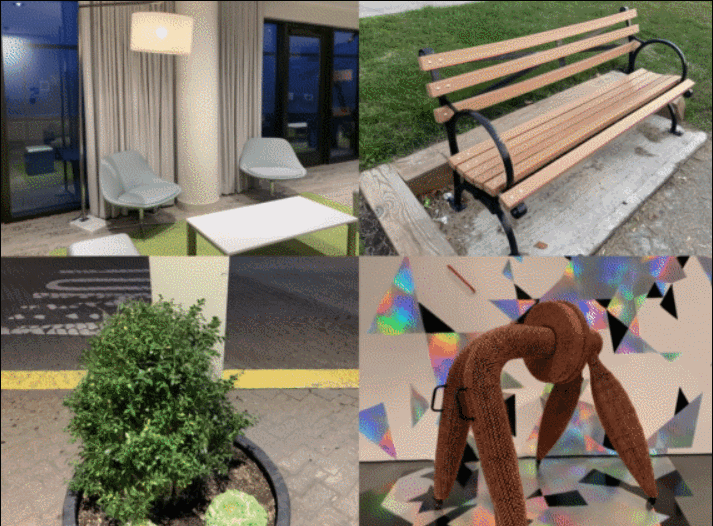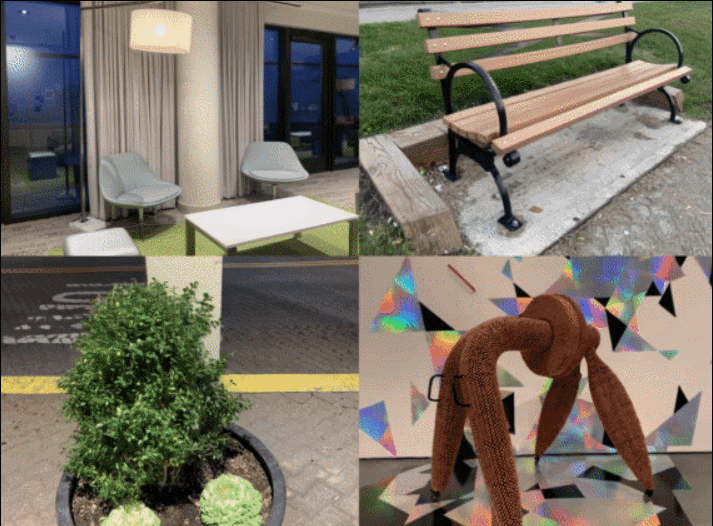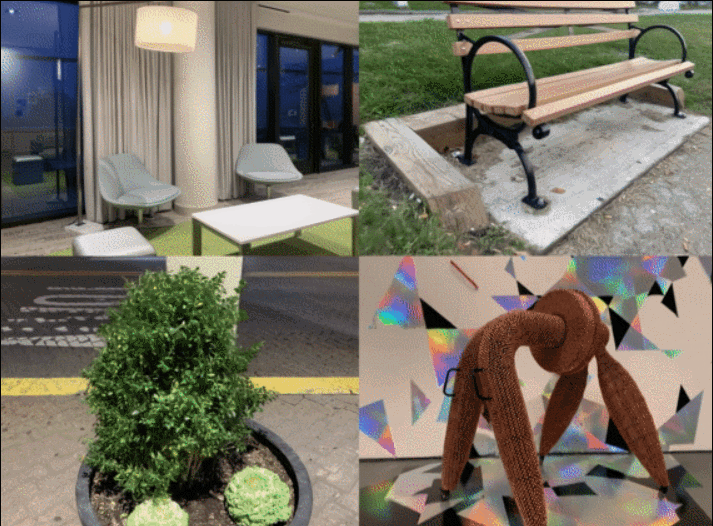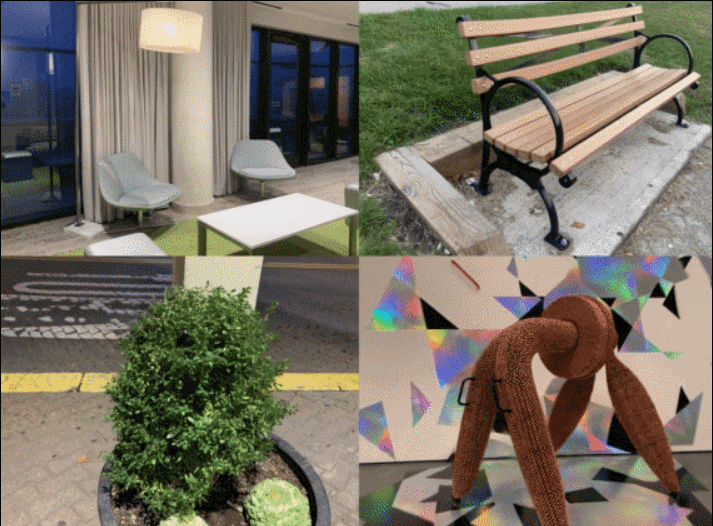
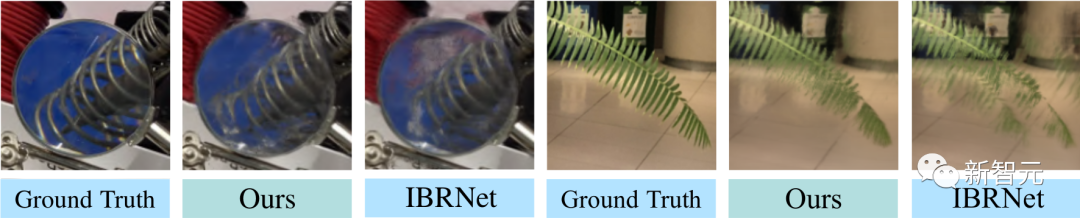
GPNR在NeX/Shiny和LLFF的保持场景上生成的视图细节,没有进行任何微调。与IBRNet相比,GPNR可以更准确地再现叶片上的细节和通过镜头的折射。
-
阅读原文
* 文章为作者独立观点,不代表数艺网立场转载须知
- 本内容由数艺网主动采集收录,信息来源为 “新智元” 公开网络发布内容。第三方如需转载本内容,必须完整标注原作者信息及 “来源:数艺网”,严禁擅自篡改、删减或未标注来源转载。 并附上本页链接: 若您的内容不希望被数艺网收录,或认为此举侵犯了您的合法权益,敬请通过微信 ID:d-arts-cn 联系数艺网。我们将致以诚挚歉意,并第一时间为您办理下架或删除处理。
-
-
北京
甲方 · 媒体平台
未认证的机构号
最近发布
-
2025-08-13
-
2025-07-18