- 0
- 0
- 0
分享
- 用人工智能解释大脑,一个虚假故事的开端?
-
2022-06-20
本文来源于:神经现实,作者:Bahar Gholipour
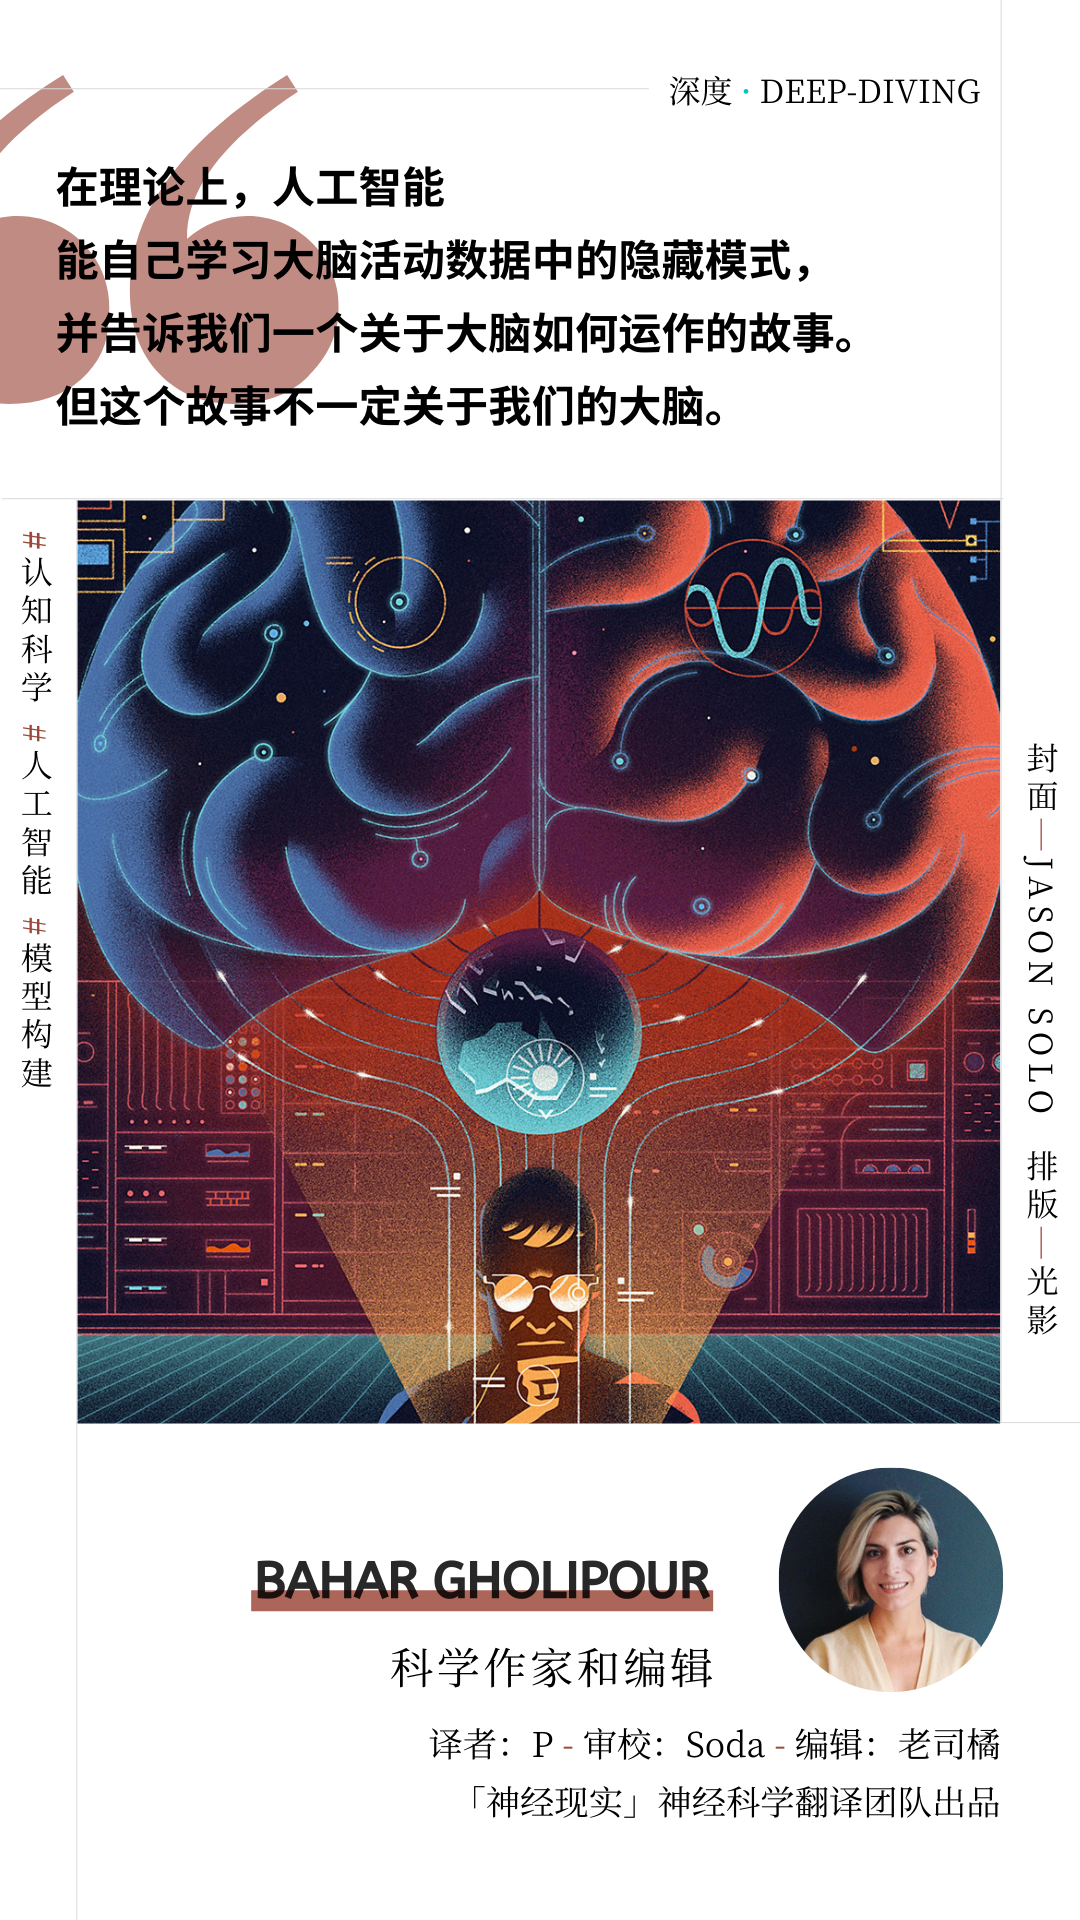
人们通常将大脑比作一个黑箱,但任何曾窥见其内在的神经科学家都知道,这仍旧只是一个轻描淡写的说法。技术进步正使我们越来越能够接近神经环路,现在,我们有条件仔细观察几乎任何数量的神经元的活动。然而,大脑的神秘只随之愈深。如同交响乐般的神经元同步发放,其蕴含的意义是什么?神经活动如何将光和声波转化为我们对视觉和听觉的主观体验?神经元进行什么样的计算,它们所遵循的广泛原则又是什么?大脑并不是一个黑箱——它是一个陌生世界,那里的语言和局部法则尚未被破解,而直观则已然消亡。
人工智能可以为我们解决这个问题吗?也许吧。但最近的一个认识是,即使是我们在人工智能技术方面已经取得巨大成功的最新、最强大的工具,在被用于解码大脑时也是举步维艰。诚然,机器学习算法,如人工神经网络,已经为我们解决了许多复杂的任务。它们可以预测天气和股市,或者识别物体和人脸。而更重要的是,它们不需要我们告知规则就能做到。至少在理论上,它们应该能够自己学习大脑活动数据中的隐藏模式,并告诉我们一个关于大脑如何运作的故事。事实上,它们的确讲出了一个故事。只不过,正如一些科学家所发现的那样,这个故事不一定是关于我们的大脑。
这就是冷泉港实验室(Cold Spring Harbor Laboratory)助理教授塔提亚娜·恩格尔(Tatiana Engel)最近在研究大脑决策时发现的。作为一名物理学家出身的计算神经科学家,恩格尔致力于开发能够帮助解释我们做决策时的神经元活动的数学模型。虽然神经科学家们已经提出了一些理论,但他们还没有就决策——即便是最简单的那些——是如何在大脑中实现的达成共识。带着探索更广泛的可能性,恩格尔转向了机器学习:她不再从具体的假设出发建立神经活动的模型,而是从灵活的、可以根据数据自我塑造并自行找出自身参数的模型出发。
在这种方法中,评估机器学习产生的模型的标准是它们在多大程度上能预测一组训练时没有见过的新的大脑测量结果。但在这一过程中,恩格尔想知道,我们到底有多确信这一最优模型反映了大脑的内在逻辑?
“现在,在神经科学以及其他领域,使用这种灵活模型作为了解真正的物理、生物系统的工具的现象越来越普遍了。”恩格尔说,“像这样,我们建立一个模型,然后发现它可以很好地预测来自某个系统的数据。接着我们就会做出这样一种假设,即这样一个模型应该是以类似于真实系统的方式运作,因此,通过研究模型如何运作,我们就将理解系统如何运作。”
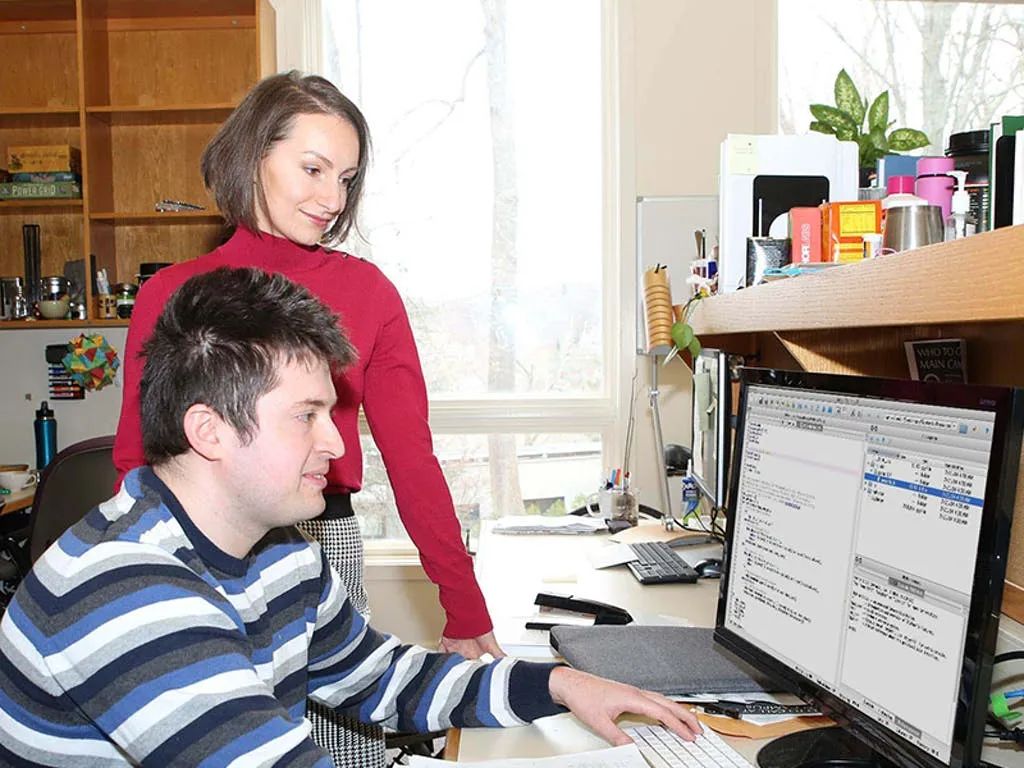
团队合作:一位物理学出身的计算神经科学家,塔提亚娜·恩格尔,与同事米哈伊尔·根金的合照。他们正在开发数学模型以理解神经元如何协作,最后达成我们的大脑每天每分钟都会做的决策。
—
冷泉港实验室
然而,更多时候,这一假设可能是没有根据的。在2020年的一项研究中,恩格尔和她的同事,冷泉港实验室的一名博士后,米哈伊尔·根金(Mikhail Genkin)检查了灵活模型在人工合成的数据上的效果,这些数据的内部动态是研究人员已知的[1]。他们发现,反直觉地是,有时最优模型反而离反映产生数据的原始系统的核心特征最远。“它们(模型)可能具有系统中根本不存在的特征或属性。”恩格尔表示,“一个模型可以对数据进行良好的预测,同时依旧是错误的。”换句话说,预测能力——机器学习算法的黄金标准——在被应用到神经科学时可能是一个误导性的指标。
如果没有有效的计算模型,科学家们可能很难有机会理解海量的大脑数据,并解释大脑的功能如何由神经活动产生。使用人工智能帮助大脑建模的前景正备受吹捧,而恩格尔和其他研究人员的发现可能会让人觉得是在泼冷水。然而,这些问题并不是无法克服的,恩格尔说。她和其他人已经在想办法避开这些陷阱。他们正在开发一些方法,这些方法将使他们能够继续使用人工智能的强大工具,而不会对误导性的叙事信以为真。
在计算层面描述神经元行为的尝试最后总是带来让人不得不谦卑的教训,即使是那些成功的尝试。1952年,阿兰·霍奇金(Alan Hodgkin)和安德鲁·赫胥黎(Andrew Huxley)把神经元想象成一个电路,其中被仔细排布的电阻和电容可以产生类似于神经元特征性的峰电位(spike)的电流,而峰电位是大脑中通讯的基本要素。这一模型被证明是一项里程碑式的成就,但要理解其重要性却远不是看着方程式就能直接知道的。当赫胥黎花了好几天时间费力地将电压数字输入一个机械计算器,观察电路的输出是否与真正的神经元相匹配时,他对这个简单模型的复杂行为深感惊叹。“很多时候,我的期望都是错误的。”他在十年后的诺贝尔奖演讲中回忆说,“我从这些手工计算中得到的一个重要教训是,在试图研究这种复杂程度的系统时,一个人的直觉是完全不够的。"
神经科学家们现在面临着更高数量级的复杂性,因为他们已经转向研究活体动物和人身上的神经元群体。即使只是来自于100个神经元的数据,也大得让人眼花缭乱。它的变化是动态的,没有明显的韵律和缘由。而且,人们很少清楚其中哪些部分与正在被研究的大脑功能真正相关。这些因素使得我们更难提出概念或者数学模型来描述神经活动。
更难的是要弄清楚哪一个被提出的模型能解释关于神经元的一些真实情况,而哪一个模型又只是幸运地正好在数学上和数据匹配。在不知道大脑的基本规则的情况下,科学家们能做的,最多就是看看这些模型相互之间比较起来会是怎样的。
“这就像我们看到的只有一辆移动的汽车,而我们必须通过对引擎盖下发生的事情做出假设来探明它是如何移动的。”与恩格尔合作研究决策的波士顿大学神经科学家钱德拉莫里·钱德拉塞卡兰(Chandramouli Chandrasekaran)说,“然后我们试图找出,所提出的想法——例如模型A和模型B——中到底是哪一个在匹配我们对汽车运动的测量,让它做得更好。”
钱德拉塞卡兰说,尽管这是一种越来越流行的方法,但这种方法仍然可能在重要方面失败。作为一个在工作中直接接触大脑测量的、同时做计算和实验的研究人员,钱德拉塞卡兰亲身体会到,神经活动完全不像一辆平稳行驶的汽车——它理所当然地太复杂了,以至于不可能正好被我们只是粗略勾勒的模型所描绘得完全相符。“实验数据通常要复杂并且异质得多。这就是它(神经活动)的本质。它不像你认为的那样简单和漂亮。”他说。钱德拉塞卡兰已经在一篇文章[2]中说明,这在实践中意味着,神经活动的细微变化有时会导致它被归类为模型A,而实际上它遵守的是模型B,反之亦然。这就是为什么对两个模型进行正面的直接比较并不能保证确定模型正确性的原因之一。
最近在决策领域爆发的一场激烈争论突出了这些困难。一切始于2015年发表于《科学》期刊的一篇论文中的争议性发现。该论文比较了两个模拟大脑如何做出决定的模型,特别是知觉决策(perceptual decisions)[3]。知觉决策涉及大脑对其收到的感觉信息做出判断:它是红色还是绿色?它是在向右还是向左移动?这个决定很简单,但如果你正好被交警拦下,它就可能会带来严重的后果。为了研究大脑如何做出这些决定,研究人员几十年来一直在记录动物体内神经元群的活动。当神经元的发放率被绘制出来并对多次试验取平均时,它呈现出一种逐渐升高的信号,以“上升”到一个决定。
自20世纪90年代以来,基于一个有影响力的模型的标准叙事,这一“上升”反映了神经元对证据的逐渐积累。换句话说,这就是神经元发出决策信号的方式:它们在收集支持一种或者另一种选择的证据时,会增大自身的发放率,直到积累下来的证据使它们的发放率达到阈值。然而,那份2015年的研究问道,“上升”是否是对多次试验进行平均造成的一个伪影(artifact):分析单一试验的混乱且有限的数据要难得多,但在一次试验中会发生什么?一个神经元的发放率是真的在持续上升还是在进行离散的跳跃?这一差异可能指向决策背后的不同策略。他们的分析表明,相比起“上升”模型,神经元的应答更符合跳跃模型。几年过去后的现在,经过许多研究,科学家们还是没有一个关于哪个模型是正确的确切结论。
而且情况还可能更糟:两个模型可能都不正确。“如果有一个C模型呢?或者D呢?”恩格尔说。如果取而代之的是,她可以测试一系列连续的模型呢?这就是灵活建模最有用的地方,它不会把她限制在少数几种情况下。但恩格尔发现,这种方法也可能选择出与本质上的物理现实没有多少共同之处的情景。首先,她必须找到一个解决这个问题的方法。
灵活模型在开发时考虑的是机器学习的目标:对预测能力进行优化。通过这种方式,它们可以把从一组数据中学到的东西,应用到它们以前没有见过的新数据上。例如,当建立一个分类器来区分猫和狗时,目标是在现实世界中它仍然可以区分猫和狗。其算法是否使用与我们大脑相同的策略来实现这一目标并不重要。事实上,在这种情况下,它肯定不是这样做的。
另一方面,神经科学家则有一个在根本上不同的目标:他们不想只是用一个模型拟合数据,而是想从数据中发现猜想。他们希望能够有一个模型能从神经活动中学到如何变得像神经元一样。恩格尔说:“我们不得不放弃这种为预测而优化模型的想法,并想出一种新的方法,将一个不同的目标提出来。”她和根金一起关注这样一个事实,即在不同的数据样本中,真实的特征总是相同的,但噪声是不同的。就这样,他们开发了一个新的程式,以允许在不同的数据样本上发现模型,并提取它们的共同特征。这种新方法识别了生成合成数据的正确模型。而当应用于真实的大脑数据时,它为每个样本得出了类似的模型,这表明与传统方法的胡乱猜测不同,这些模型已经捕获了系统的一些真实特征。
这一解决方案发表在《自然-机器智能》上[4],它将使得灵活模型在其最初的目标之上更具有扩展性,并对生物科学更有用处。这不一定能成为每一个用于神经科学的人工智能工具的解决方案,恩格尔说,但它可以改善灵活模型这一被神经科学家广泛使用的工具的实际应用。
对恩格尔本人来说,这一方法已经开始带来对决策的新见解。该团队正与钱德拉塞卡兰合作探索他们最初的问题:什么样的模型能最好地描述决策过程中的神经活动?到目前为止,他们所看到的既不是“上升”也不是“跳跃”。他们的发现会解决这个争论吗?抑或开启下一回合的争论?但愿我们很快就会知道。
参考文献
[1] Genkin, M. & Engel, T.A. Moving beyond generalization to accurate interpretation of flexible models. Nature Machine Intelligence 2, 674-683 (2020).
[2] Chandrasekaran, C., et al. Brittleness in model selection analysis of single neuron firing rates. BioRxiv (2018). Retrieved from DOI:10.1101/430710.
[3] Latimer, K.W., Yates, J.L., Meister, M.L.R., Huk, A.C., & Pillow, J.W. Single-trial spike trains in parietal cortex reveal discrete steps during decision-making. Science 349, 184-187 (2015).
[4] Genkin, Mikhail, and Tatiana A. Engel. "Moving beyond generalization to accurate interpretation of flexible models." Nature Machine Intelligence 2.11 (2020): 674-683.
作者:Bahar Gholipour | 翻译:P
校对:Soda |编辑:老司橘
封面:Jason Solo | 排版:光影
原文:
https://nautil.us/ai-is-helping-scientists-explain-the-brain-14073/
本文来自微信公众号“神经现实”,谢绝转载到其它平台。如需开设白名单,请在后台回复“转载”,查看转载规范。公众号改版,星标“神经现实”公众号,不错过任何一条消息。
-
阅读原文
* 文章为作者独立观点,不代表数艺网立场转载须知
- 本文由 “数艺网” 授权数艺网发布,已由本站编辑优化排版。 转载请务必在开头或结尾标注 “作者:XXX | 来源:数艺网”,尊重原创及授权权益。 并附上本页链接: 本站部分图文取自网络,如涉及侵权问题,欢迎通过微信 ID:d-arts-cn 告知。我们会立即核实并及时处理,感谢您的理解与监督。
-
-
苏州
甲方 · 媒体平台
未认证的机构号